Bulk PDF Text Extractor
文件夹里的每个 PDF,都变成可搜索的文本
完全离线批量将 PDF 文件转换为纯文本或 Markdown。多栏页面保持阅读顺序,表格以文本网格绘出。免费试用。
Full seller details: Legal information.
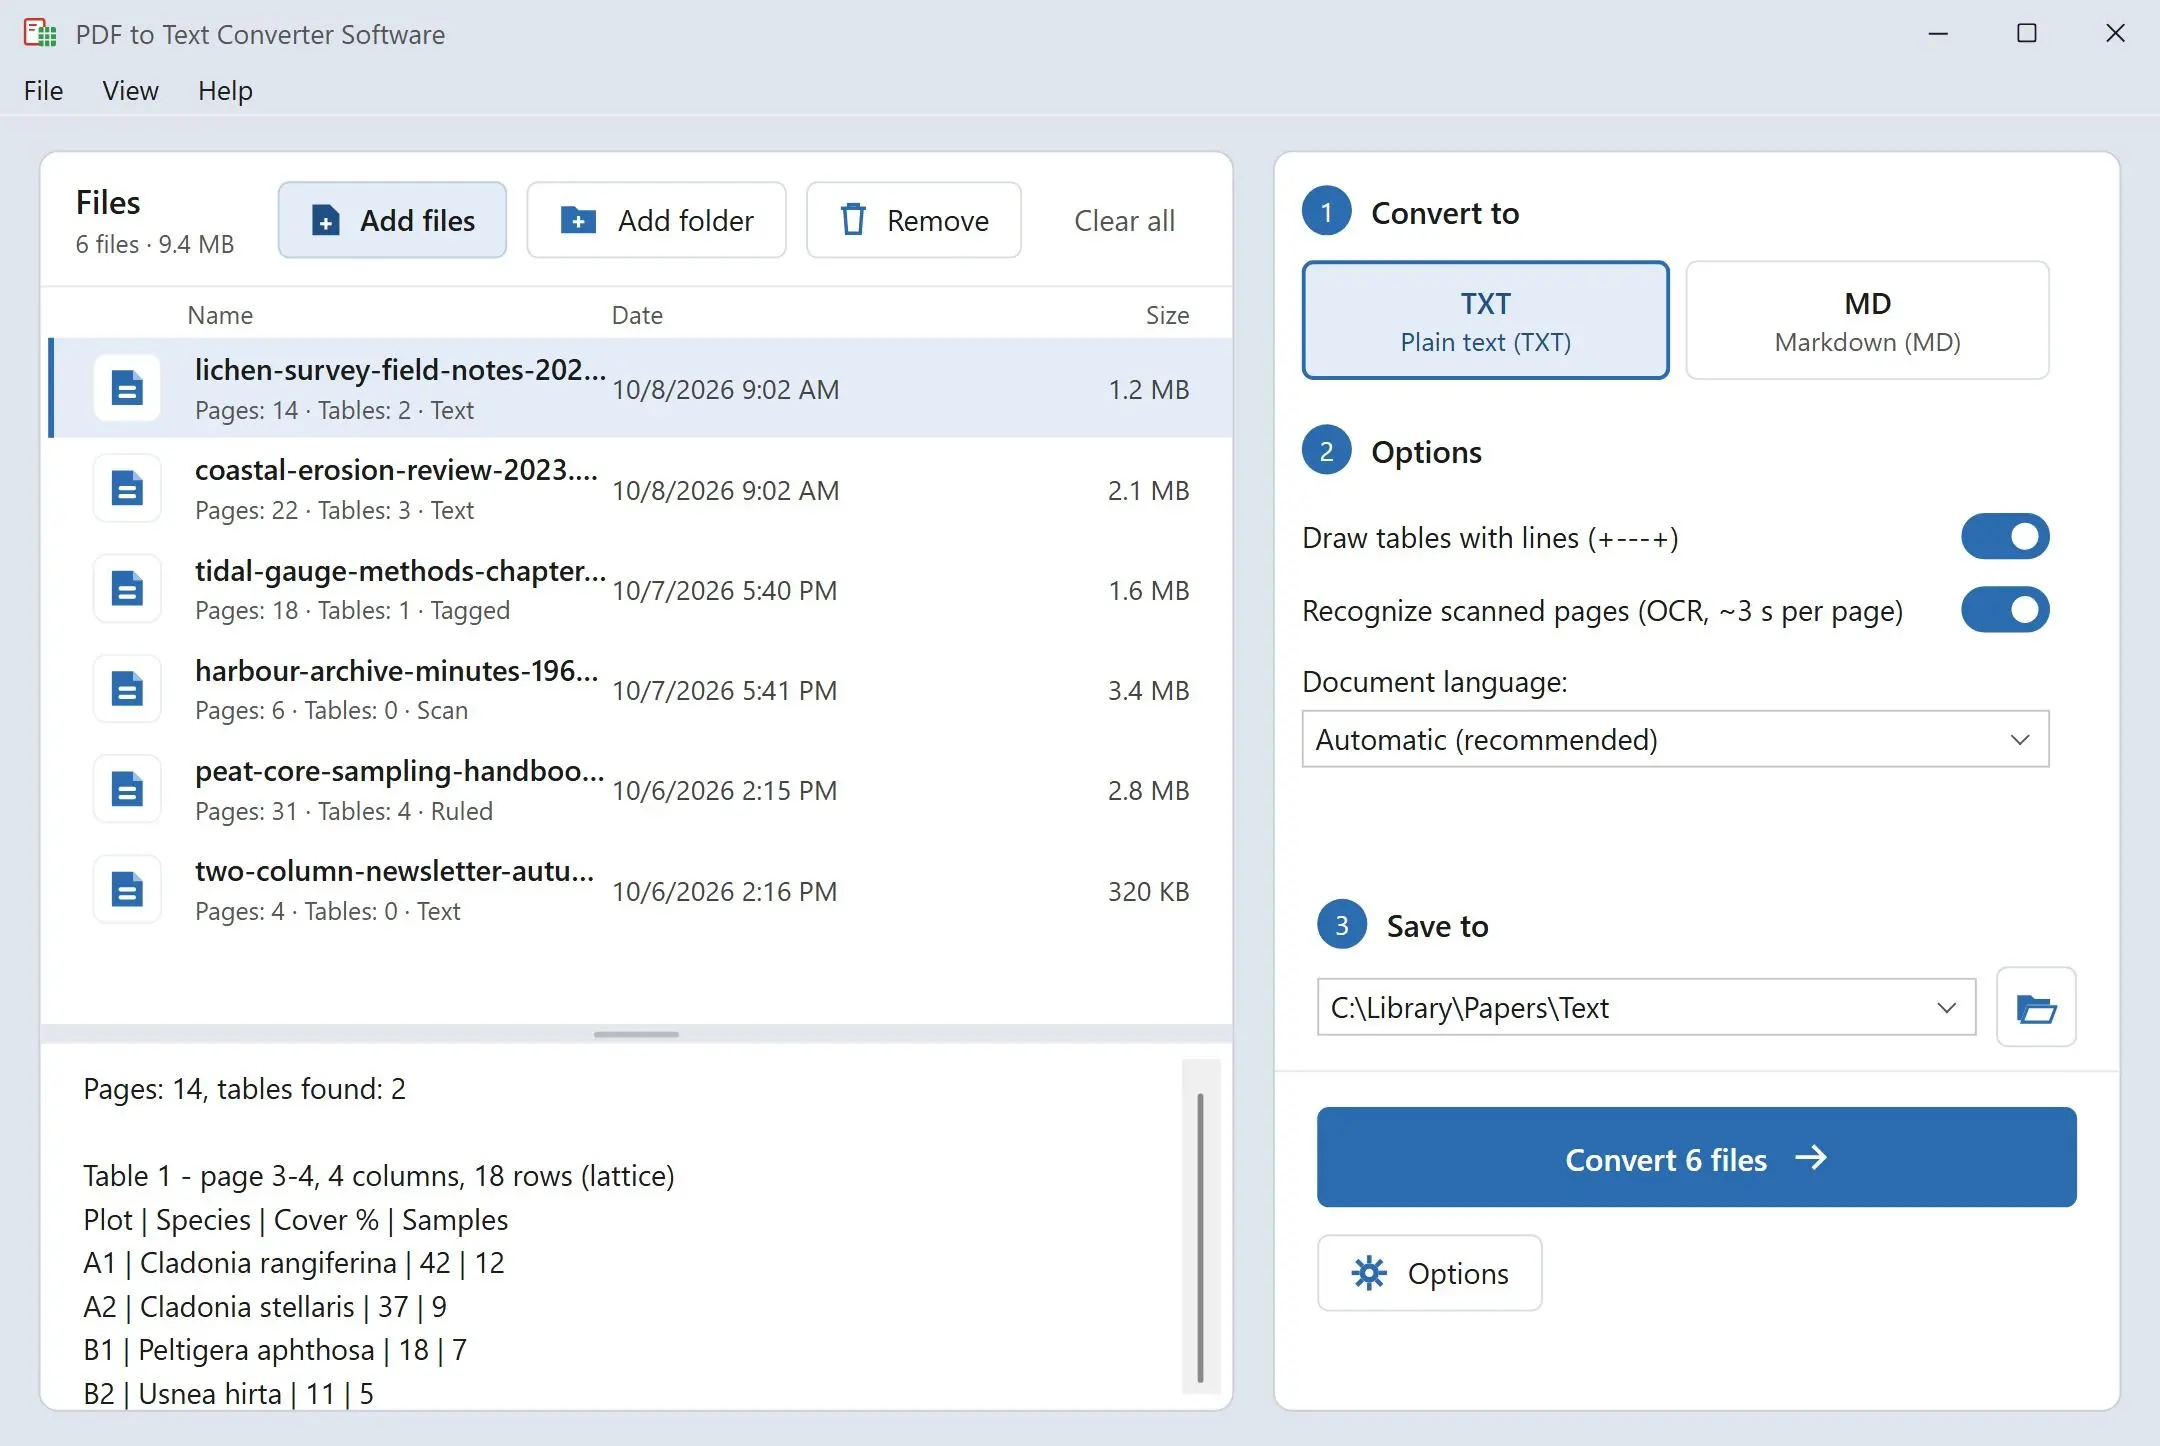
添加一个装有 PDF 的文件夹,就能在你自己的 Windows 电脑上为每个文件生成一个 .txt 或 .md 文件。分栏内容按你阅读的顺序输出,表格中的每个数字也都留在正确的表头之下。
把 PDF 里的文字取出来,不该花上一下午
在 PDF 阅读器里全选、粘贴到记事本,双栏的论文就变成句子在两栏之间来回跳的行,表格则塌成一串数字,什么也分不清。网站做得更好一些,但一次只能上传一个,而且会把你的文件在他们的服务器上留一阵子。本程序一次处理整个文件夹:在你的电脑上读取每个 PDF,写出可以阅读、搜索和引用的纯文本。
How to use it
添加文件或文件夹
把单个 PDF 或整个文件夹拖入列表。输出可以保存在每个原文件旁边,也可以保存到你选定的同一个文件夹。来自不同文件夹的两个同名文件会生成各自独立的输出,不会被意外覆盖。
选择纯文本或 Markdown
纯文本为 UTF-8 编码,使用 Windows 换行符,页与页之间有换页符。表格默认用 +---+ 线条框起;关闭后则改用空格对齐各列。Markdown 会把标题转成 # 标题,把表格转成竖线表格。
开始批处理并搜索结果
一次开始就处理整个列表。完成后,摘要会告诉你写出了多少个文件、保存在哪里。用 Windows 搜索、你的编辑器或 grep 指向该文件夹,就能一次性在所有文档中查找任意短语。
Benefits
人们为什么使用它
扫描页同样可以识别
只是一张纸的图片的页面,会在你的电脑上进行文字识别,速度大约每页 3 秒。支持拉丁字母和西里尔字母,需要 64 位 Windows。已有文字层的页面会原样读取,扫描件中的表格会按空格排成列,但不带网格。
适合笔记应用和 AI 助手
Markdown 输出无需整理,可以直接放进笔记应用、维基或与 AI 助手的对话中。从 # 到 ###### 的标题级别遵循文档中标题的字号,表格变成以第一行为表头的竖线表格。
多种语言的文本
带文字层的中文、日文或韩文 PDF 能输出可读的文本,希伯来文和阿拉伯文的行则保持从右到左的顺序。所有内容都保存为 UTF-8,因此文件在任何现代编辑器中都能正确打开。
常见问题解答
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note