Bulk PDF Text Extractor
Każdy PDF w folderze jako tekst, który można przeszukiwać
Konwertuj pliki PDF na zwykły tekst lub Markdown wsadowo, w pełni offline. Strony wielokolumnowe zachowują kolejność czytania, a tabele są rysowane jako siatki tekstowe. Bezpłatna wersja próbna.
Full seller details: Legal information.
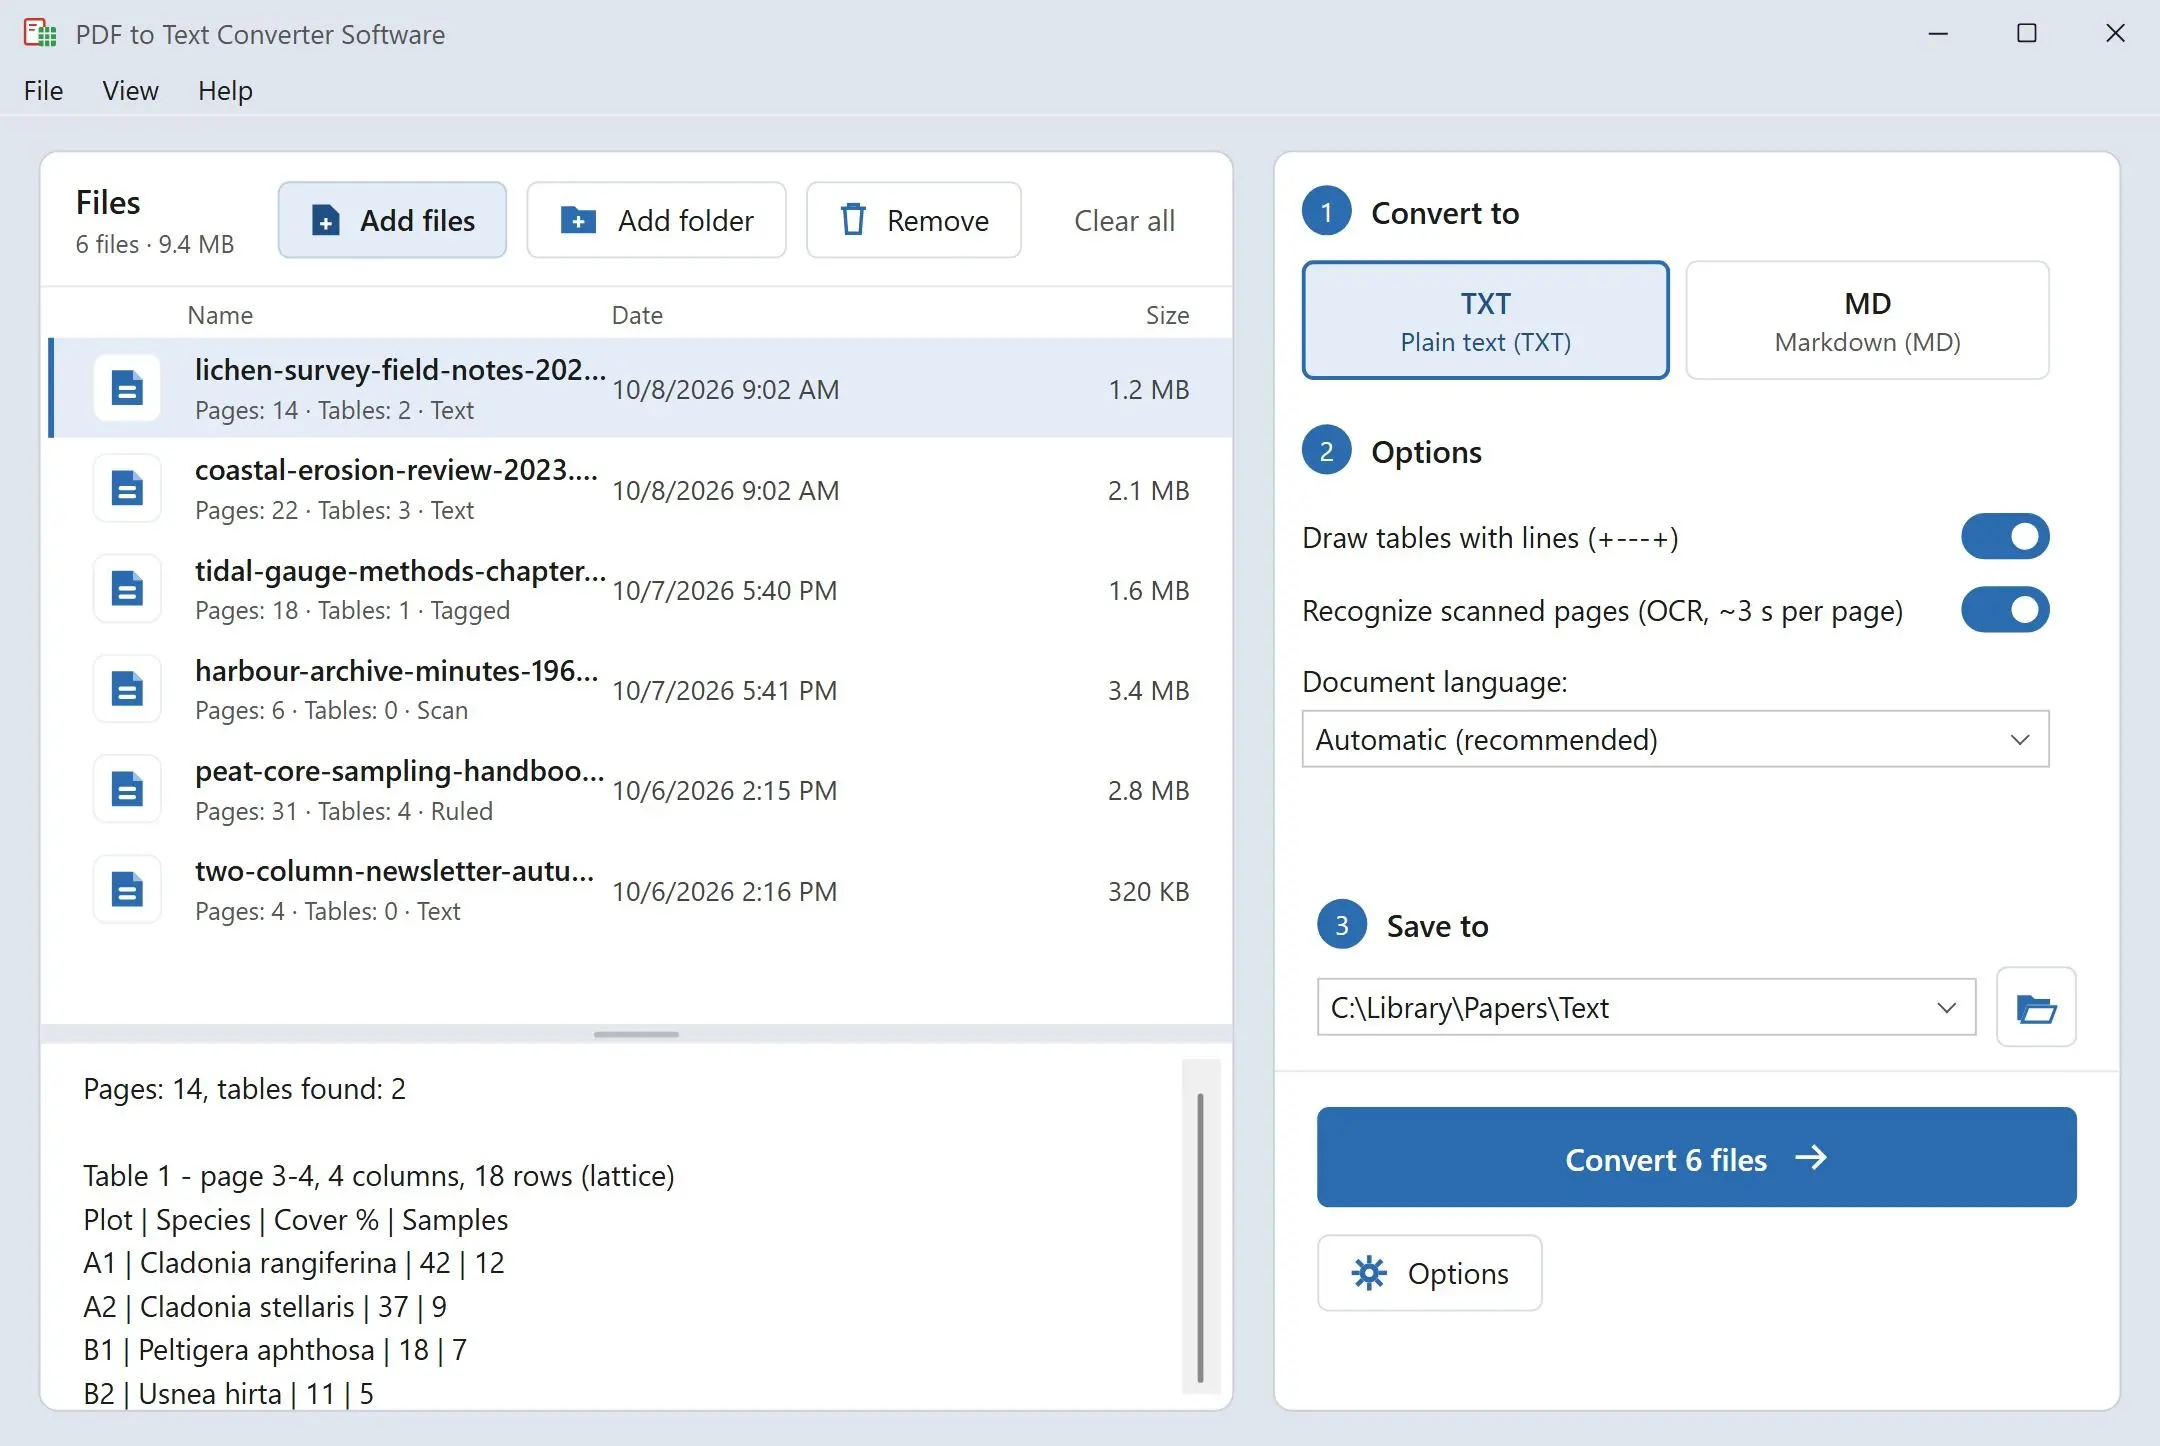
Dodaj folder z plikami PDF i dostań po jednym pliku .txt lub .md dla każdego, zapisanym na Twoim komputerze z Windows. Kolumny wychodzą w kolejności, w jakiej je czytasz, a tabele zachowują każdą liczbę pod właściwym nagłówkiem.
Wyciągnięcie słów z PDF nie powinno zajmować popołudnia
Zaznacz wszystko w przeglądarce PDF, wklej do Notatnika, a dwukolumnowa praca naukowa zmienia się w wiersze skaczące między kolumnami w środku zdania, tabela zaś zapada się w ciąg liczb, których nic nie odróżnia. Strony internetowe radzą sobie lepiej, ale po jednym pliku i na jakiś czas zatrzymują Twój plik na swoim serwerze. Ten program obsługuje cały folder za jednym razem: czyta każdy PDF na Twoim komputerze i zapisuje zwykły tekst, który możesz czytać, przeszukiwać i cytować.
How to use it
Dodaj pliki lub folder
Upuść pojedyncze pliki PDF lub cały folder na listę. Zapisz wynik obok każdego oryginału albo w jednym wybranym folderze. Dwa pliki o tej samej nazwie z różnych folderów dostają osobne wyniki, więc nic nie zostanie nadpisane przez przypadek.
Wybierz zwykły tekst lub Markdown
Zwykły tekst to UTF-8 z końcami wierszy Windows i znakiem form feed między stronami. Tabele są domyślnie obramowane wierszami +---+; wyłącz to, a kolumny zostaną wyrównane spacjami. Markdown zamienia tytuły na nagłówki # i tabele na tabele z kreską pionową.
Uruchom wsad i przeszukaj wyniki
Jeden start obejmuje całą listę. Po zakończeniu podsumowanie mówi, ile plików zapisano i gdzie. Skieruj wyszukiwarkę Windows, edytor lub grep na ten folder i wyszukaj dowolną frazę we wszystkich dokumentach naraz.
Benefits
Kolumny czytane tak, jak czyta człowiek
Na dwukolumnowej stronie czasopisma najpierw zapisywana jest cała lewa kolumna, potem cała prawa. Zdania pozostają w jednym kawałku, a tytuły sekcji są rozpoznawane po wielkości, więc nie trafiają w środek akapitu.
Tabele czytelne w Notatniku
Cennik lub wynik badania laboratoryjnego zachowuje siatkę: każda liczba pozostaje pod swoim nagłówkiem kolumny, obramowana zwykłymi znakami, które pokaże każdy edytor tekstu. Siatkę dostają tylko prawdziwe tabele, więc strona prozy złożona w dwóch kolumnach pozostaje prozą.
Nic nie opuszcza Twojego komputera
Silnik PDF działa z folderu programu na Twoim komputerze. Nie ma wgrywania, konta ani połączenia sieciowego, więc umowy, dokumentacja medyczna i nieopublikowane rękopisy zostają tam, gdzie są.
Dlaczego ludzie go używają
Zeskanowane strony też są rozpoznawane
Strona będąca tylko obrazem papieru przechodzi rozpoznawanie tekstu na Twoim komputerze, w tempie około 3 sekund na stronę. Obsługuje pisma łacińskie i cyrylicę i wymaga 64-bitowego Windows. Strony, które mają już warstwę tekstową, są brane takimi, jakie są, a tabele na skanie wychodzą rozdzielone spacjami na kolumny, bez siatki.
Gotowe pod aplikacje do notatek i asystentów AI
Wynik w formacie Markdown można wkleić prosto do aplikacji do notatek, wiki lub rozmowy z asystentem AI bez czyszczenia. Nagłówki od # do ###### odpowiadają wielkości tytułów w dokumencie, a tabele stają się tabelami z kreską pionową, z pierwszym wierszem jako nagłówkiem.
Tekst w wielu językach
Pliki PDF z warstwą tekstową po chińsku, japońsku lub koreańsku wychodzą jako czytelny tekst, a wiersze hebrajskie i arabskie zachowują kolejność od prawej do lewej. Wszystko jest zapisywane jako UTF-8, więc plik poprawnie otworzy się w każdym nowoczesnym edytorze.
FAQ
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note