Bulk PDF Text Extractor
폴더 안의 모든 PDF를, 검색할 수 있는 텍스트로
PDF 파일을 일반 텍스트 또는 Markdown으로 완전 오프라인에서 일괄 변환합니다. 다단 페이지는 읽는 순서를 유지하고, 표는 텍스트 격자로 그려집니다. 무료 체험판 제공.
Full seller details: Legal information.
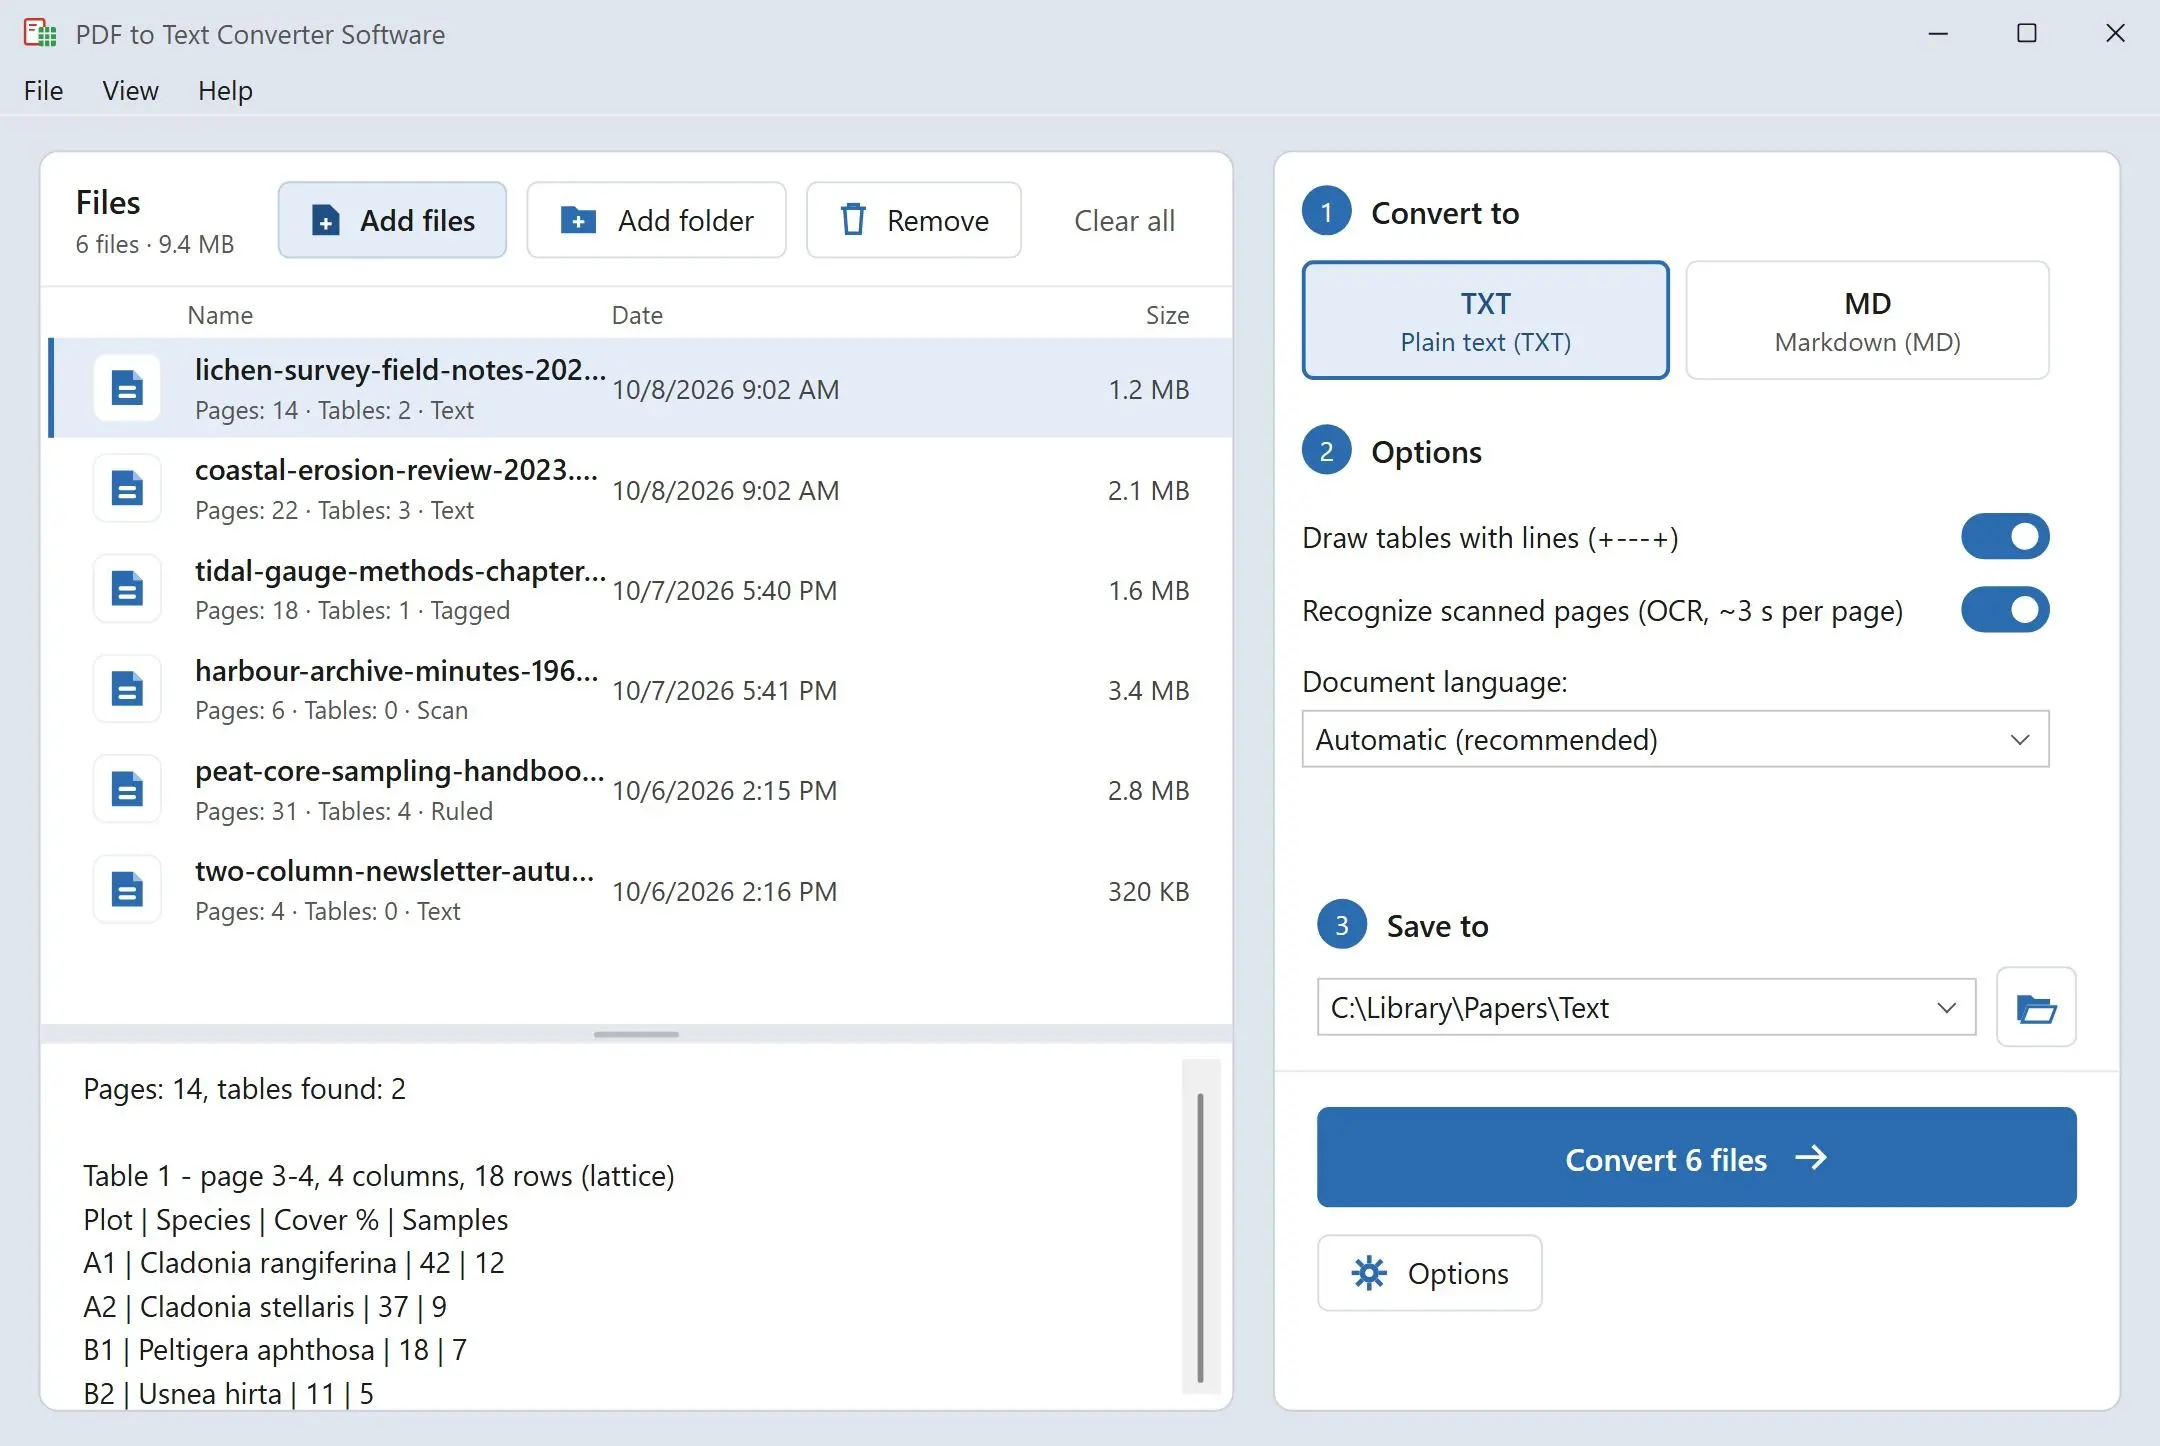
PDF 폴더를 추가하면 각각에 대해 .txt 또는 .md 파일이 하나씩 내 Windows PC에서 만들어집니다. 단은 읽는 순서대로 나오고, 표는 모든 수치가 올바른 머리글 아래에 유지됩니다.
PDF에서 글자를 꺼내는 데 오후 한나절을 쓸 이유가 없습니다
PDF 뷰어에서 전체를 선택해 메모장에 붙여 넣으면, 2단으로 된 논문은 문장 중간에서 단을 건너뛰는 줄이 되고, 표는 서로 구분되지 않는 숫자의 나열로 무너집니다. 웹사이트가 더 낫긴 하지만 한 번에 한 파일씩 업로드해야 하고, 파일이 한동안 그쪽 서버에 남습니다. 이 프로그램은 폴더 전체를 한 번에 처리합니다. 각 PDF를 내 컴퓨터에서 읽고, 읽고 검색하고 인용할 수 있는 일반 텍스트를 만들어 줍니다.
How to use it
파일이나 폴더 추가하기
PDF 하나씩 또는 폴더 전체를 목록에 끌어다 놓으세요. 출력은 각 원본 옆에 저장하거나 선택한 폴더 하나에 저장합니다. 서로 다른 폴더에 있는 같은 이름의 두 파일은 별도의 출력이 만들어지므로, 실수로 덮어쓰는 일이 없습니다.
일반 텍스트와 Markdown 중에서 선택
일반 텍스트는 Windows 줄 바꿈이 적용된 UTF-8이며 페이지 사이에 form feed가 들어갑니다. 표는 기본적으로 +---+ 선으로 둘러싸이며, 이를 끄면 대신 공백으로 열이 정렬됩니다. Markdown은 제목을 # 머리글로, 표를 파이프 표로 바꿉니다.
일괄 처리를 시작하고 결과 검색
시작 한 번으로 목록 전체가 처리됩니다. 끝나면 요약에 몇 개의 파일이 어디에 기록되었는지 표시됩니다. Windows 검색, 편집기 또는 grep을 그 폴더로 지정하면 모든 문서에서 원하는 문구를 한꺼번에 찾을 수 있습니다.
Benefits
단도 사람이 읽는 순서대로
2단으로 된 학술지 페이지에서는 왼쪽 단 전체가 먼저, 그다음 오른쪽 단 전체가 기록됩니다. 문장은 끊기지 않고 이어지며, 절 제목은 크기로 인식되어 문단 중간에 끼어들지 않습니다.
메모장에서도 읽히는 표
가격표나 검사 보고서는 격자를 유지합니다. 각 수치가 열 머리글 아래에 머물고, 어떤 텍스트 편집기에서도 표시되는 일반 문자로 둘러싸입니다. 격자는 진짜 표에만 붙기 때문에, 2단으로 조판된 산문 페이지는 산문 그대로 남습니다.
아무것도 PC 밖으로 나가지 않습니다
PDF 엔진은 내 컴퓨터의 프로그램 폴더에서 실행됩니다. 업로드도, 계정도, 네트워크 연결도 전혀 없으므로 계약서, 의료 기록, 미발표 원고는 있던 자리에 그대로 있습니다.
사람들이 사용하는 이유
스캔한 페이지도 인식
종이를 찍은 그림일 뿐인 페이지는 PC에서 텍스트 인식을 거치며, 페이지당 약 3초가 걸립니다. 라틴 문자와 키릴 문자를 지원하고 64비트 Windows가 필요합니다. 이미 텍스트 레이어가 있는 페이지는 그대로 가져오며, 스캔한 표는 격자 없이 공백으로 열을 맞춰 출력됩니다.
메모 앱과 AI 어시스턴트에 바로 사용
Markdown 출력은 정리 작업 없이 메모 앱, 위키, AI 어시스턴트와의 채팅에 바로 넣을 수 있습니다. #부터 ######까지의 머리글은 문서에 있는 제목의 크기를 따르고, 표는 첫 행을 머리글로 하는 파이프 표가 됩니다.
여러 언어의 텍스트
텍스트 레이어가 있는 중국어, 일본어, 한국어 PDF는 읽을 수 있는 텍스트로 출력되며, 히브리어와 아랍어 줄은 오른쪽에서 왼쪽으로의 순서를 유지합니다. 모두 UTF-8로 저장되므로 어떤 최신 편집기에서도 파일이 올바르게 열립니다.
자주 묻는 질문
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note