Bulk PDF Text Extractor
Varje PDF i mappen, som sökbar text
Konvertera PDF-filer till ren text eller Markdown i bulk, helt offline. Sidor med flera kolumner behåller läsordningen och tabeller ritas som textrutnät. Gratis provperiod.
Full seller details: Legal information.
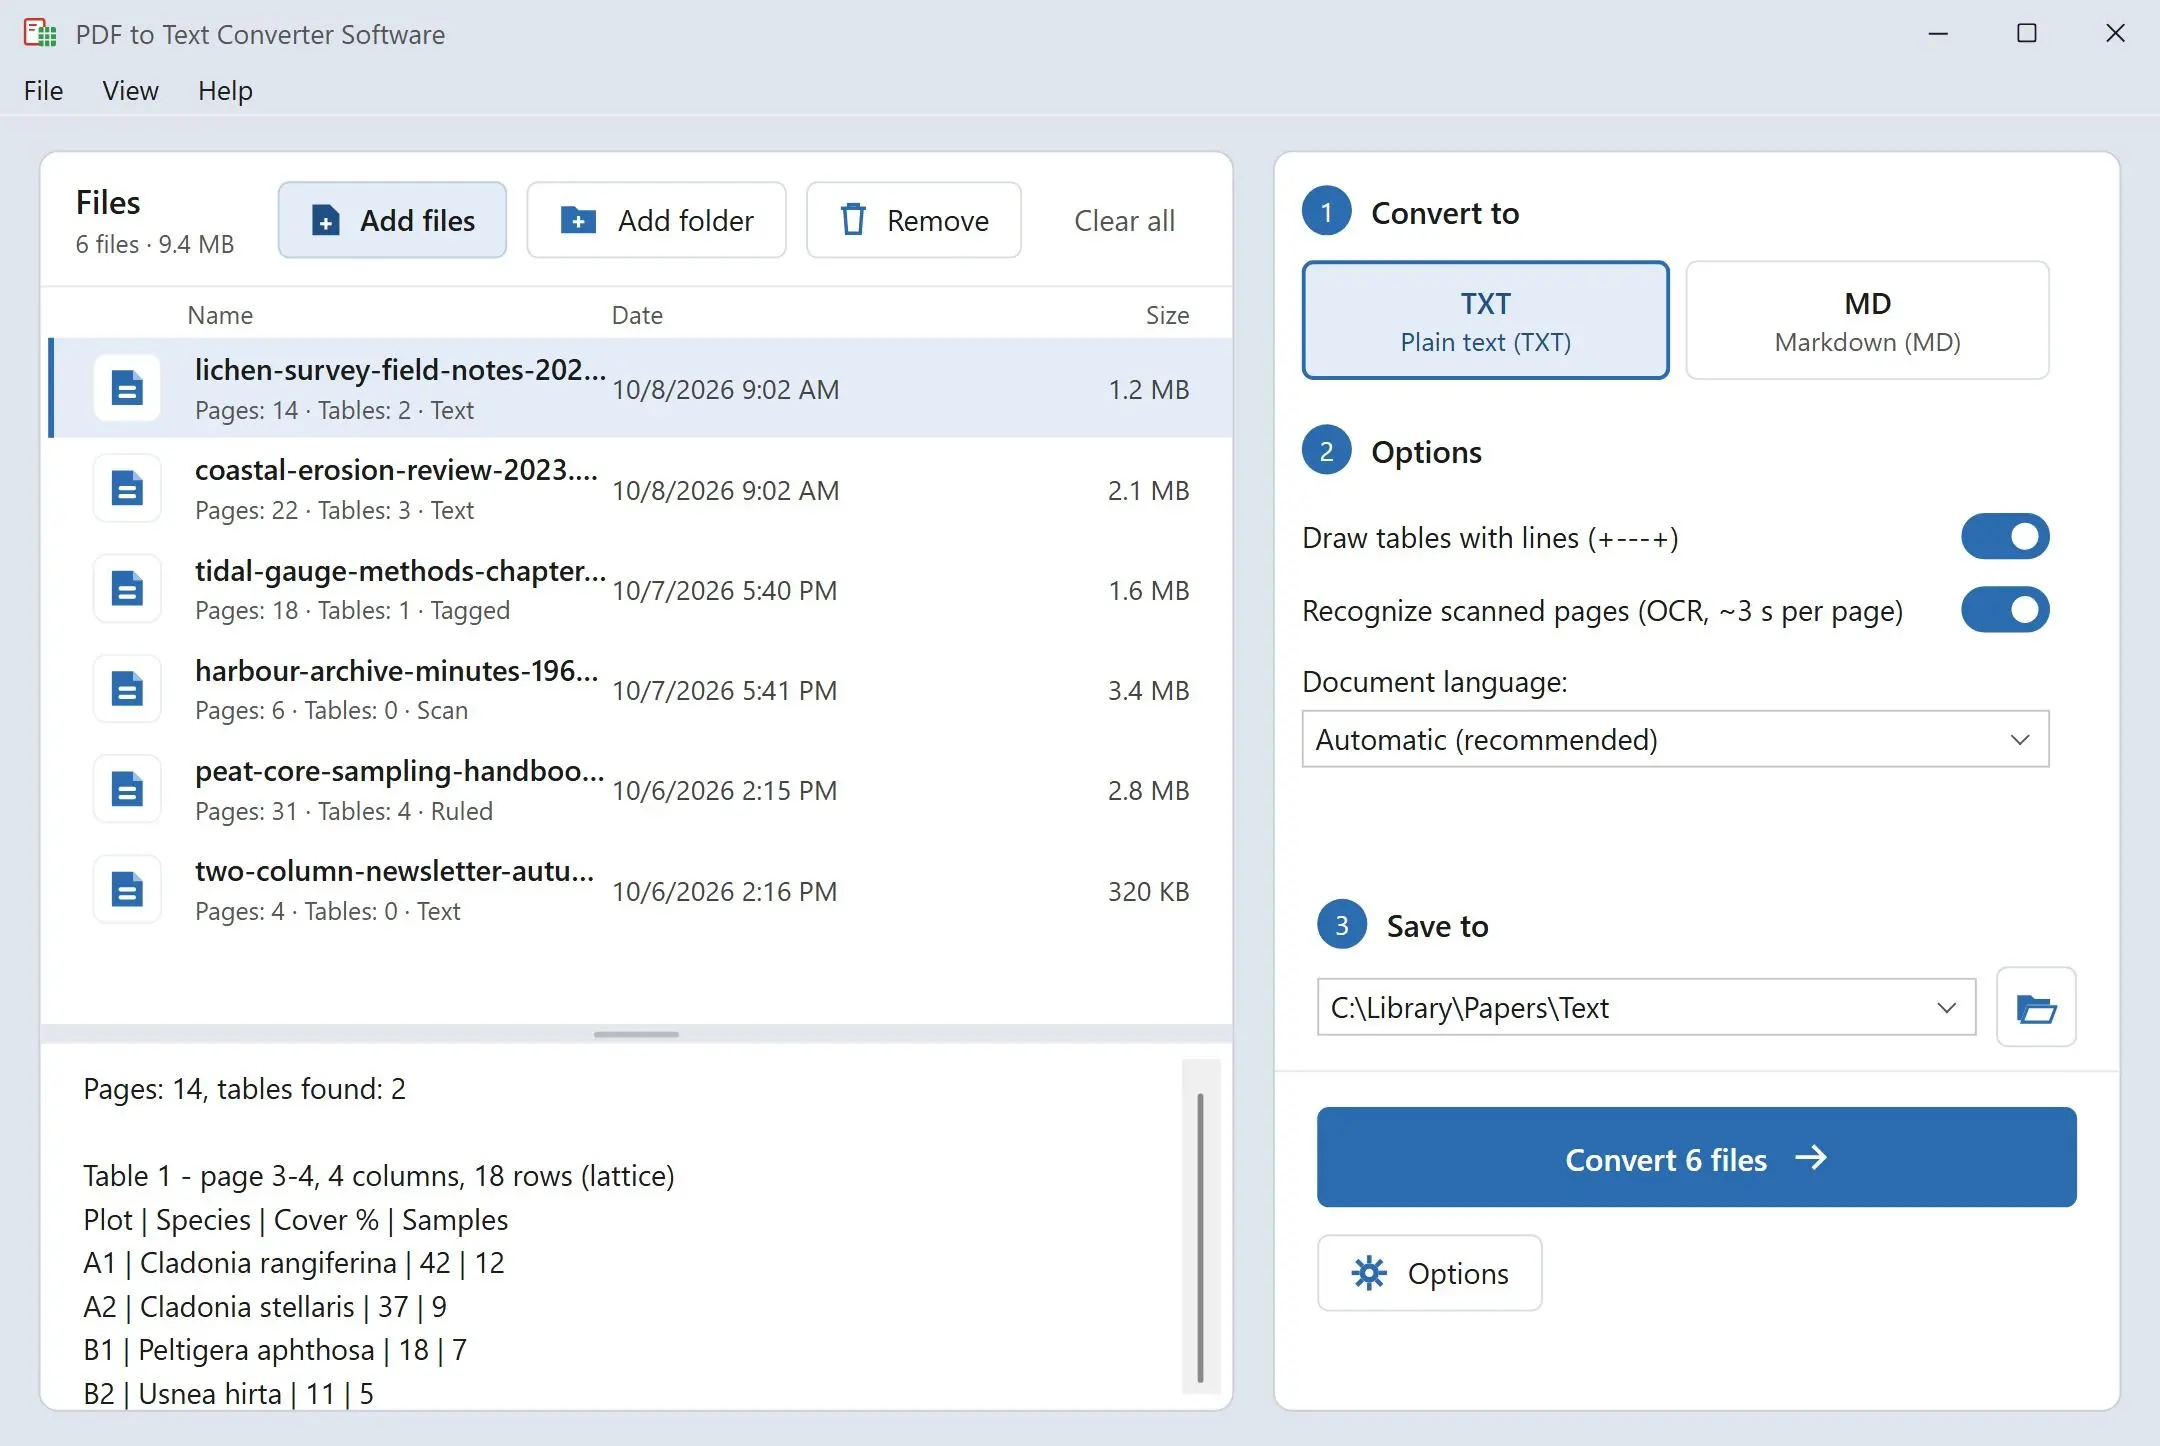
Lägg till en mapp med PDF-filer och få en .txt- eller .md-fil för var och en, skriven på din egen Windows-dator. Kolumner kommer ut i den ordning du skulle läsa dem, och tabeller behåller varje siffra under rätt rubrik.
Att få ut orden ur en PDF borde inte ta en eftermiddag
Markera allt i en PDF-läsare, klistra in i Anteckningar, och en tvåkolumnsartikel blir rader som hoppar mellan kolumnerna mitt i meningen, medan en tabell kollapsar till en sträng av siffror utan något som skiljer dem åt. Webbplatser gör ett bättre jobb, en uppladdning i taget, och behåller din fil på sin server en stund. Det här programmet hanterar en hel mapp i ett svep: det läser varje PDF på din dator och skriver ren text som du kan läsa, söka i och citera.
How to use it
Lägg till filer eller en mapp
Släpp enskilda PDF-filer eller en hel mapp i listan. Spara utdata bredvid varje original eller i en mapp som du väljer. Två filer med samma namn från olika mappar får separata utdata, så ingenting skrivs över av misstag.
Välj ren text eller Markdown
Ren text är UTF-8 med radslut från Windows och ett sidmatningstecken (form feed) mellan sidorna. Tabeller ramas in med +---+-linjer som standard; slå av det så radas kolumnerna i stället upp med mellanslag. Markdown gör titlar till #-rubriker och tabeller till pipe-tabeller.
Starta bulkkörningen och sök i resultaten
En start täcker hela listan. När den är klar berättar en sammanfattning hur många filer som skrevs och var. Rikta Windows sökning, din editor eller grep mot mappen och slå upp vilken fras som helst i alla dokument på en gång.
Benefits
Kolumner läses som en människa läser dem
På en tidskriftssida med två kolumner skrivs hela vänsterkolumnen först, sedan hela högerkolumnen. Meningar hålls i ett stycke, och avsnittsrubriker känns igen på sin storlek, så de hamnar inte mitt i ett stycke.
Tabeller du kan läsa i Anteckningar
En prislista eller en labbrapport behåller sitt rutnät: varje siffra stannar under sin kolumnrubrik, inramad med vanliga tecken som vilken textredigerare som helst kan visa. Bara riktiga tabeller får rutnät, så en sida med löpande text i två kolumner förblir löpande text.
Ingenting lämnar din dator
PDF-motorn körs från programmappen på din egen dator. Ingen uppladdning, inget konto och ingen nätverksanslutning är inblandade, så kontrakt, journaler och opublicerade manuskript stannar där de är.
Varför folk använder det
Skannade sidor känns också igen
En sida som bara är en bild av papper går genom textigenkänning på din dator, med ungefär 3 sekunder per sida. Det omfattar latinska och kyrilliska skriftsystem och kräver 64-bitars Windows. Sidor som redan har ett textlager tas som de är, och tabeller på en skanning kommer ut utslagna i kolumner utan rutnät.
Redo för anteckningsappar och AI-assistenter
Markdown-utdata går direkt in i en anteckningsapp, en wiki eller en chatt med en AI-assistent utan efterbearbetning. Rubriker från # till ###### följer titlarnas storlek i dokumentet, och tabeller blir pipe-tabeller med första raden som rubrik.
Text på många språk
PDF-filer med textlager på kinesiska, japanska eller koreanska kommer ut som läsbar text, och hebreiska och arabiska rader behåller sin höger-till-vänster-ordning. Allt sparas som UTF-8, så filen öppnas korrekt i alla moderna editorer.
FAQ
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note