Bulk PDF Text Extractor
Chaque PDF du dossier, en texte où l'on peut chercher
Convertissez des fichiers PDF en texte brut ou en Markdown par lots, entièrement hors ligne. Les pages multicolonnes gardent leur ordre de lecture et les tableaux sont dessinés en grilles de texte. Essai gratuit.
Full seller details: Legal information.
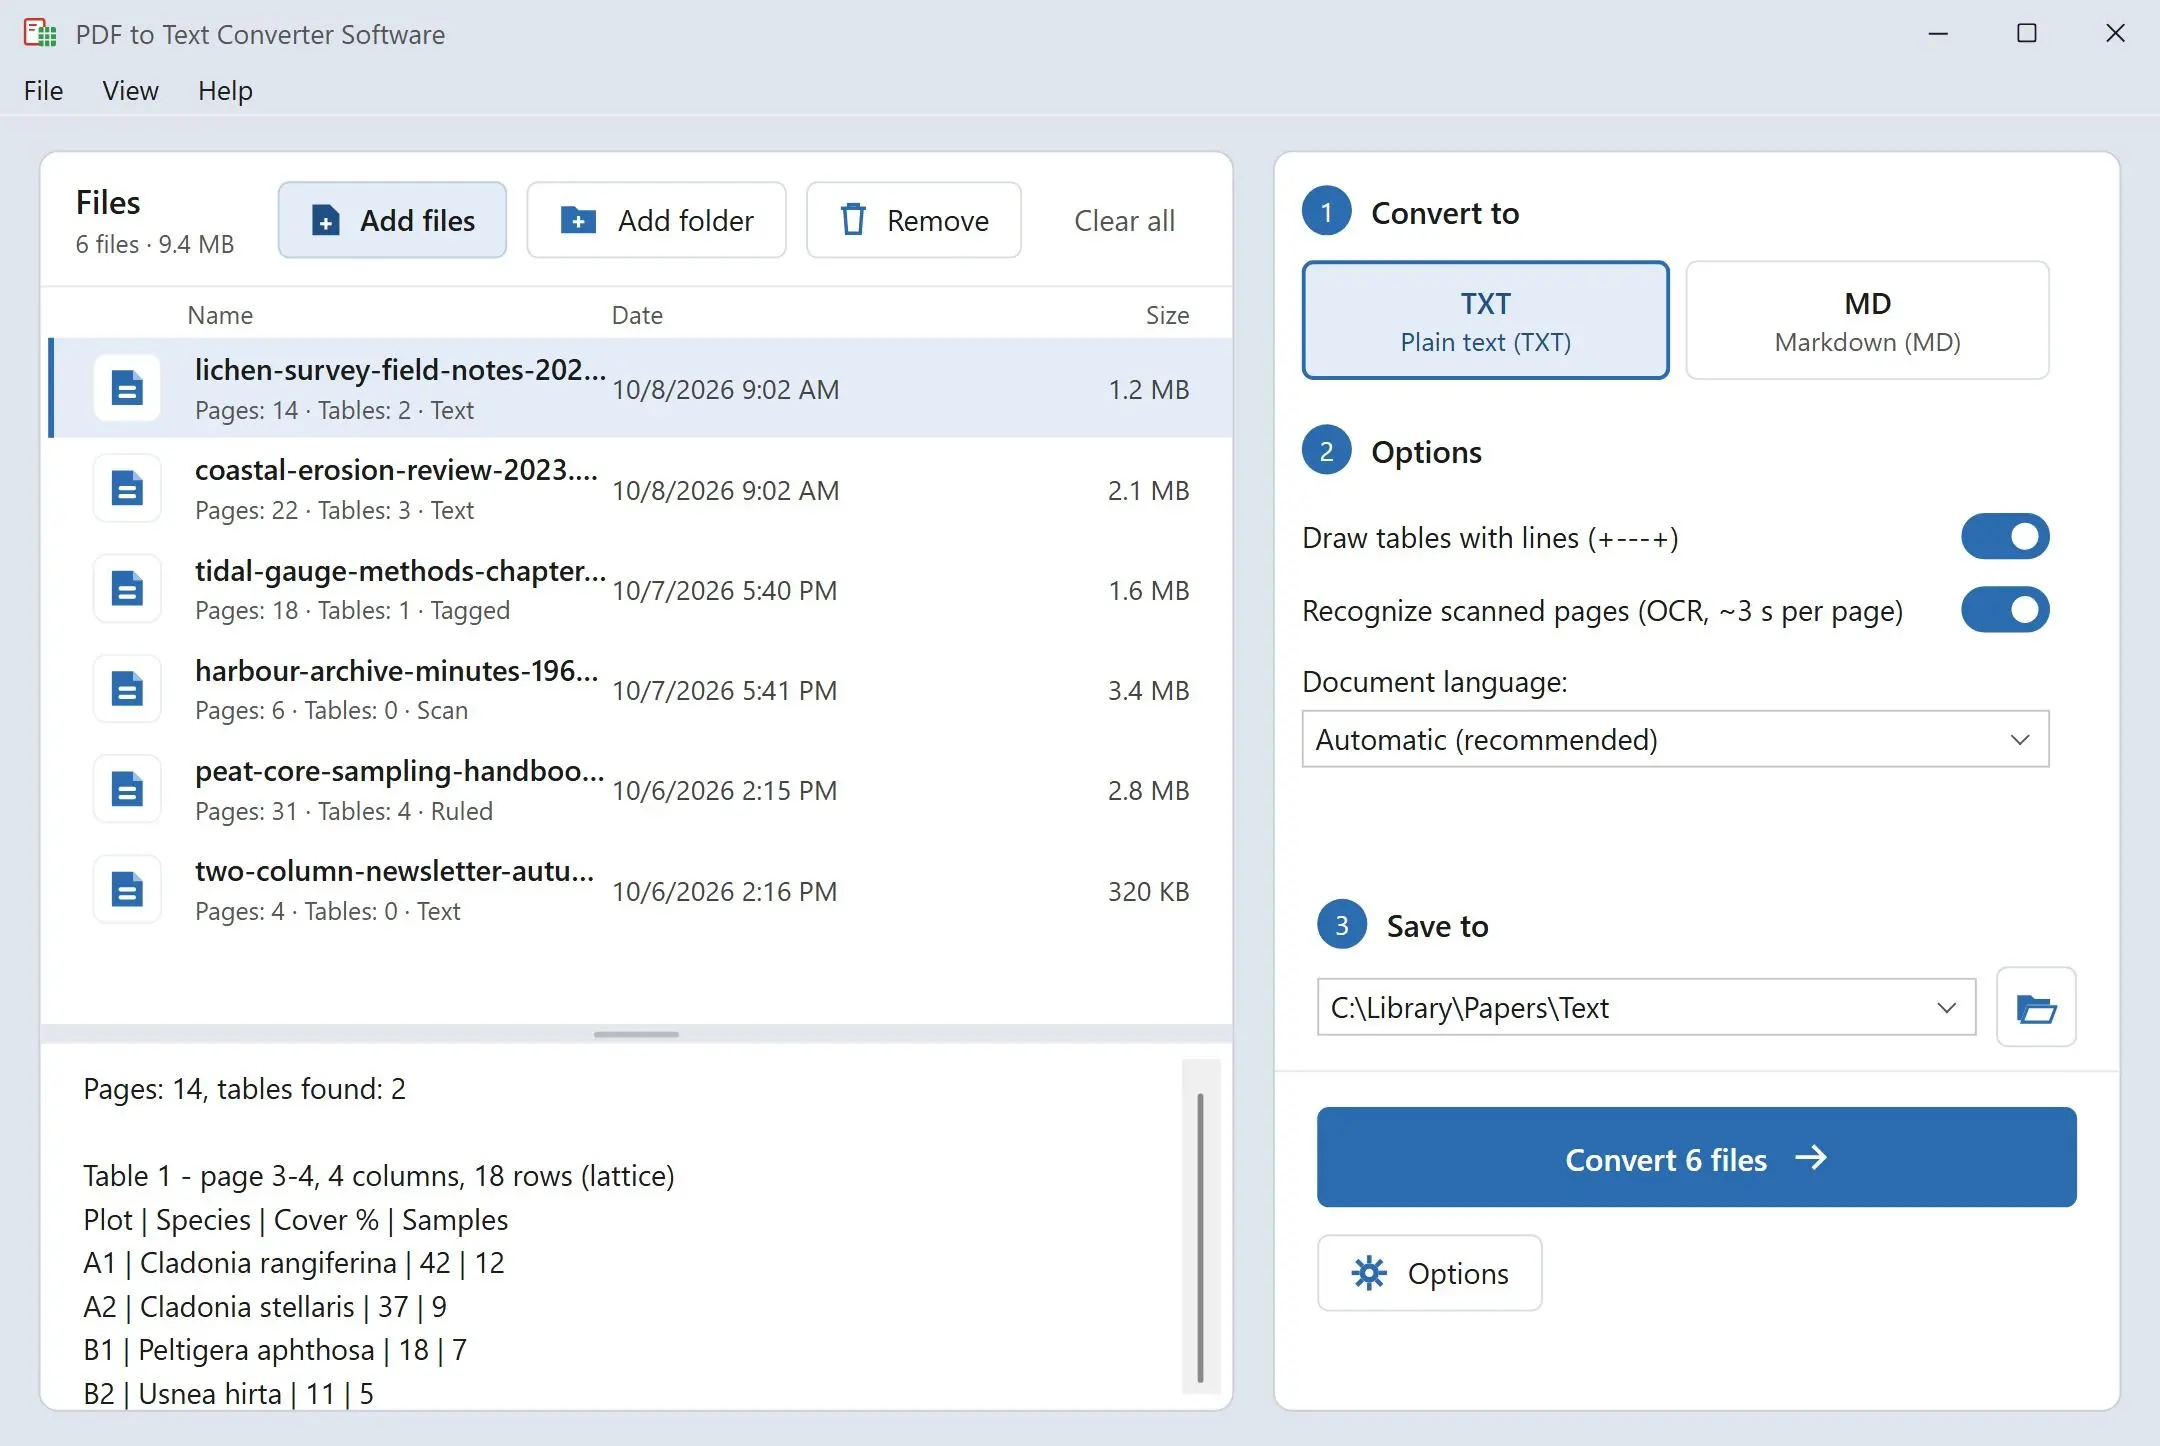
Ajoutez un dossier de PDF et obtenez un fichier .txt ou .md pour chacun, écrit sur votre propre PC Windows. Les colonnes ressortent dans l'ordre où vous les liriez, et les tableaux gardent chaque chiffre sous le bon en-tête.
Extraire les mots d'un PDF ne devrait pas prendre un après-midi
Tout sélectionner dans une visionneuse PDF, coller dans le Bloc-notes, et un article sur deux colonnes devient des lignes qui sautent d'une colonne à l'autre en pleine phrase, tandis qu'un tableau s'effondre en une suite de chiffres sans rien pour les distinguer. Les sites web font mieux, un téléversement à la fois, et gardent votre fichier un moment sur leur serveur. Ce programme traite un dossier entier d'un coup : il lit chaque PDF sur votre machine et écrit du texte brut que vous pouvez lire, chercher et citer.
How to use it
Ajouter des fichiers ou un dossier
Déposez des PDF isolés ou un dossier entier dans la liste. Enregistrez la sortie à côté de chaque original ou dans un dossier de votre choix. Deux fichiers de même nom venant de dossiers différents obtiennent des sorties séparées, rien n'est donc écrasé par accident.
Choisir texte brut ou Markdown
Le texte brut est en UTF-8 avec fins de ligne Windows et un saut de page (form feed) entre les pages. Les tableaux sont encadrés par défaut avec des lignes +---+ ; désactivez cela et les colonnes sont alignées avec des espaces. Markdown transforme les titres en en-têtes # et les tableaux en tableaux à barres verticales.
Lancer le lot et chercher dans les résultats
Un seul démarrage couvre toute la liste. À la fin, un récapitulatif indique combien de fichiers ont été écrits et où. Pointez la recherche Windows, votre éditeur ou grep vers ce dossier et cherchez n'importe quelle expression dans tous les documents à la fois.
Benefits
Des colonnes lues comme un humain les lit
Sur une page de revue à deux colonnes, toute la colonne de gauche est écrite d'abord, puis toute celle de droite. Les phrases restent d'un seul tenant, et les titres de section sont reconnus à leur taille, ils ne se retrouvent donc pas au milieu d'un paragraphe.
Des tableaux lisibles dans le Bloc-notes
Un tarif ou un rapport de laboratoire garde sa grille : chaque chiffre reste sous l'en-tête de sa colonne, encadré de caractères simples que n'importe quel éditeur de texte sait afficher. Seuls les vrais tableaux reçoivent une grille, une page de prose composée sur deux colonnes reste donc de la prose.
Rien ne quitte votre PC
Le moteur PDF s'exécute depuis le dossier du programme sur votre propre machine. Il n'y a ni téléversement, ni compte, ni connexion réseau, de sorte que contrats, dossiers médicaux et manuscrits non publiés restent là où ils sont.
Pourquoi les gens l'utilisent
Les pages numérisées sont reconnues aussi
Une page qui n'est qu'une image de papier passe par la reconnaissance de texte sur votre PC, à environ 3 secondes par page. Elle couvre les écritures latine et cyrillique et nécessite Windows 64 bits. Les pages qui ont déjà une couche de texte sont prises telles quelles, et les tableaux d'un scan ressortent espacés en colonnes, sans la grille.
Prêt pour les applications de notes et les assistants IA
La sortie Markdown va directement dans une application de notes, un wiki ou une conversation avec un assistant IA sans nettoyage. Les titres de # à ###### suivent la taille des titres du document, et les tableaux deviennent des tableaux à barres verticales avec la première ligne comme en-tête.
Du texte en de nombreuses langues
Les PDF avec couche de texte en chinois, japonais ou coréen ressortent en texte lisible, et les lignes en hébreu et en arabe gardent leur ordre de droite à gauche. Tout est enregistré en UTF-8, le fichier s'ouvre donc correctement dans n'importe quel éditeur moderne.
FAQ
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note