Bulk PDF Text Extractor
A mappa minden PDF-je kereshető szövegként
Konvertáljon PDF-fájlokat egyszerű szöveggé vagy Markdownná kötegelve, teljesen offline. A többoszlopos oldalak megőrzik az olvasási sorrendet, a táblázatok szöveges rácsként jelennek meg. Ingyenes próbaverzió.
Full seller details: Legal information.
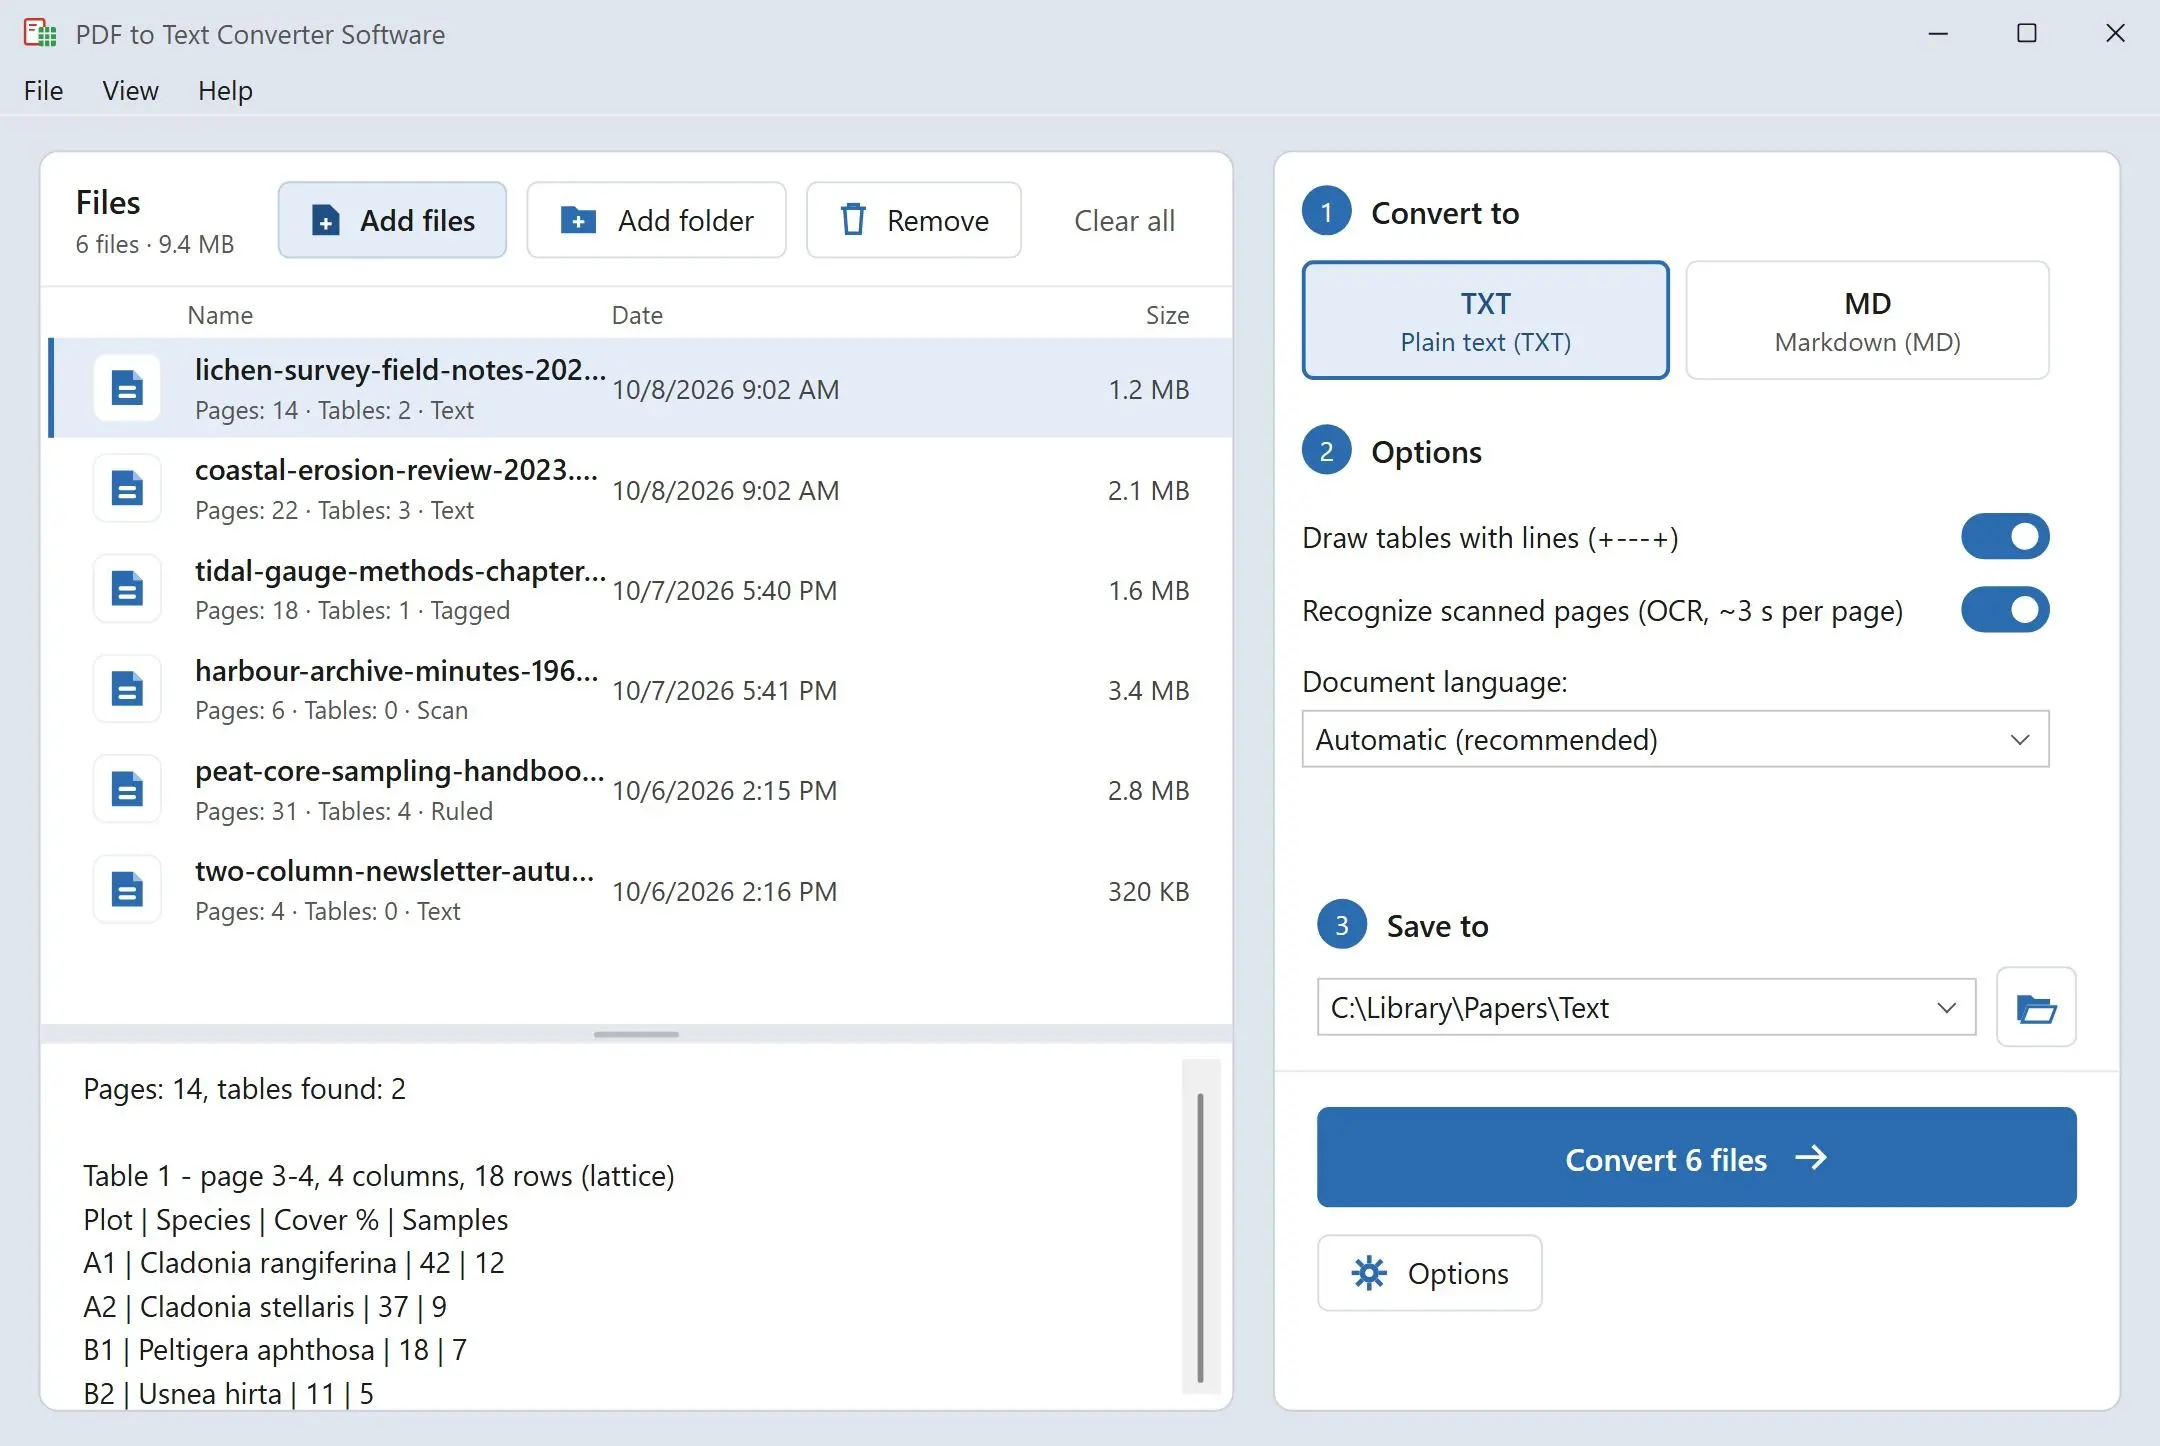
Adjon meg egy PDF-ekkel teli mappát, és mindegyikhez kap egy .txt vagy .md fájlt, a saját Windows-számítógépén elkészítve. Az oszlopok olyan sorrendben jönnek ki, ahogy olvasná őket, a táblázatok pedig minden számot a megfelelő fejléc alatt tartanak.
A szavak kinyerése egy PDF-ből nem tarthat egy délutánig
Jelölje ki az egészet egy PDF-megjelenítőben, illessze be a Jegyzettömbbe, és a kétoszlopos tanulmány mondat közben oszlopok között ugráló sorokká válik, a táblázat pedig számok láncává esik szét, amelyeket semmi nem különböztet meg. A weboldalak jobban teljesítenek, de fájlonként egyenként, és egy ideig a szerverükön tartják a fájlját. Ez a program egy menetben kezeli a teljes mappát: minden PDF-et a gépén olvas be, és egyszerű szöveget ír, amelyet olvashat, kereshet és idézhet.
How to use it
Fájlok vagy mappa hozzáadása
Húzzon egyes PDF-eket vagy egy egész mappát a listára. A kimenetet mentse az egyes eredetik mellé vagy egy Ön által választott mappába. A különböző mappákból származó, azonos nevű két fájl külön kimenetet kap, így semmi sem íródik felül véletlenül.
Egyszerű szöveg vagy Markdown választása
Az egyszerű szöveg UTF-8 Windows-sorvégekkel és oldalanként form feed karakterrel. A táblázatokat alapból +---+ sorok keretezik; kapcsolja ki, és az oszlopokat szóközökkel igazítja. A Markdown a címeket # fejlécekké, a táblázatokat függőleges vonalas táblázatokká alakítja.
A köteg indítása és az eredmények keresése
Egy indítás az egész listát lefedi. Ha végzett, az összegzés megmondja, hány fájl készült el és hol. Irányítsa a Windows keresőjét, a szerkesztőjét vagy a grep-et arra a mappára, és keressen rá bármilyen kifejezésre az összes dokumentumban egyszerre.
Benefits
Az oszlopok úgy olvashatók, ahogy az ember olvassa
Egy kétoszlopos folyóiratoldalon előbb a teljes bal oszlop íródik ki, majd a teljes jobb. A mondatok egyben maradnak, a szakaszcímeket pedig méretük alapján ismeri fel, így nem kerülnek bekezdés közepére.
Jegyzettömbben olvasható táblázatok
Egy árlista vagy laboratóriumi jelentés megtartja a rácsát: minden szám a saját oszlopfejléce alatt marad, egyszerű karakterekkel keretezve, amelyeket bármelyik szövegszerkesztő megjelenít. Csak a valódi táblázatok kapnak rácsot, így a két oszlopba szedett próza próza marad.
Semmi nem hagyja el a számítógépét
A PDF-motor a saját gépén lévő programmappából fut. Nincs feltöltés, fiók és hálózati kapcsolat, így a szerződések, az orvosi iratok és a kiadatlan kéziratok ott maradnak, ahol vannak.
Miért használják az emberek?
A szkennelt oldalakat is felismeri
Az a lap, amely csupán a papír képe, a számítógépén szövegfelismerésen megy át, oldalanként nagyjából 3 másodperc alatt. Latin és cirill írásrendszert kezel, és 64 bites Windowst igényel. A már szövegréteggel rendelkező oldalakat úgy veszi, ahogy vannak, a szkennelt táblázatok pedig szóközökkel oszlopokra tagolva jönnek ki, rács nélkül.
Jegyzetelő alkalmazásokhoz és MI-asszisztensekhez kész
A Markdown-kimenet tisztítás nélkül beilleszthető jegyzetelő alkalmazásba, wikibe vagy MI-asszisztenssel folytatott beszélgetésbe. A # és ###### közötti fejlécek a dokumentum címeinek méretét követik, a táblázatok pedig függőleges vonalas táblázatok lesznek, az első sorral fejlécként.
Szöveg sok nyelven
A kínai, japán vagy koreai szövegréteggel rendelkező PDF-ek olvasható szövegként jönnek ki, a héber és arab sorok pedig megőrzik a jobbról balra haladó sorrendet. Minden UTF-8 formátumban mentődik, így a fájl bármely modern szerkesztőben helyesen nyílik meg.
GYIK
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note