Bulk PDF Text Extractor
Každý PDF ve složce jako text, ve kterém lze hledat
Převádějte soubory PDF na prostý text nebo Markdown hromadně a zcela offline. Vícesloupcové stránky zachovají pořadí čtení a tabulky se vykreslí jako textové mřížky. Zkušební verze zdarma.
Full seller details: Legal information.
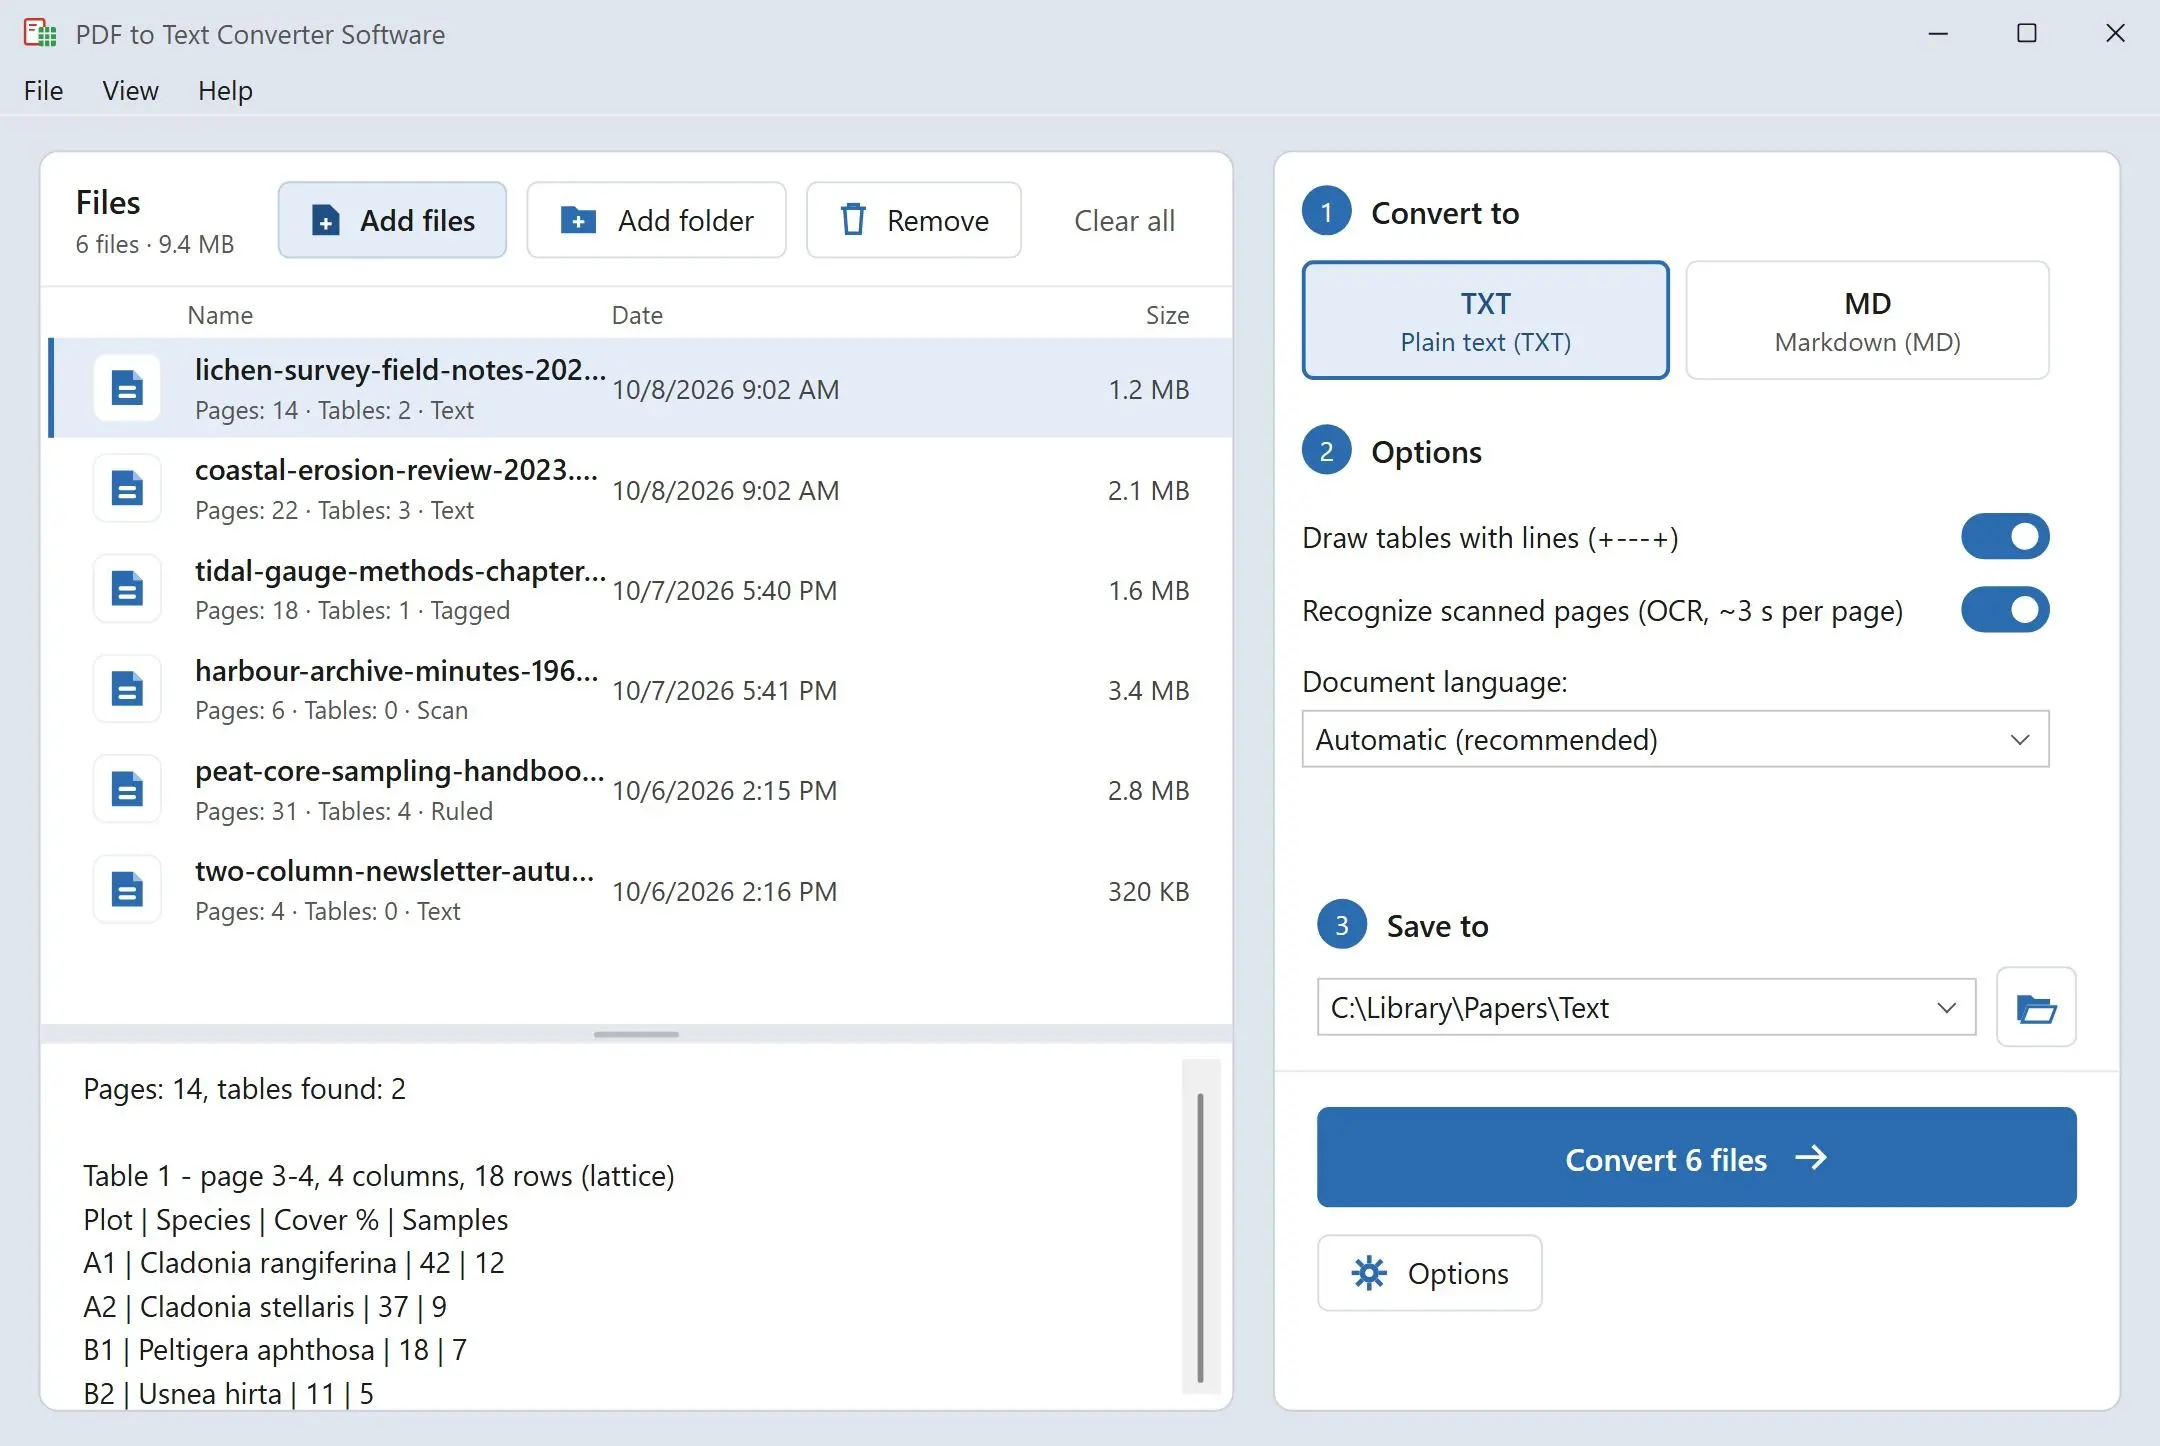
Přidejte složku s PDF a získejte pro každý jeden soubor .txt nebo .md, vytvořený na vašem počítači s Windows. Sloupce vycházejí v pořadí, v jakém byste je četli, a tabulky drží každé číslo pod správnou hlavičkou.
Vytáhnout slova z PDF by nemělo zabrat odpoledne
Vyberte vše v prohlížeči PDF, vložte do Poznámkového bloku a dvousloupcový článek se změní na řádky, které uprostřed věty přeskakují mezi sloupci, zatímco tabulka se zhroutí do řetězce čísel, které nic neodliší. Webové stránky to zvládnou lépe, ale po jednom souboru a váš soubor si na svém serveru nějakou dobu nechají. Tento program zpracuje celou složku najednou: přečte každý PDF ve vašem počítači a zapíše prostý text, který můžete číst, prohledávat a citovat.
How to use it
Přidejte soubory nebo složku
Přetáhněte do seznamu jednotlivé PDF nebo celou složku. Výstup ukládejte vedle každého originálu nebo do jedné zvolené složky. Dva soubory se stejným názvem z různých složek dostanou samostatné výstupy, takže se nic omylem nepřepíše.
Zvolte prostý text nebo Markdown
Prostý text je UTF-8 se zakončením řádků Windows a form feed mezi stránkami. Tabulky jsou ve výchozím stavu orámované řádky +---+; vypněte to a sloupce se místo toho zarovnají mezerami. Markdown mění nadpisy na # a tabulky na tabulky se svislítky.
Spusťte dávku a prohledávejte výsledky
Jedno spuštění pokryje celý seznam. Po dokončení souhrn řekne, kolik souborů bylo zapsáno a kam. Namiřte na tu složku vyhledávání Windows, svůj editor nebo grep a hledejte libovolnou frázi napříč všemi dokumenty najednou.
Benefits
Sloupce se čtou tak, jak je čte člověk
Na dvousloupcové stránce časopisu se nejdřív zapíše celý levý sloupec, pak celý pravý. Věty zůstanou vcelku a nadpisy oddílů se rozpoznají podle velikosti, takže nekončí uprostřed odstavce.
Tabulky čitelné v Poznámkovém bloku
Ceník nebo laboratorní zpráva si zachová mřížku: každé číslo zůstane pod hlavičkou svého sloupce, orámované obyčejnými znaky, které zobrazí každý textový editor. Mřížku dostanou jen skutečné tabulky, takže stránka prózy v dvou sloupcích zůstane prózou.
Nic neopouští váš počítač
Engine PDF běží ze složky programu na vašem počítači. Žádné nahrávání, žádný účet a žádné síťové připojení, takže smlouvy, zdravotní záznamy a nepublikované rukopisy zůstávají tam, kde jsou.
Proč to lidé používají
Skenované stránky se také rozpoznají
Stránka, která je jen obrázkem papíru, projde rozpoznáváním textu ve vašem počítači, zhruba 3 sekundy na stránku. Zvládá latinku a cyrilici a vyžaduje 64bitové Windows. Stránky, které už mají textovou vrstvu, se berou tak, jak jsou, a tabulky na skenu vyjdou rozmístěné do sloupců bez mřížky.
Připraveno pro aplikace na poznámky a AI asistenty
Výstup Markdown jde rovnou do aplikace na poznámky, wiki nebo chatu s AI asistentem bez úprav. Nadpisy od # do ###### odpovídají velikosti nadpisů v dokumentu a tabulky se stanou tabulkami se svislítky s prvním řádkem jako hlavičkou.
Text v mnoha jazycích
PDF s textovou vrstvou v čínštině, japonštině nebo korejštině vyjdou jako čitelný text a hebrejské a arabské řádky zachovají pořadí zprava doleva. Vše se ukládá jako UTF-8, takže se soubor správně otevře v každém moderním editoru.
FAQ
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note