Bulk PDF Text Extractor
フォルダ内のすべてのPDFを、検索できるテキストに
PDFファイルをプレーンテキストまたはMarkdownに、完全オフラインで一括変換。複数段組みのページは読む順序を保ち、表は文字のグリッドで再現されます。無料体験版あり。
Full seller details: Legal information.
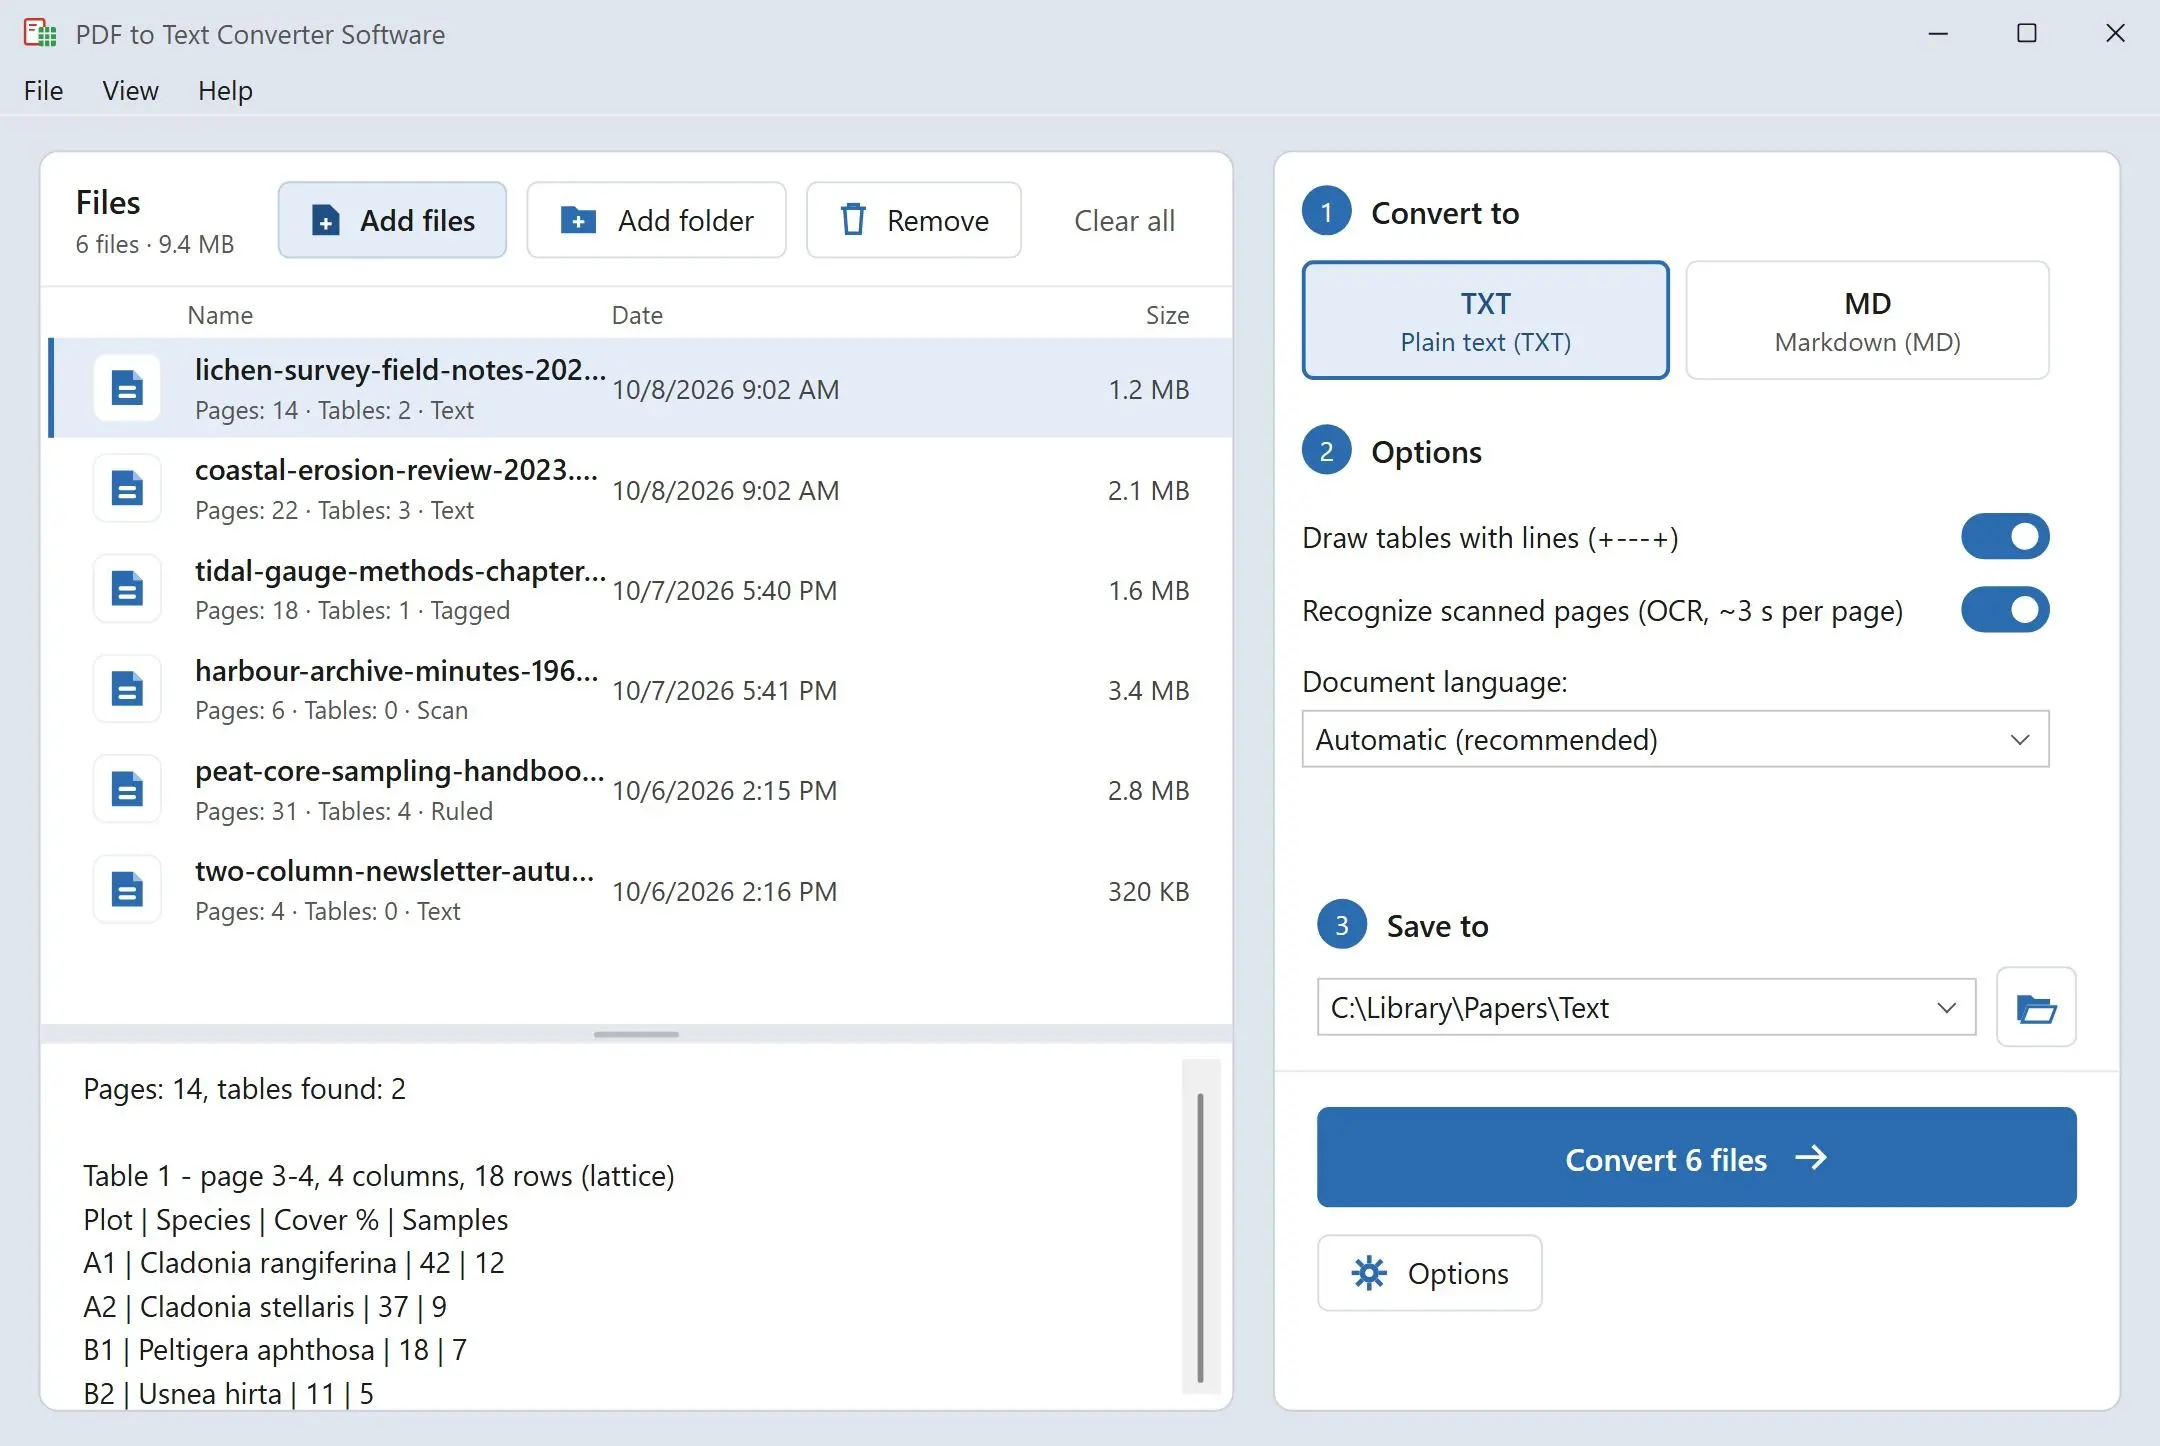
PDFのフォルダを追加すると、それぞれに対応する.txtまたは.mdファイルが1つずつ、お使いのWindows PC上で書き出されます。段組みは読む順序どおりに出力され、表は各数値が正しい見出しの下に保たれます。
PDFから文字を取り出すのに、午後いっぱいかけるべきではありません
PDFビューアーですべてを選択してメモ帳に貼り付けると、2段組みの論文は文の途中で段をまたいで飛ぶ行になり、表は区別のつかない数字の羅列に崩れてしまいます。Webサイトのほうが優秀ですが、アップロードは1件ずつで、ファイルはしばらくそのサーバーに残ります。このプログラムはフォルダ全体を一度に処理します。各PDFをあなたのマシン上で読み取り、読んで、検索して、引用できるプレーンテキストを書き出します。
How to use it
ファイルまたはフォルダを追加する
PDFを個別に、またはフォルダごとリストにドロップします。出力は元のファイルの隣か、選んだ1つのフォルダに保存します。別のフォルダにある同名の2つのファイルには、別々の出力が作られるため、誤って上書きされることはありません。
プレーンテキストかMarkdownかを選ぶ
プレーンテキストはUTF-8で、Windowsの改行コードが使われ、ページの間にはform feedが入ります。表は初期設定で+---+の線で囲まれます。これをオフにすると、列は代わりにスペースで揃えられます。Markdownでは、タイトルが#見出しに、表がパイプ形式の表になります。
一括処理を開始して、結果を検索する
1回の開始でリスト全体が処理されます。完了すると、書き出されたファイルの数と保存場所が概要で示されます。Windowsの検索、エディター、grepをそのフォルダに向ければ、あらゆる文書を横断して、任意のフレーズを一度に検索できます。
Benefits
段組みも、人が読む順序で
2段組みの学術誌のページでは、左の段全体が先に書き出され、次に右の段全体が続きます。文は途切れずにつながり、節の見出しは大きさで識別されるため、段落の途中に紛れ込むことはありません。
メモ帳で読める表
価格表や検査レポートはグリッドを保ちます。各数値は列の見出しの下にとどまり、どのテキストエディターでも表示できる通常の文字で囲まれます。グリッドが付くのは本物の表だけなので、2段組みで書かれた文章のページは文章のままです。
何もPCの外に出ない
PDFエンジンは、あなた自身のマシンのプログラムフォルダから動作します。アップロードも、アカウントも、ネットワーク接続も一切ありません。そのため、契約書、医療記録、未発表の原稿は、元の場所にとどまります。
選ばれる理由
スキャンしたページも認識
紙の画像だけのページは、PC上で文字認識にかけられ、1ページあたり約3秒かかります。対象はラテン文字とキリル文字で、64ビットWindowsが必要です。すでにテキストレイヤーがあるページはそのまま取り込まれ、スキャンした表はグリッドなしで、列ごとにスペースで区切られて出力されます。
メモアプリやAIアシスタントにそのまま使える
Markdown出力は、整形し直さずに、メモアプリ、wiki、AIアシスタントとのチャットにそのまま貼り付けられます。#から######までの見出しは文書内のタイトルの大きさに従い、表は1行目を見出しとしたパイプ形式の表になります。
多言語のテキストに対応
テキストレイヤーのある中国語、日本語、韓国語のPDFは読めるテキストとして出力され、ヘブライ語とアラビア語の行は右から左への順序が保たれます。すべてUTF-8で保存されるため、最新のどのエディターでもファイルが正しく開きます。
よくある質問
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note