Bulk PDF Text Extractor
Каждый PDF в папке - текстом, по которому можно искать
Преобразуйте файлы PDF в обычный текст или Markdown пакетом, полностью офлайн. Многоколоночные страницы сохраняют порядок чтения, а таблицы рисуются текстовыми сетками. Бесплатная пробная версия.
Full seller details: Legal information.
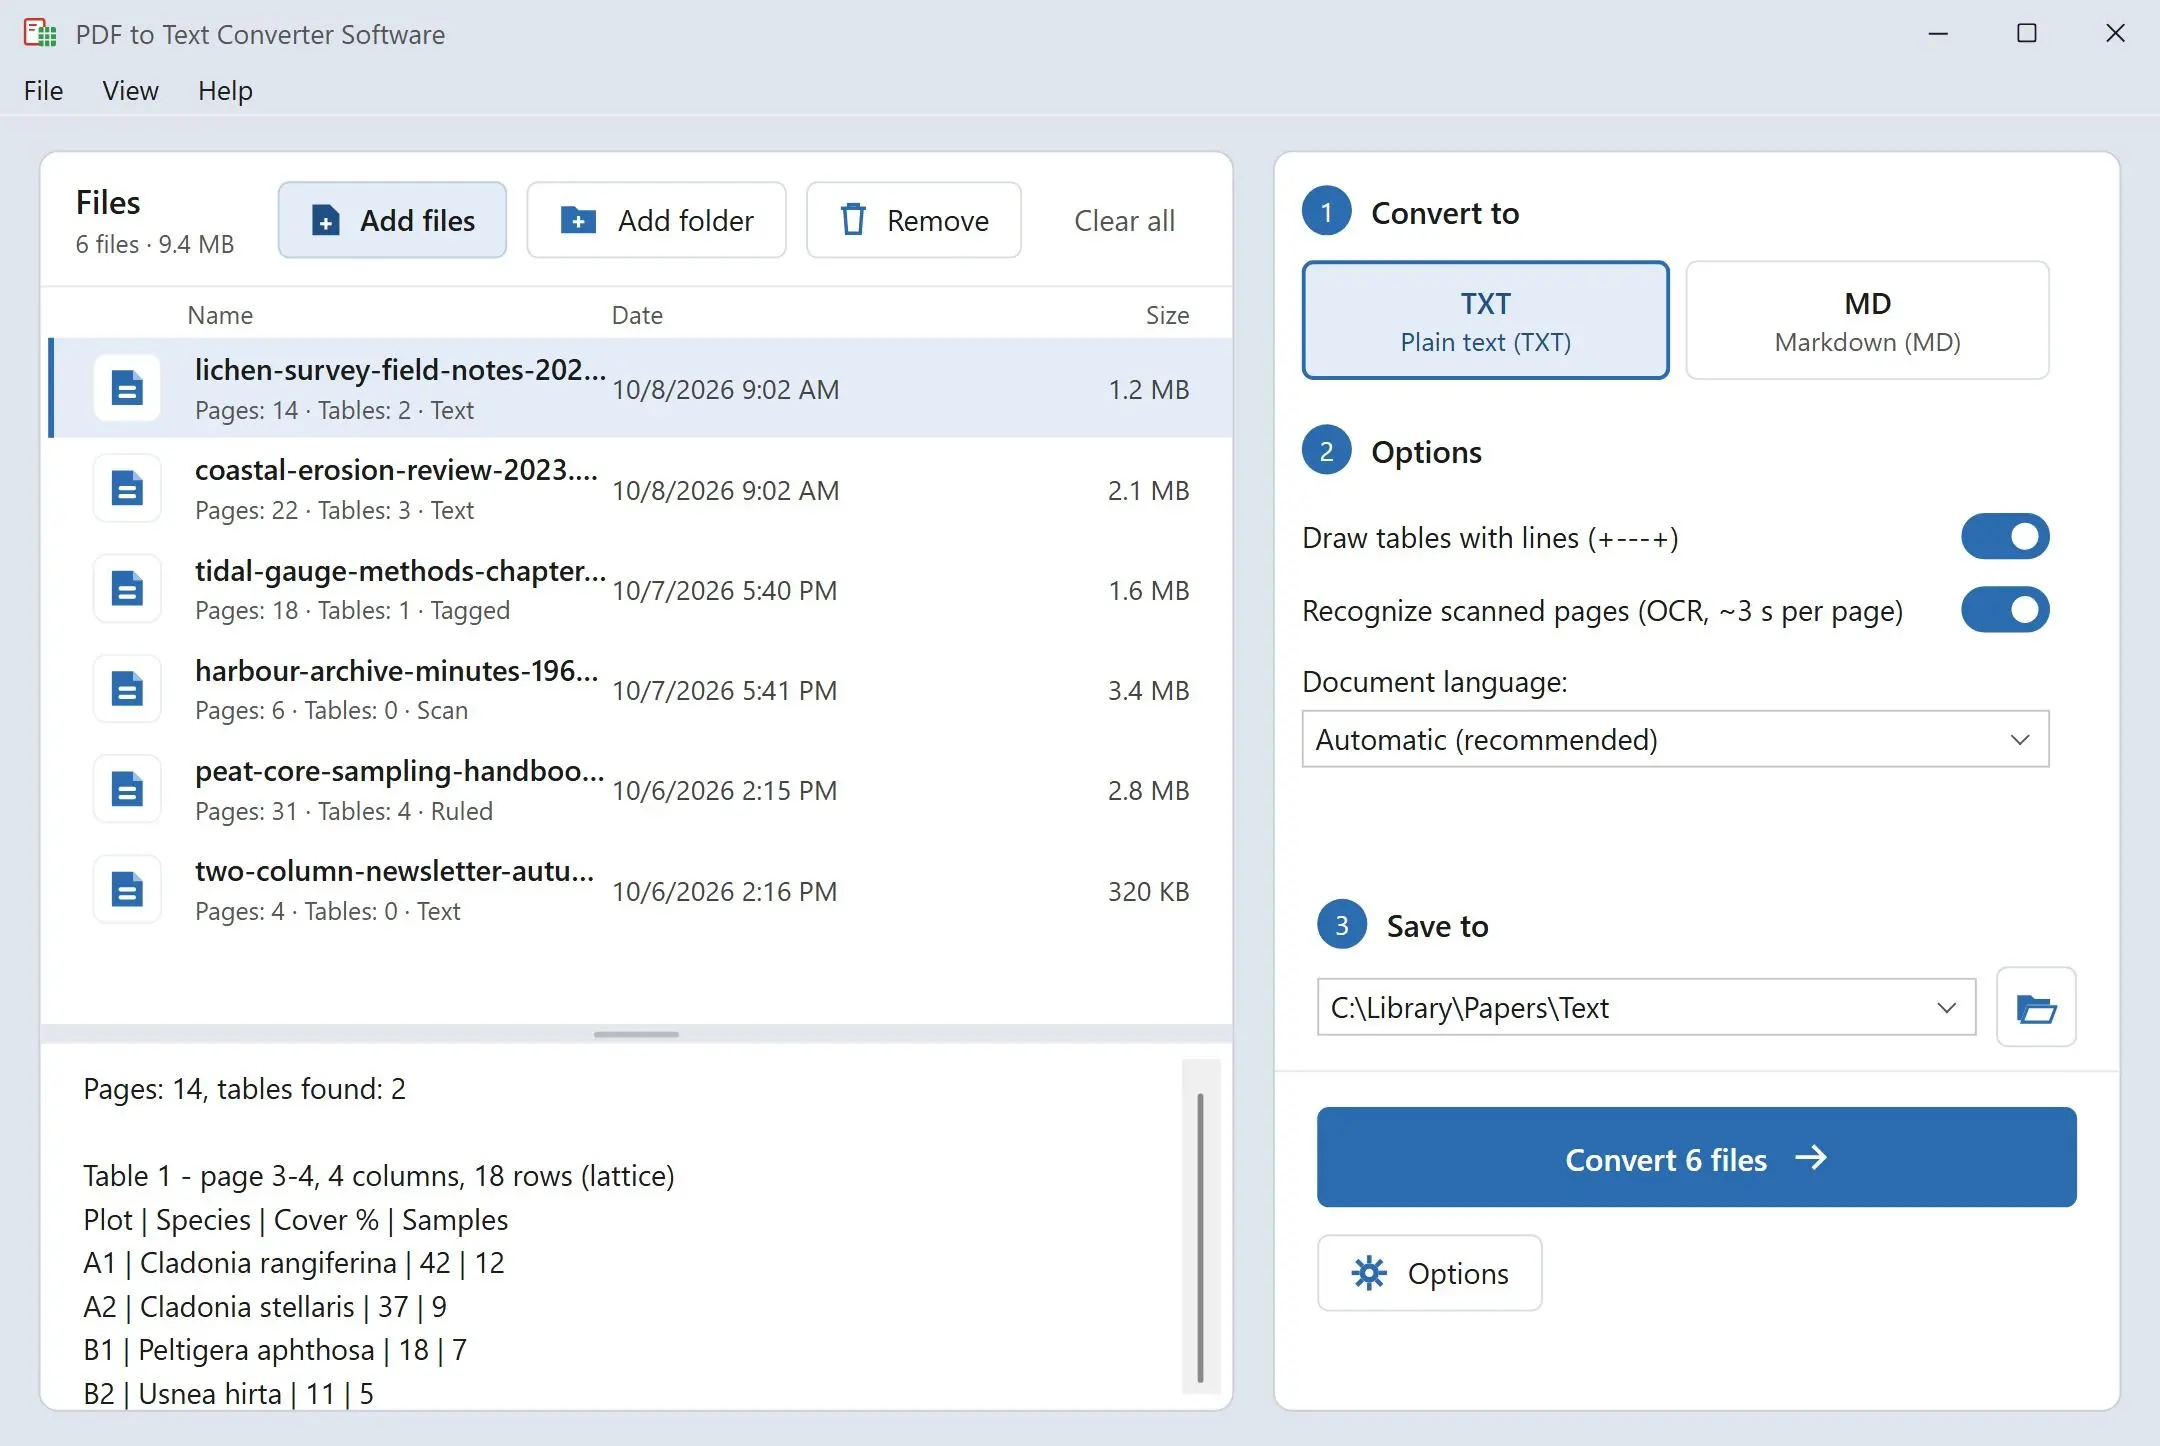
Добавьте папку с PDF и получите по одному файлу .txt или .md на каждый, созданному на вашем компьютере с Windows. Колонки выходят в том порядке, в каком вы их читаете, а в таблицах каждая цифра остаётся под своим заголовком.
Достать слова из PDF не должно занимать полдня
Выделите всё в просмотрщике PDF, вставьте в Блокнот - и статья в две колонки превратится в строки, которые посреди предложения перескакивают между колонками, а таблица рассыплется в ряд чисел, которые невозможно отличить друг от друга. Сайты справляются лучше, но по одному файлу за раз и на какое-то время оставляют ваш файл на своём сервере. Эта программа обрабатывает сразу всю папку: читает каждый PDF на вашем компьютере и записывает обычный текст, который можно читать, искать и цитировать.
How to use it
Добавьте файлы или папку
Перетащите в список отдельные PDF или целую папку. Сохраняйте результат рядом с каждым оригиналом или в одну выбранную папку. Два файла с одинаковым именем из разных папок получают отдельные результаты, так что ничего не перезапишется случайно.
Выберите обычный текст или Markdown
Обычный текст - это UTF-8 с концами строк Windows и form feed между страницами. Таблицы по умолчанию обрамляются линиями +---+; отключите это, и столбцы будут выровнены пробелами. Markdown превращает заголовки в # и таблицы в таблицы с вертикальными чертами.
Запустите пакет и ищите по результатам
Один запуск охватывает весь список. По завершении сводка скажет, сколько файлов записано и где. Направьте на эту папку поиск Windows, ваш редактор или grep и ищите любую фразу сразу по всем документам.
Benefits
Колонки читаются так, как читает человек
На странице журнала в две колонки сначала записывается вся левая колонка, затем вся правая. Предложения остаются цельными, а заголовки разделов распознаются по размеру, поэтому не оказываются посреди абзаца.
Таблицы, которые читаются в Блокноте
Прайс-лист или лабораторный отчёт сохраняет свою сетку: каждая цифра остаётся под заголовком своего столбца, обрамлённая обычными символами, которые покажет любой текстовый редактор. Сетку получают только настоящие таблицы, поэтому страница прозы в две колонки остаётся прозой.
Ничего не покидает ваш компьютер
Движок PDF работает из папки программы на вашем компьютере. Никакой загрузки, учётной записи или сетевого подключения не требуется, поэтому договоры, медицинские карты и неопубликованные рукописи остаются там, где лежат.
Почему люди это используют
Сканы тоже распознаются
Страница, которая является лишь изображением бумаги, проходит распознавание текста на вашем компьютере, примерно по 3 секунды на страницу. Поддерживаются латиница и кириллица, нужна 64-разрядная Windows. Страницы с готовым текстовым слоем берутся как есть, а таблицы на скане выходят выровненными пробелами по колонкам, без сетки.
Готово для приложений заметок и ИИ-ассистентов
Результат в Markdown сразу подходит для приложения заметок, вики или чата с ИИ-ассистентом без доработки. Заголовки от # до ###### следуют размеру заголовков в документе, а таблицы становятся таблицами с вертикальными чертами, где первая строка - шапка.
Текст на многих языках
PDF с текстовым слоем на китайском, японском или корейском превращаются в читаемый текст, а строки на иврите и арабском сохраняют порядок справа налево. Всё сохраняется в UTF-8, поэтому файл правильно открывается в любом современном редакторе.
FAQ
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note