Bulk PDF Text Extractor
Jede PDF im Ordner als durchsuchbarer Text
Wandeln Sie PDF-Dateien stapelweise und vollständig offline in reinen Text oder Markdown um. Mehrspaltige Seiten behalten ihre Lesereihenfolge, Tabellen werden als Textraster dargestellt. Kostenlos testen.
Full seller details: Legal information.
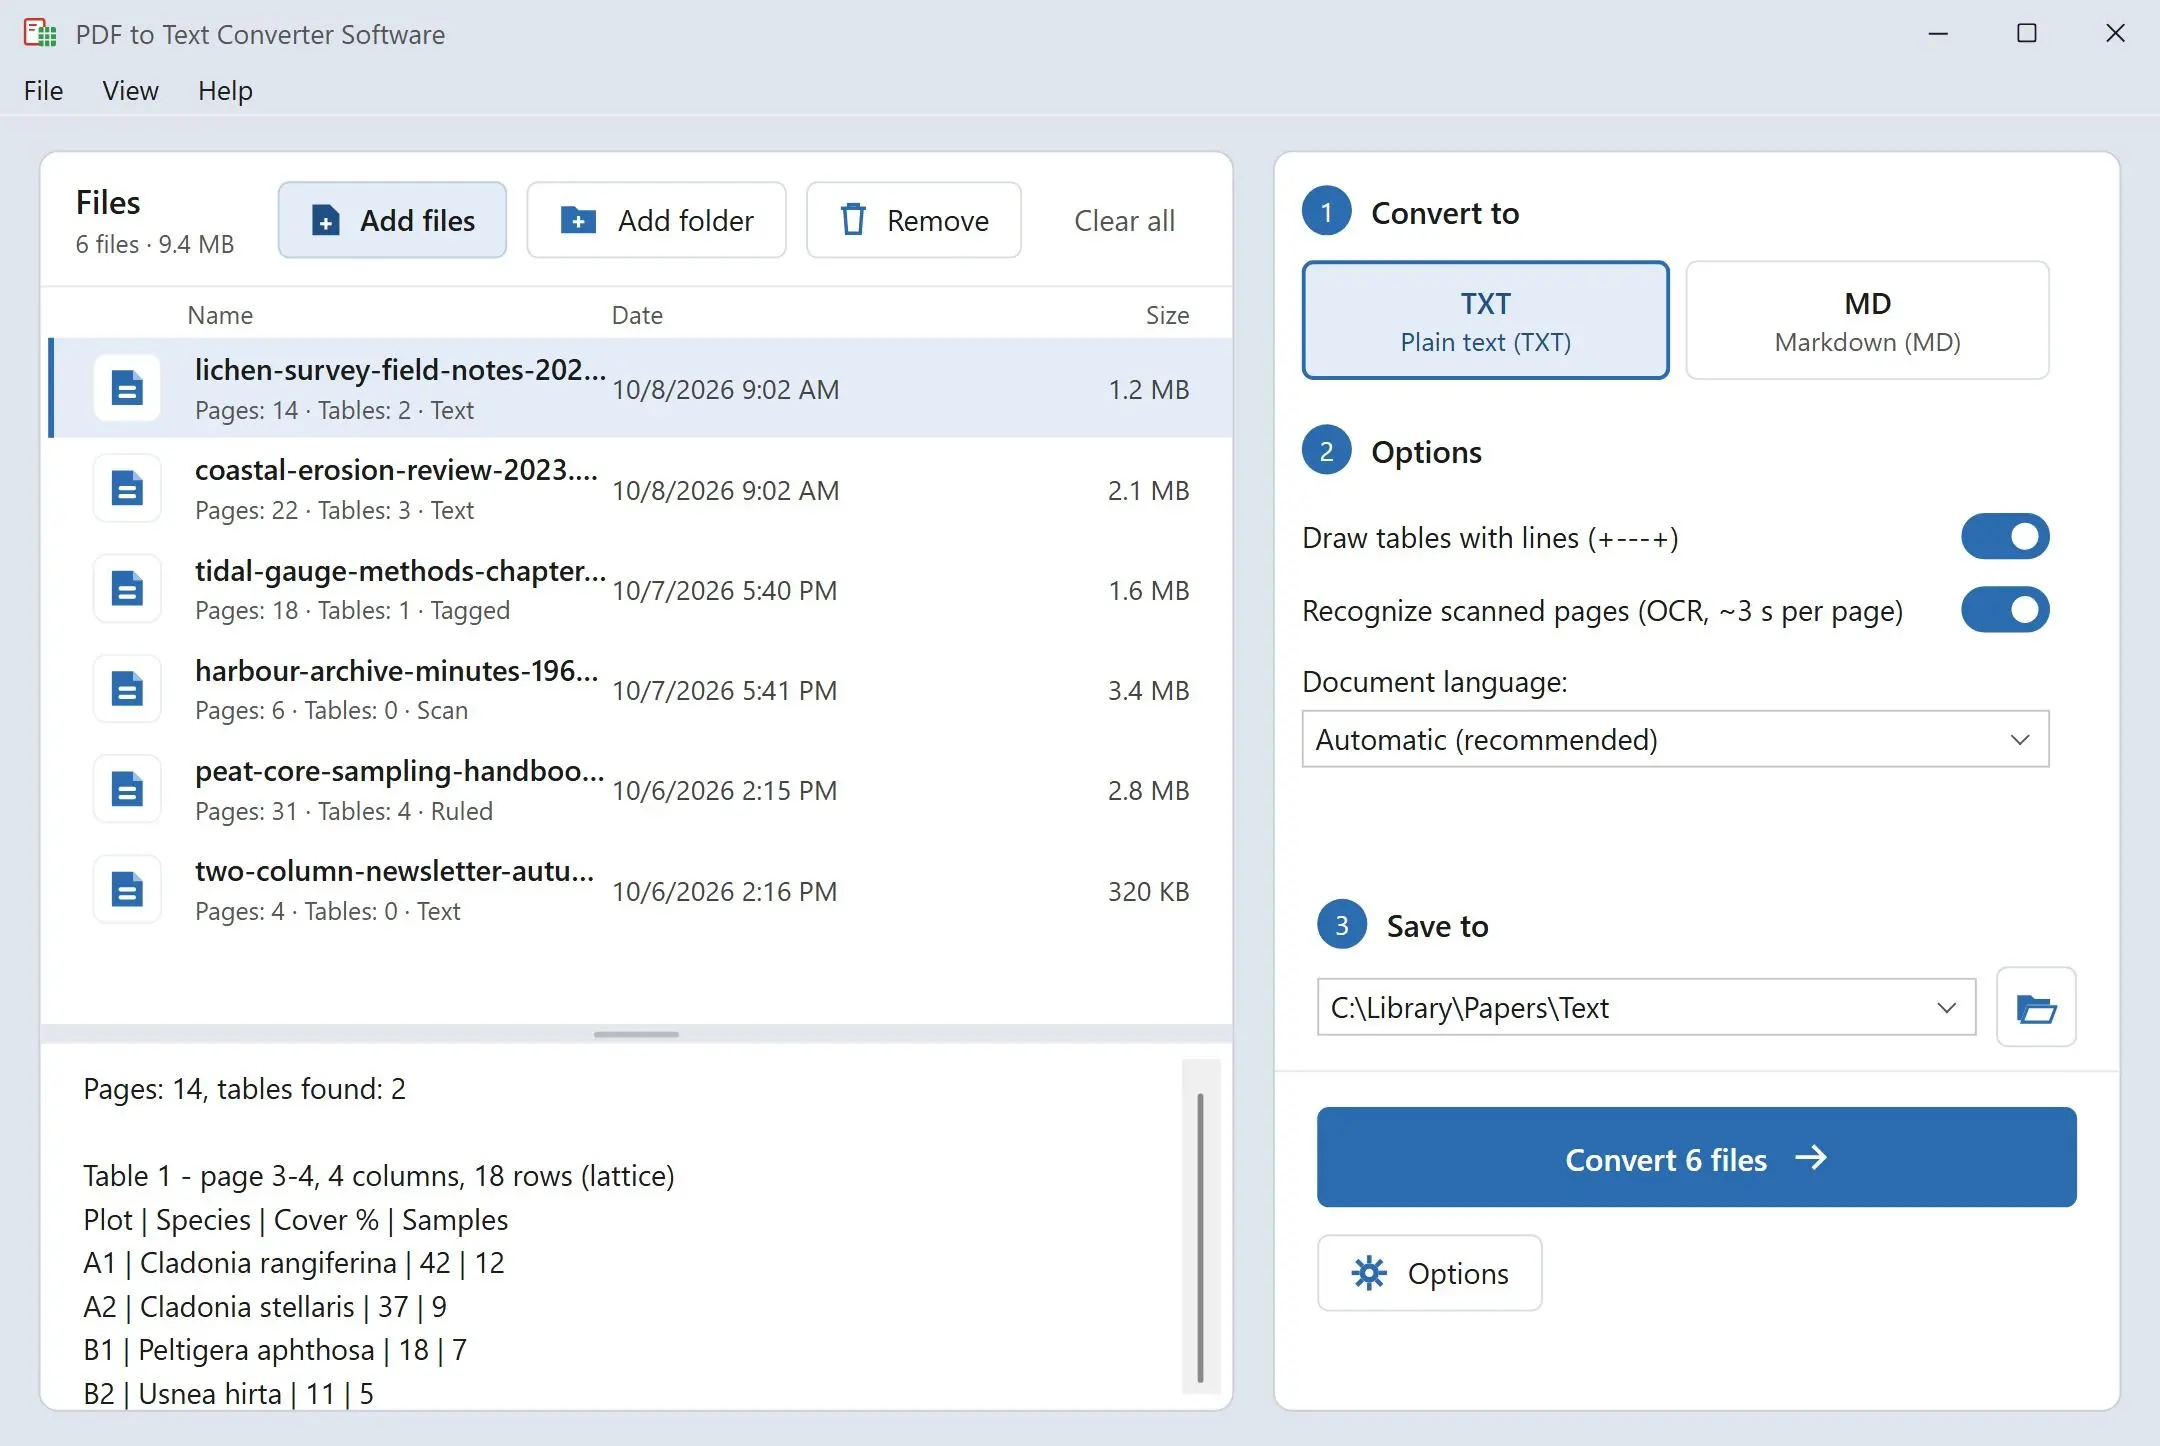
Fügen Sie einen Ordner mit PDFs hinzu und erhalten Sie für jede eine .txt- oder .md-Datei, erzeugt auf Ihrem eigenen Windows-PC. Spalten erscheinen in der Reihenfolge, in der Sie sie lesen würden, und Tabellen halten jede Zahl unter der richtigen Überschrift.
Die Worte aus einer PDF zu holen sollte keinen Nachmittag dauern
Alles markieren im PDF-Viewer, in den Editor einfügen, und aus einem zweispaltigen Aufsatz werden Zeilen, die mitten im Satz zwischen den Spalten springen, während eine Tabelle zu einer Zahlenkette ohne jede Zuordnung zusammenfällt. Websites machen es besser, aber Datei für Datei, und behalten Ihre Datei eine Zeit lang auf ihrem Server. Dieses Programm verarbeitet einen ganzen Ordner in einem Rutsch: Es liest jede PDF auf Ihrem Rechner und schreibt reinen Text, den Sie lesen, durchsuchen und zitieren können.
How to use it
Dateien oder einen Ordner hinzufügen
Ziehen Sie einzelne PDFs oder einen ganzen Ordner in die Liste. Speichern Sie die Ausgabe neben jedem Original oder in einem Ordner Ihrer Wahl. Zwei gleichnamige Dateien aus verschiedenen Ordnern erhalten getrennte Ausgaben, sodass nichts versehentlich überschrieben wird.
Reinen Text oder Markdown wählen
Reiner Text ist UTF-8 mit Windows-Zeilenenden und einem Seitenvorschub (form feed) zwischen den Seiten. Tabellen werden standardmäßig mit +---+-Linien umrahmt; schalten Sie das aus, und die Spalten werden stattdessen mit Leerzeichen ausgerichtet. Markdown macht aus Titeln #-Überschriften und aus Tabellen Pipe-Tabellen.
Stapel starten und die Ergebnisse durchsuchen
Ein Start deckt die ganze Liste ab. Nach dem Ende sagt Ihnen eine Zusammenfassung, wie viele Dateien geschrieben wurden und wo. Richten Sie die Windows-Suche, Ihren Editor oder grep auf diesen Ordner und suchen Sie jede Wendung in allen Dokumenten gleichzeitig.
Benefits
Spalten werden so gelesen, wie ein Mensch sie liest
Auf einer zweispaltigen Zeitschriftenseite wird zuerst die ganze linke Spalte geschrieben, dann die ganze rechte. Sätze bleiben am Stück, und Abschnittstitel werden an ihrer Größe erkannt, sodass sie nicht mitten in einem Absatz landen.
Tabellen, die Sie im Editor lesen können
Eine Preisliste oder ein Laborbericht behält ihr Raster: Jede Zahl bleibt unter ihrer Spaltenüberschrift, umrahmt mit einfachen Zeichen, die jeder Texteditor darstellen kann. Nur echte Tabellen bekommen ein Raster, eine zweispaltig gesetzte Textseite bleibt also Text.
Nichts verlässt Ihren PC
Die PDF-Engine läuft aus dem Programmordner auf Ihrem eigenen Rechner. Es gibt keinen Upload, kein Konto und keine Netzwerkverbindung, sodass Verträge, Krankenakten und unveröffentlichte Manuskripte dort bleiben, wo sie sind.
Warum Leute es benutzen
Auch gescannte Seiten werden erkannt
Eine Seite, die nur ein Bild von Papier ist, durchläuft auf Ihrem PC eine Texterkennung, mit etwa 3 Sekunden pro Seite. Sie deckt lateinische und kyrillische Schriften ab und benötigt 64-Bit-Windows. Seiten, die bereits eine Textebene haben, werden unverändert übernommen, und Tabellen auf einem Scan erscheinen in Spalten ausgerichtet, aber ohne Raster.
Bereit für Notiz-Apps und KI-Assistenten
Die Markdown-Ausgabe lässt sich ohne Nachbearbeitung direkt in eine Notiz-App, ein Wiki oder einen Chat mit einem KI-Assistenten übernehmen. Überschriften von # bis ###### folgen der Größe der Titel im Dokument, und Tabellen werden zu Pipe-Tabellen mit der ersten Zeile als Kopfzeile.
Text in vielen Sprachen
PDFs mit Textebene in Chinesisch, Japanisch oder Koreanisch ergeben lesbaren Text, und hebräische und arabische Zeilen behalten ihre Schreibrichtung von rechts nach links. Alles wird als UTF-8 gespeichert, die Datei öffnet sich also in jedem modernen Editor korrekt.
FAQ
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note