Bulk PDF Text Extractor
Todos los PDF de la carpeta, como texto en el que puedes buscar
Convierte archivos PDF a texto sin formato o Markdown por lotes y totalmente sin conexión. Las páginas de varias columnas conservan su orden de lectura y las tablas se dibujan como cuadrículas de texto. Prueba gratuita.
Full seller details: Legal information.
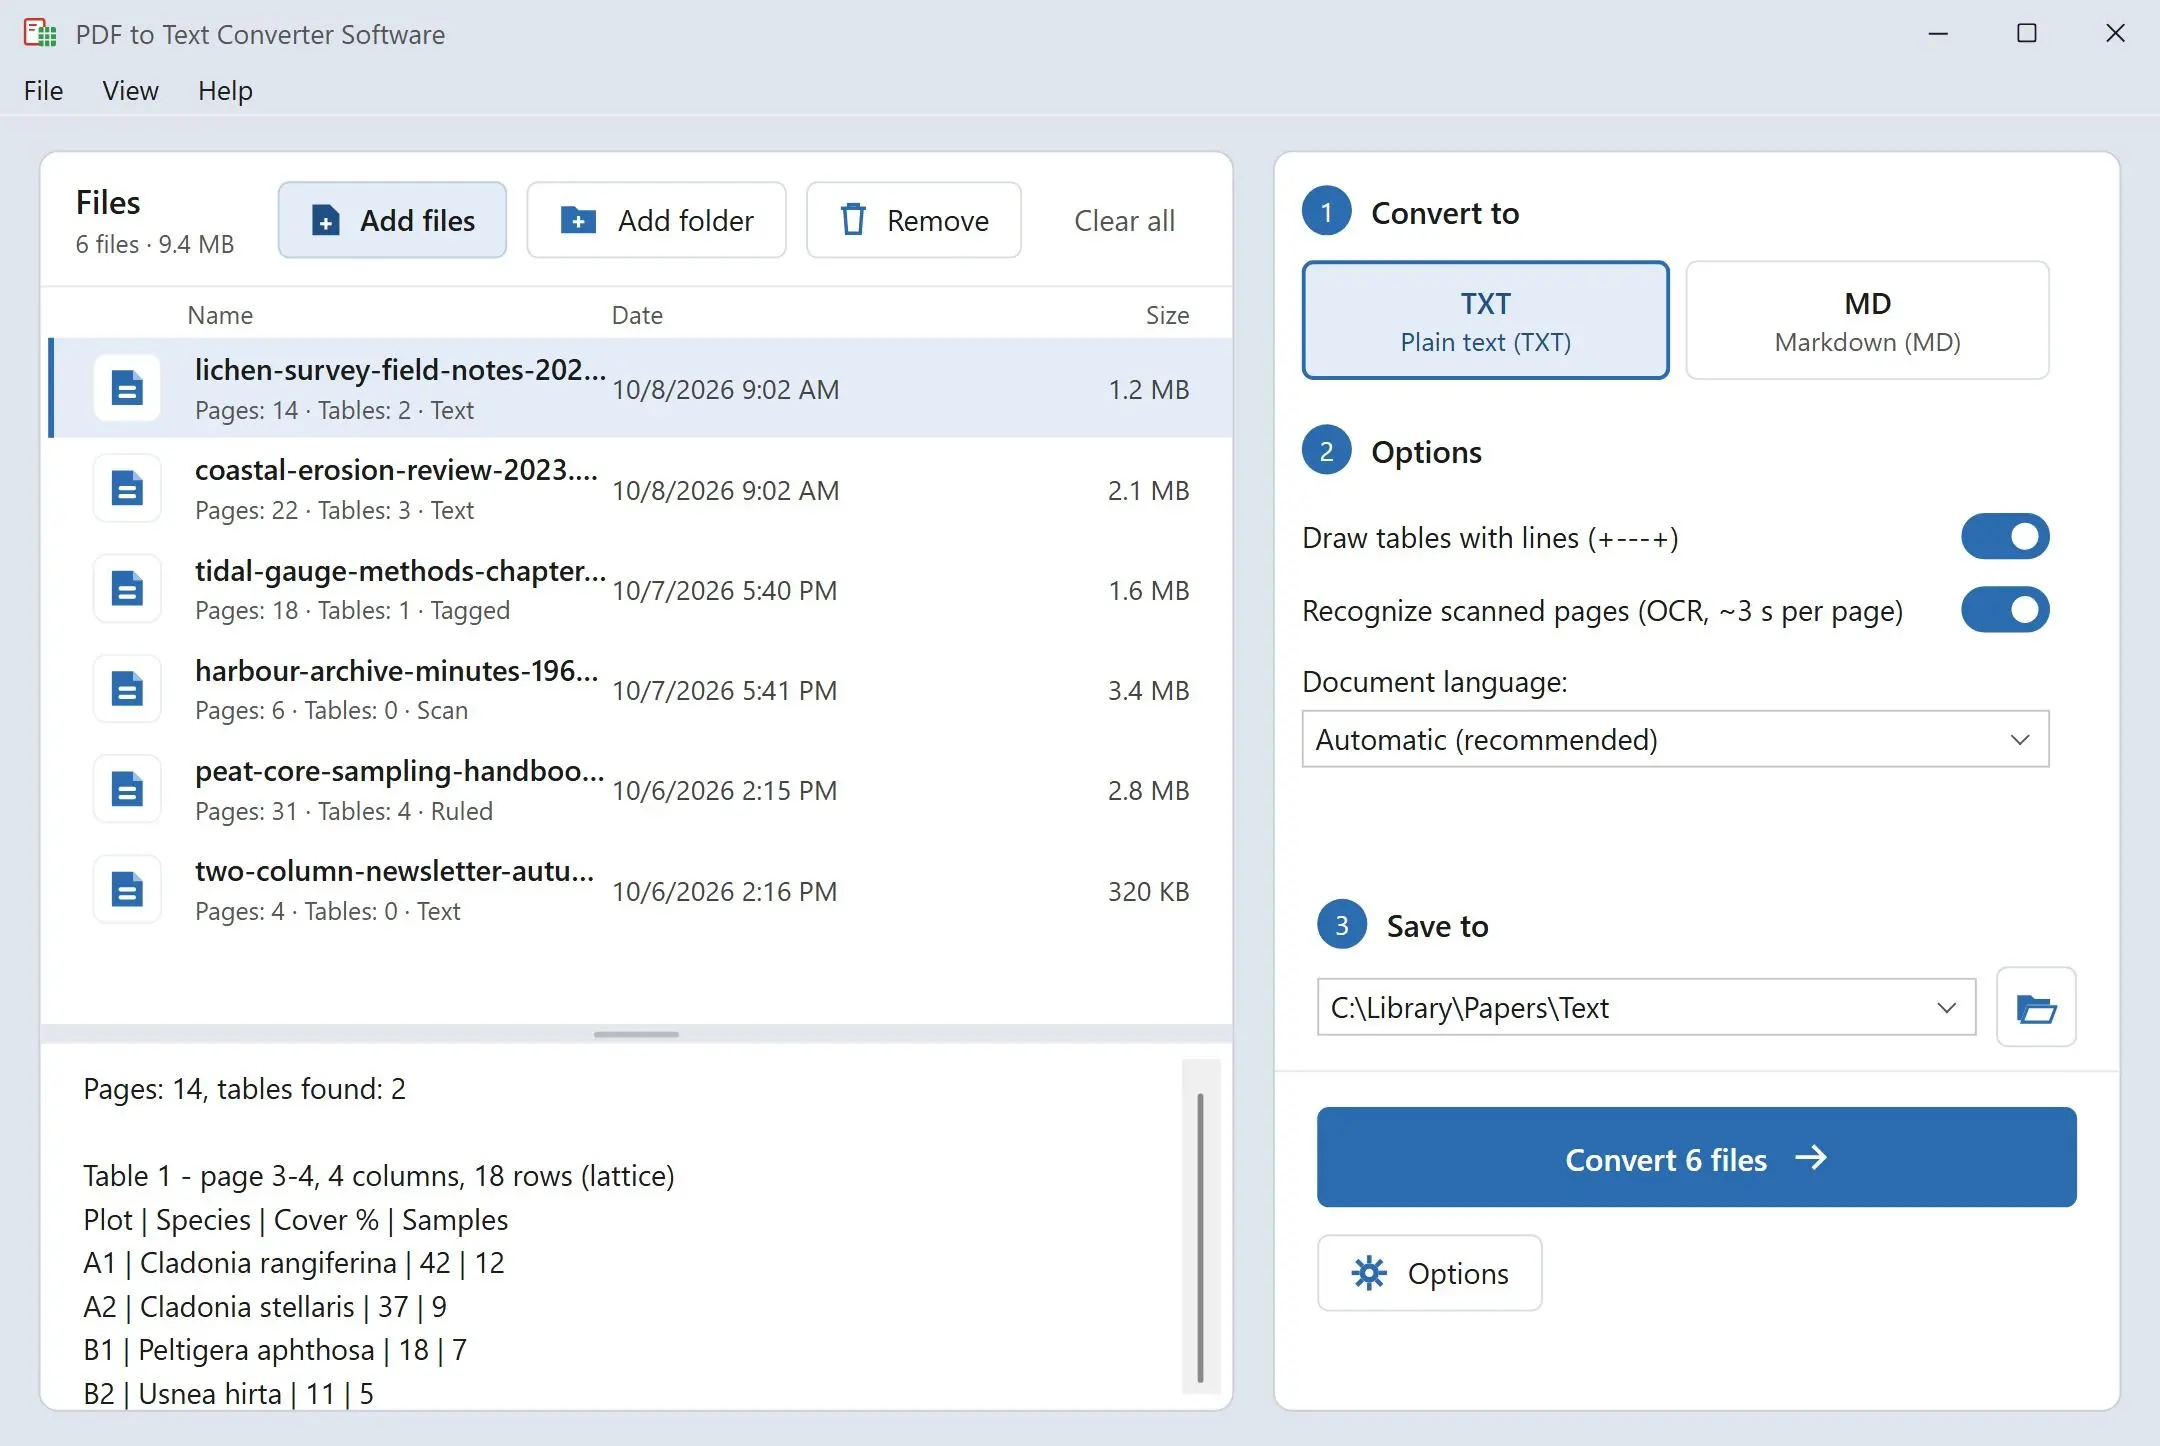
Añade una carpeta de PDF y obtén un archivo .txt o .md por cada uno, escrito en tu propio PC con Windows. Las columnas salen en el orden en que las leerías y las tablas mantienen cada cifra bajo su encabezado correcto.
Sacar las palabras de un PDF no debería llevar una tarde
Selecciona todo en un visor de PDF, pégalo en el Bloc de notas y un artículo a dos columnas se convierte en líneas que saltan de una columna a otra en mitad de la frase, mientras una tabla se reduce a una cadena de números sin nada que los distinga. Los sitios web lo hacen mejor, pero de uno en uno, y guardan tu archivo en su servidor durante un tiempo. Este programa procesa una carpeta entera de una vez: lee cada PDF en tu equipo y escribe texto sin formato que puedes leer, buscar y citar.
How to use it
Añade archivos o una carpeta
Arrastra PDF sueltos o una carpeta entera a la lista. Guarda la salida junto a cada original o en una única carpeta que elijas. Dos archivos con el mismo nombre de carpetas distintas generan salidas separadas, así que no se sobrescribe nada por accidente.
Elige texto sin formato o Markdown
El texto sin formato es UTF-8 con saltos de línea de Windows y un salto de página (form feed) entre páginas. Las tablas se enmarcan por defecto con líneas +---+; desactívalo y las columnas se alinean con espacios. Markdown convierte los títulos en encabezados # y las tablas en tablas con barras verticales.
Inicia el lote y busca en los resultados
Un solo inicio cubre toda la lista. Al terminar, un resumen te indica cuántos archivos se escribieron y dónde. Apunta la búsqueda de Windows, tu editor o grep a esa carpeta y busca cualquier frase en todos los documentos a la vez.
Benefits
Las columnas se leen como las lee una persona
En la página de una revista a dos columnas se escribe primero toda la columna izquierda y después toda la derecha. Las frases se mantienen enteras y los títulos de sección se reconocen por su tamaño, de modo que no acaban en medio de un párrafo.
Tablas que puedes leer en el Bloc de notas
Una lista de precios o un informe de laboratorio conserva su cuadrícula: cada cifra permanece bajo el encabezado de su columna, enmarcada con caracteres sencillos que cualquier editor de texto puede mostrar. Solo las tablas reales reciben cuadrícula, así que una página de prosa a dos columnas sigue siendo prosa.
Nada sale de tu PC
El motor de PDF se ejecuta desde la carpeta del programa en tu propio equipo. No interviene ninguna subida, cuenta ni conexión de red, así que los contratos, los historiales médicos y los manuscritos inéditos se quedan donde están.
Por qué la gente lo usa
También se reconocen las páginas escaneadas
Una página que es solo una imagen del papel pasa por reconocimiento de texto en tu PC, a unos 3 segundos por página. Cubre alfabetos latino y cirílico y requiere Windows de 64 bits. Las páginas que ya tienen capa de texto se toman tal cual, y las tablas de un escaneo salen espaciadas en columnas sin la cuadrícula.
Listo para aplicaciones de notas y asistentes de IA
La salida en Markdown va directa a una aplicación de notas, un wiki o un chat con un asistente de IA sin limpieza. Los encabezados de # a ###### siguen el tamaño de los títulos del documento, y las tablas se convierten en tablas con barras verticales con la primera fila como encabezado.
Texto en muchos idiomas
Los PDF con capa de texto en chino, japonés o coreano salen como texto legible, y las líneas en hebreo y árabe mantienen su orden de derecha a izquierda. Todo se guarda como UTF-8, de modo que el archivo se abre correctamente en cualquier editor moderno.
Preguntas frecuentes
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note