Bulk PDF Text Extractor
Hver PDF i mappen, som tekst du kan søge i
Konverter PDF-filer til almindelig tekst eller Markdown i bulk, helt offline. Sider med flere kolonner bevarer læserækkefølgen, og tabeller tegnes som tekstgitre. Gratis prøveperiode.
Full seller details: Legal information.
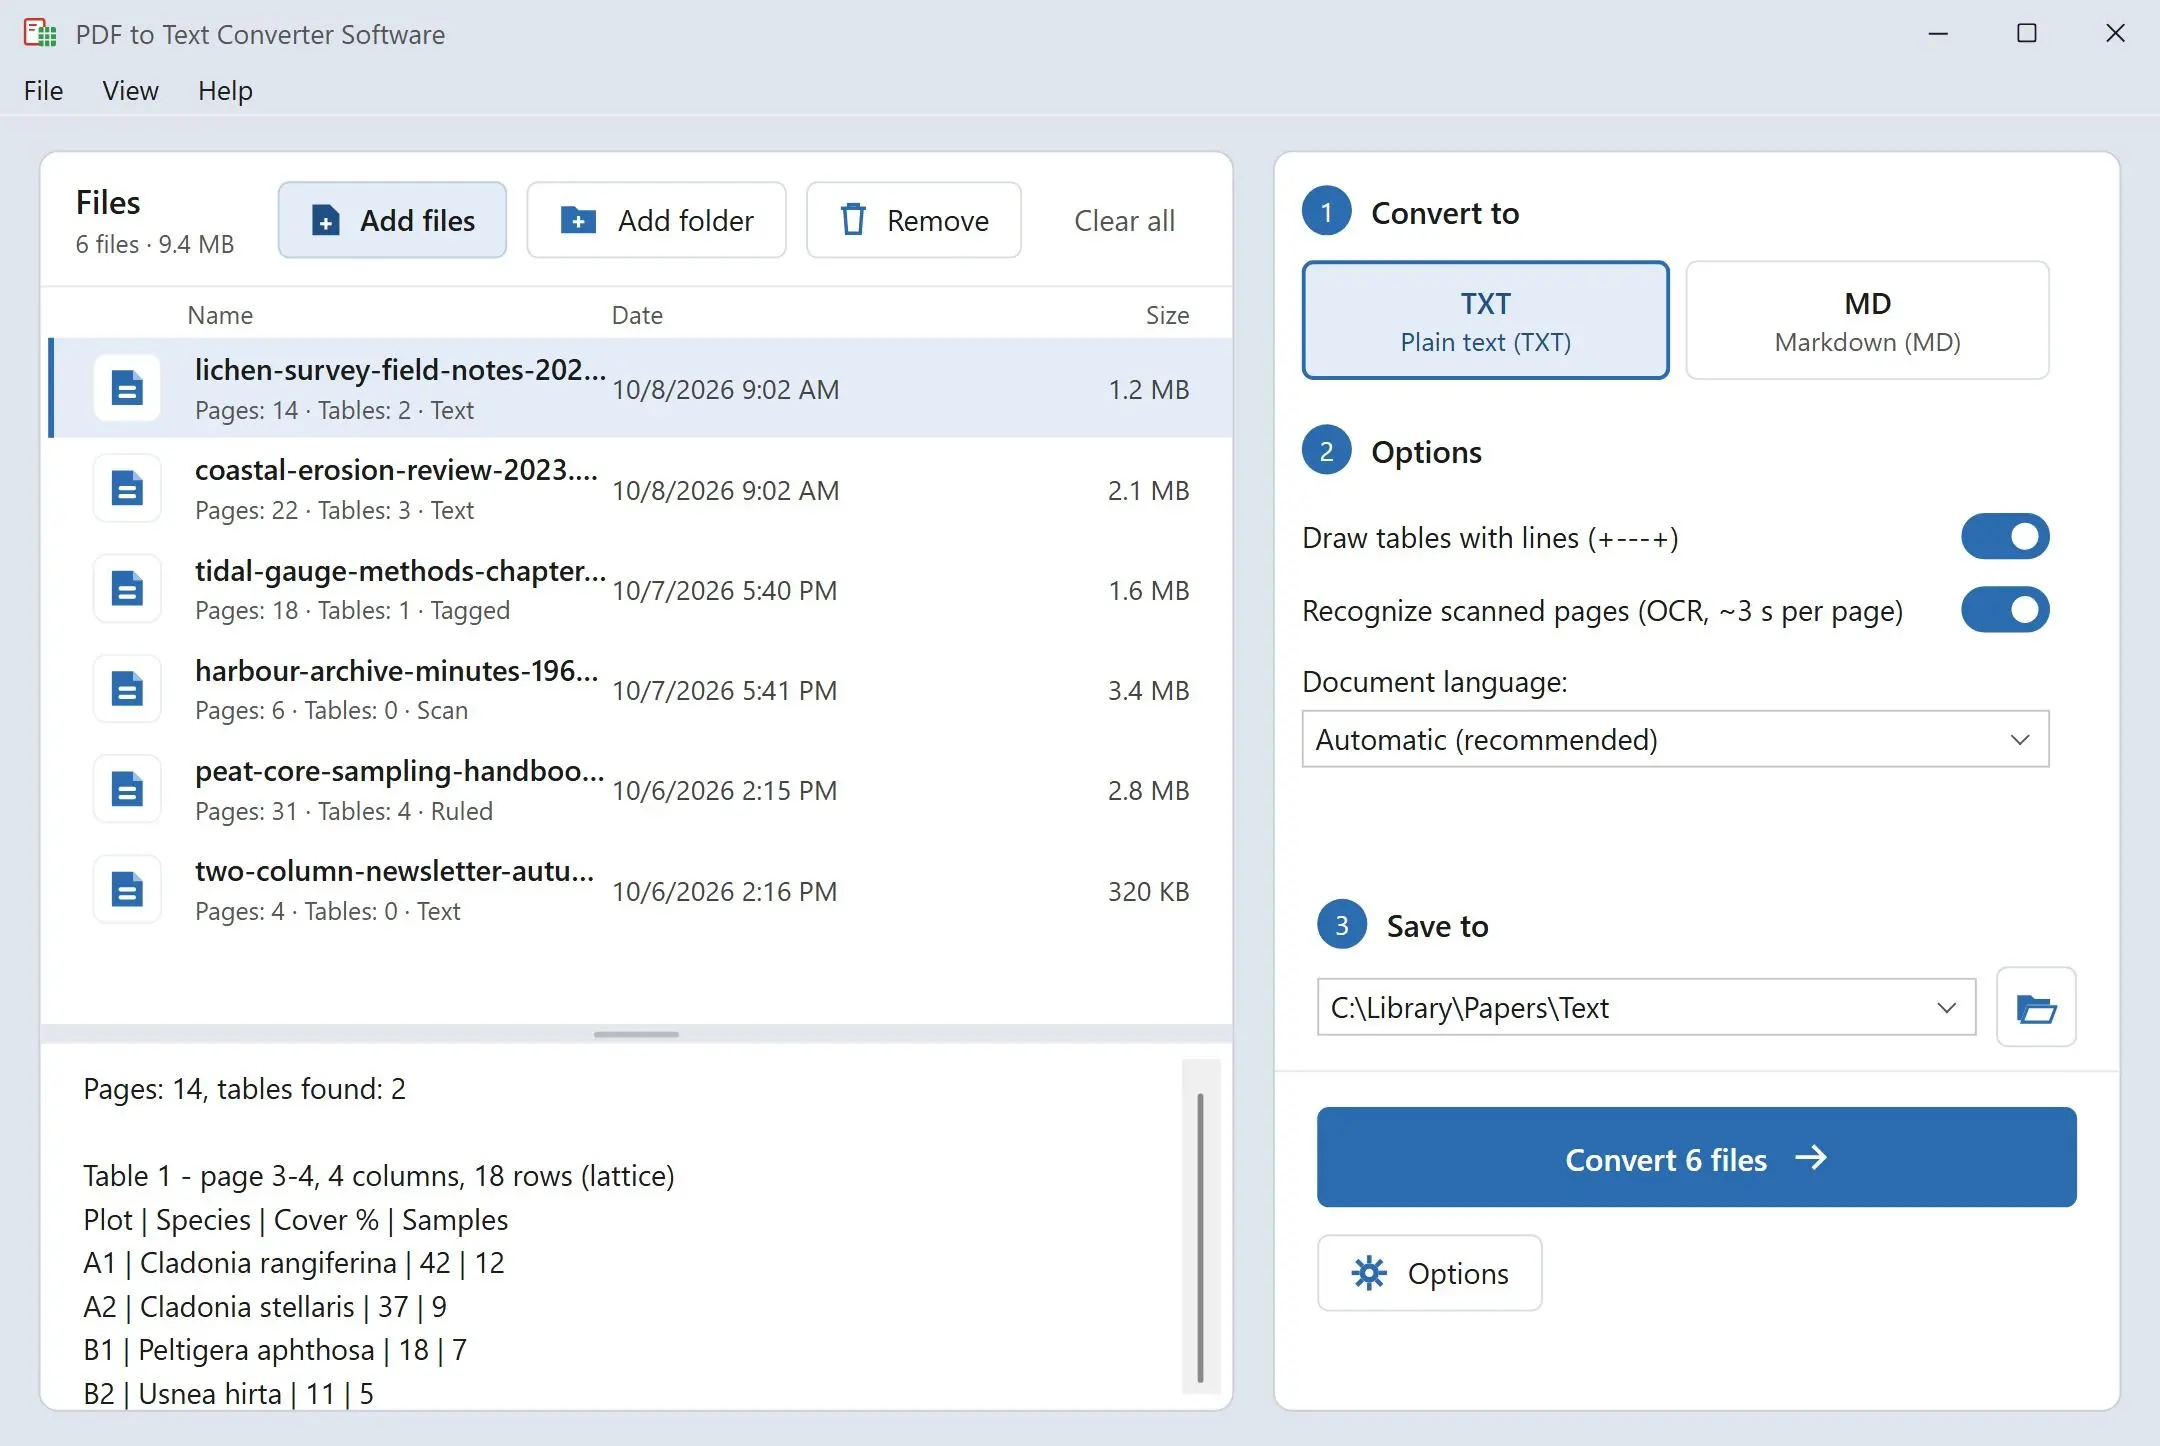
Tilføj en mappe med PDF-filer og få en .txt- eller .md-fil til hver, skrevet på din egen Windows-pc. Kolonner kommer ud i den rækkefølge, du ville læse dem, og tabeller beholder hvert tal under den rette overskrift.
At få ordene ud af en PDF burde ikke tage en eftermiddag
Markér alt i en PDF-læser, indsæt i Notesblok, og en artikel i to kolonner bliver til linjer, der hopper mellem kolonnerne midt i en sætning, mens en tabel falder sammen til en række tal uden noget, der adskiller dem. Hjemmesider gør det bedre, én upload ad gangen, og beholder din fil på deres server et stykke tid. Dette program håndterer en hel mappe i ét hug: det læser hver PDF på din maskine og skriver almindelig tekst, du kan læse, søge i og citere.
How to use it
Tilføj filer eller en mappe
Slip enkelte PDF-filer eller en hel mappe på listen. Gem outputtet ved siden af hver original eller i én mappe, du vælger. To filer med samme navn fra forskellige mapper får hver sit output, så intet overskrives ved et uheld.
Vælg almindelig tekst eller Markdown
Almindelig tekst er UTF-8 med Windows-linjeskift og et form feed mellem siderne. Tabeller indrammes som standard med +---+-linjer; slå det fra, så stilles kolonnerne op med mellemrum i stedet. Markdown gør titler til #-overskrifter og tabeller til pipe-tabeller.
Start bulkkørslen og søg i resultaterne
Ét start dækker hele listen. Når den er færdig, fortæller en oversigt, hvor mange filer der blev skrevet, og hvor. Ret Windows-søgning, din editor eller grep mod den mappe og slå en vilkårlig frase op på tværs af alle dokumenter på én gang.
Benefits
Kolonner læses, som et menneske læser dem
På en tidsskriftside med to kolonner skrives hele venstre kolonne først, derefter hele højre. Sætninger forbliver i ét stykke, og afsnitsoverskrifter genkendes på deres størrelse, så de ikke havner midt i et afsnit.
Tabeller du kan læse i Notesblok
En prisliste eller en laboratorierapport beholder sit gitter: hvert tal bliver under sin kolonneoverskrift, indrammet med almindelige tegn, som enhver teksteditor kan vise. Kun rigtige tabeller får et gitter, så en side med løbende tekst i to kolonner forbliver løbende tekst.
Intet forlader din pc
PDF-motoren kører fra programmappen på din egen maskine. Der er ingen upload, ingen konto og ingen netværksforbindelse involveret, så kontrakter, patientjournaler og upublicerede manuskripter bliver, hvor de er.
Hvorfor folk bruger det
Scannede sider genkendes også
En side, der kun er et billede af papir, kører gennem tekstgenkendelse på din pc, med cirka 3 sekunder pr. side. Det omfatter latinske og kyrilliske skriftsystemer og kræver 64-bit Windows. Sider, der allerede har et tekstlag, tages, som de er, og tabeller på en scanning kommer ud med mellemrum mellem kolonnerne, men uden gitter.
Klar til notesapps og AI-assistenter
Markdown-output går direkte ind i en notesapp, en wiki eller en chat med en AI-assistent uden oprydning. Overskrifter fra # til ###### følger titlernes størrelse i dokumentet, og tabeller bliver til pipe-tabeller med første række som overskrift.
Tekst på mange sprog
PDF-filer med tekstlag på kinesisk, japansk eller koreansk kommer ud som læselig tekst, og hebraiske og arabiske linjer beholder deres højre-til-venstre-rækkefølge. Alt gemmes som UTF-8, så filen åbner korrekt i enhver moderne editor.
FAQ
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note