Bulk PDF Text Extractor
Mọi PDF trong thư mục, thành văn bản có thể tìm kiếm
Chuyển tệp PDF sang văn bản thuần hoặc Markdown hàng loạt, hoàn toàn ngoại tuyến. Trang nhiều cột giữ đúng thứ tự đọc và bảng được vẽ thành lưới văn bản. Dùng thử miễn phí.
Full seller details: Legal information.
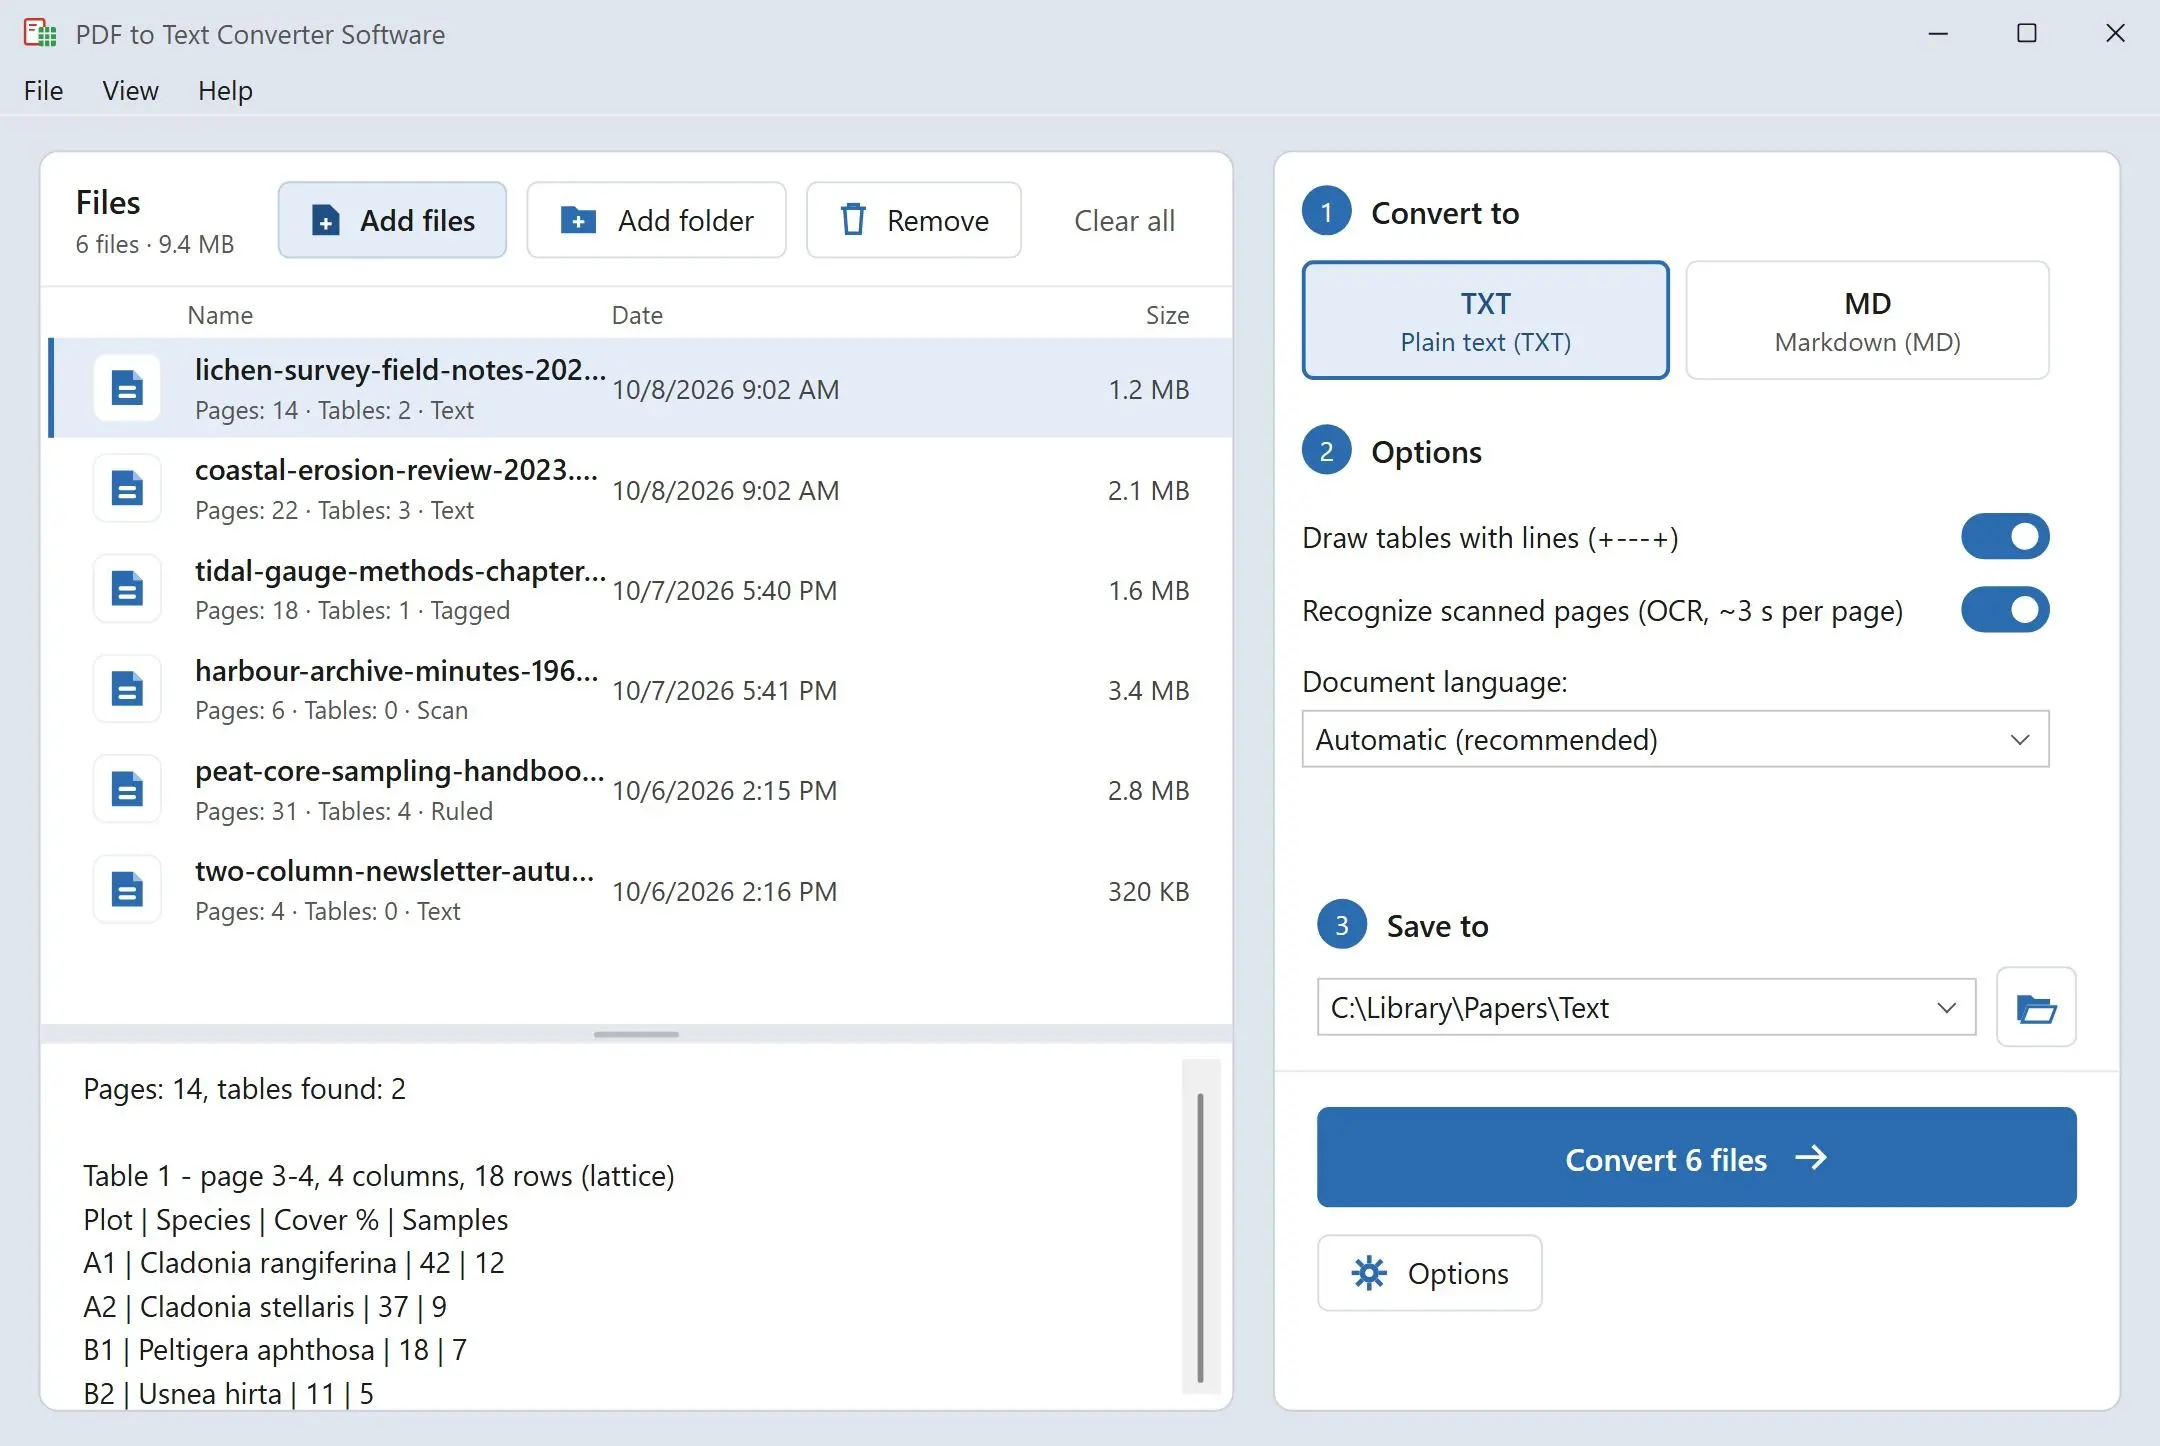
Thêm một thư mục PDF và nhận về mỗi tệp một file .txt hoặc .md, được tạo ngay trên máy tính Windows của bạn. Các cột ra đúng thứ tự bạn sẽ đọc, và bảng giữ mỗi con số dưới đúng tiêu đề.
Lấy chữ ra khỏi PDF không nên mất cả buổi chiều
Chọn tất cả trong trình xem PDF, dán vào Notepad, và bài báo hai cột biến thành những dòng nhảy qua lại giữa các cột ngay giữa câu, còn bảng sụp thành một chuỗi số không còn phân biệt được. Các website làm tốt hơn, nhưng mỗi lần một tệp và giữ tệp của bạn trên máy chủ của họ một thời gian. Chương trình này xử lý cả thư mục trong một lần: nó đọc từng PDF trên máy của bạn và ghi ra văn bản thuần để bạn đọc, tìm kiếm và trích dẫn.
How to use it
Thêm tệp hoặc thư mục
Thả từng PDF hoặc cả thư mục vào danh sách. Lưu đầu ra cạnh mỗi tệp gốc hoặc vào một thư mục bạn chọn. Hai tệp cùng tên từ các thư mục khác nhau được tạo đầu ra riêng, nên không có gì bị ghi đè nhầm.
Chọn văn bản thuần hoặc Markdown
Văn bản thuần là UTF-8 với ký tự xuống dòng của Windows và form feed giữa các trang. Bảng mặc định được bao khung bằng các dòng +---+; tắt tùy chọn đó thì các cột được căn bằng dấu cách. Markdown biến tiêu đề thành đề mục # và bảng thành bảng dùng dấu gạch đứng.
Bắt đầu lô và tìm trong kết quả
Một lần bắt đầu bao quát cả danh sách. Khi xong, phần tóm tắt cho biết đã ghi bao nhiêu tệp và ở đâu. Hãy trỏ tìm kiếm của Windows, trình soạn thảo hoặc grep vào thư mục đó và tra bất kỳ cụm từ nào trên mọi tài liệu cùng lúc.
Benefits
Cột được đọc đúng như người đọc
Trên trang tạp chí hai cột, toàn bộ cột trái được ghi trước, rồi đến toàn bộ cột phải. Câu văn giữ nguyên vẹn, và tiêu đề mục được nhận diện theo kích thước, nên chúng không rơi vào giữa đoạn văn.
Bảng có thể đọc ngay trong Notepad
Bảng giá hay báo cáo xét nghiệm giữ nguyên lưới của nó: mỗi con số nằm dưới tiêu đề cột, được bao khung bằng ký tự thường mà bất kỳ trình soạn thảo văn bản nào cũng hiển thị được. Chỉ bảng thật mới có lưới, nên trang văn xuôi chia hai cột vẫn là văn xuôi.
Không có gì rời khỏi máy tính của bạn
Bộ xử lý PDF chạy từ thư mục chương trình trên chính máy của bạn. Không có tải lên, không có tài khoản và không cần kết nối mạng, nên hợp đồng, hồ sơ y tế và bản thảo chưa xuất bản ở nguyên chỗ cũ.
Tại sao mọi người sử dụng nó
Trang quét cũng được nhận dạng
Trang chỉ là ảnh chụp giấy sẽ đi qua nhận dạng văn bản ngay trên máy, khoảng 3 giây mỗi trang. Nó hỗ trợ chữ Latin và Cyrillic và cần Windows 64-bit. Trang đã có lớp văn bản được lấy nguyên trạng, và bảng trên bản quét ra thành các cột cách bằng dấu cách, không có lưới.
Sẵn sàng cho ứng dụng ghi chú và trợ lý AI
Đầu ra Markdown đi thẳng vào ứng dụng ghi chú, wiki hoặc cuộc trò chuyện với trợ lý AI mà không cần dọn dẹp. Đề mục từ # đến ###### theo kích thước tiêu đề trong tài liệu, và bảng thành bảng dùng gạch đứng với hàng đầu là tiêu đề.
Văn bản nhiều ngôn ngữ
PDF có lớp văn bản tiếng Trung, Nhật hoặc Hàn ra thành văn bản đọc được, và các dòng tiếng Do Thái và Ả Rập giữ thứ tự từ phải sang trái. Mọi thứ được lưu dưới dạng UTF-8, nên tệp mở đúng trong bất kỳ trình soạn thảo hiện đại nào.
Câu hỏi thường gặp
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note