Bulk PDF Text Extractor
Elke PDF in de map, als doorzoekbare tekst
Zet PDF-bestanden in batch om naar platte tekst of Markdown, volledig offline. Pagina's met meerdere kolommen behouden hun leesvolgorde en tabellen worden als tekstrasters getekend. Gratis proefversie.
Full seller details: Legal information.
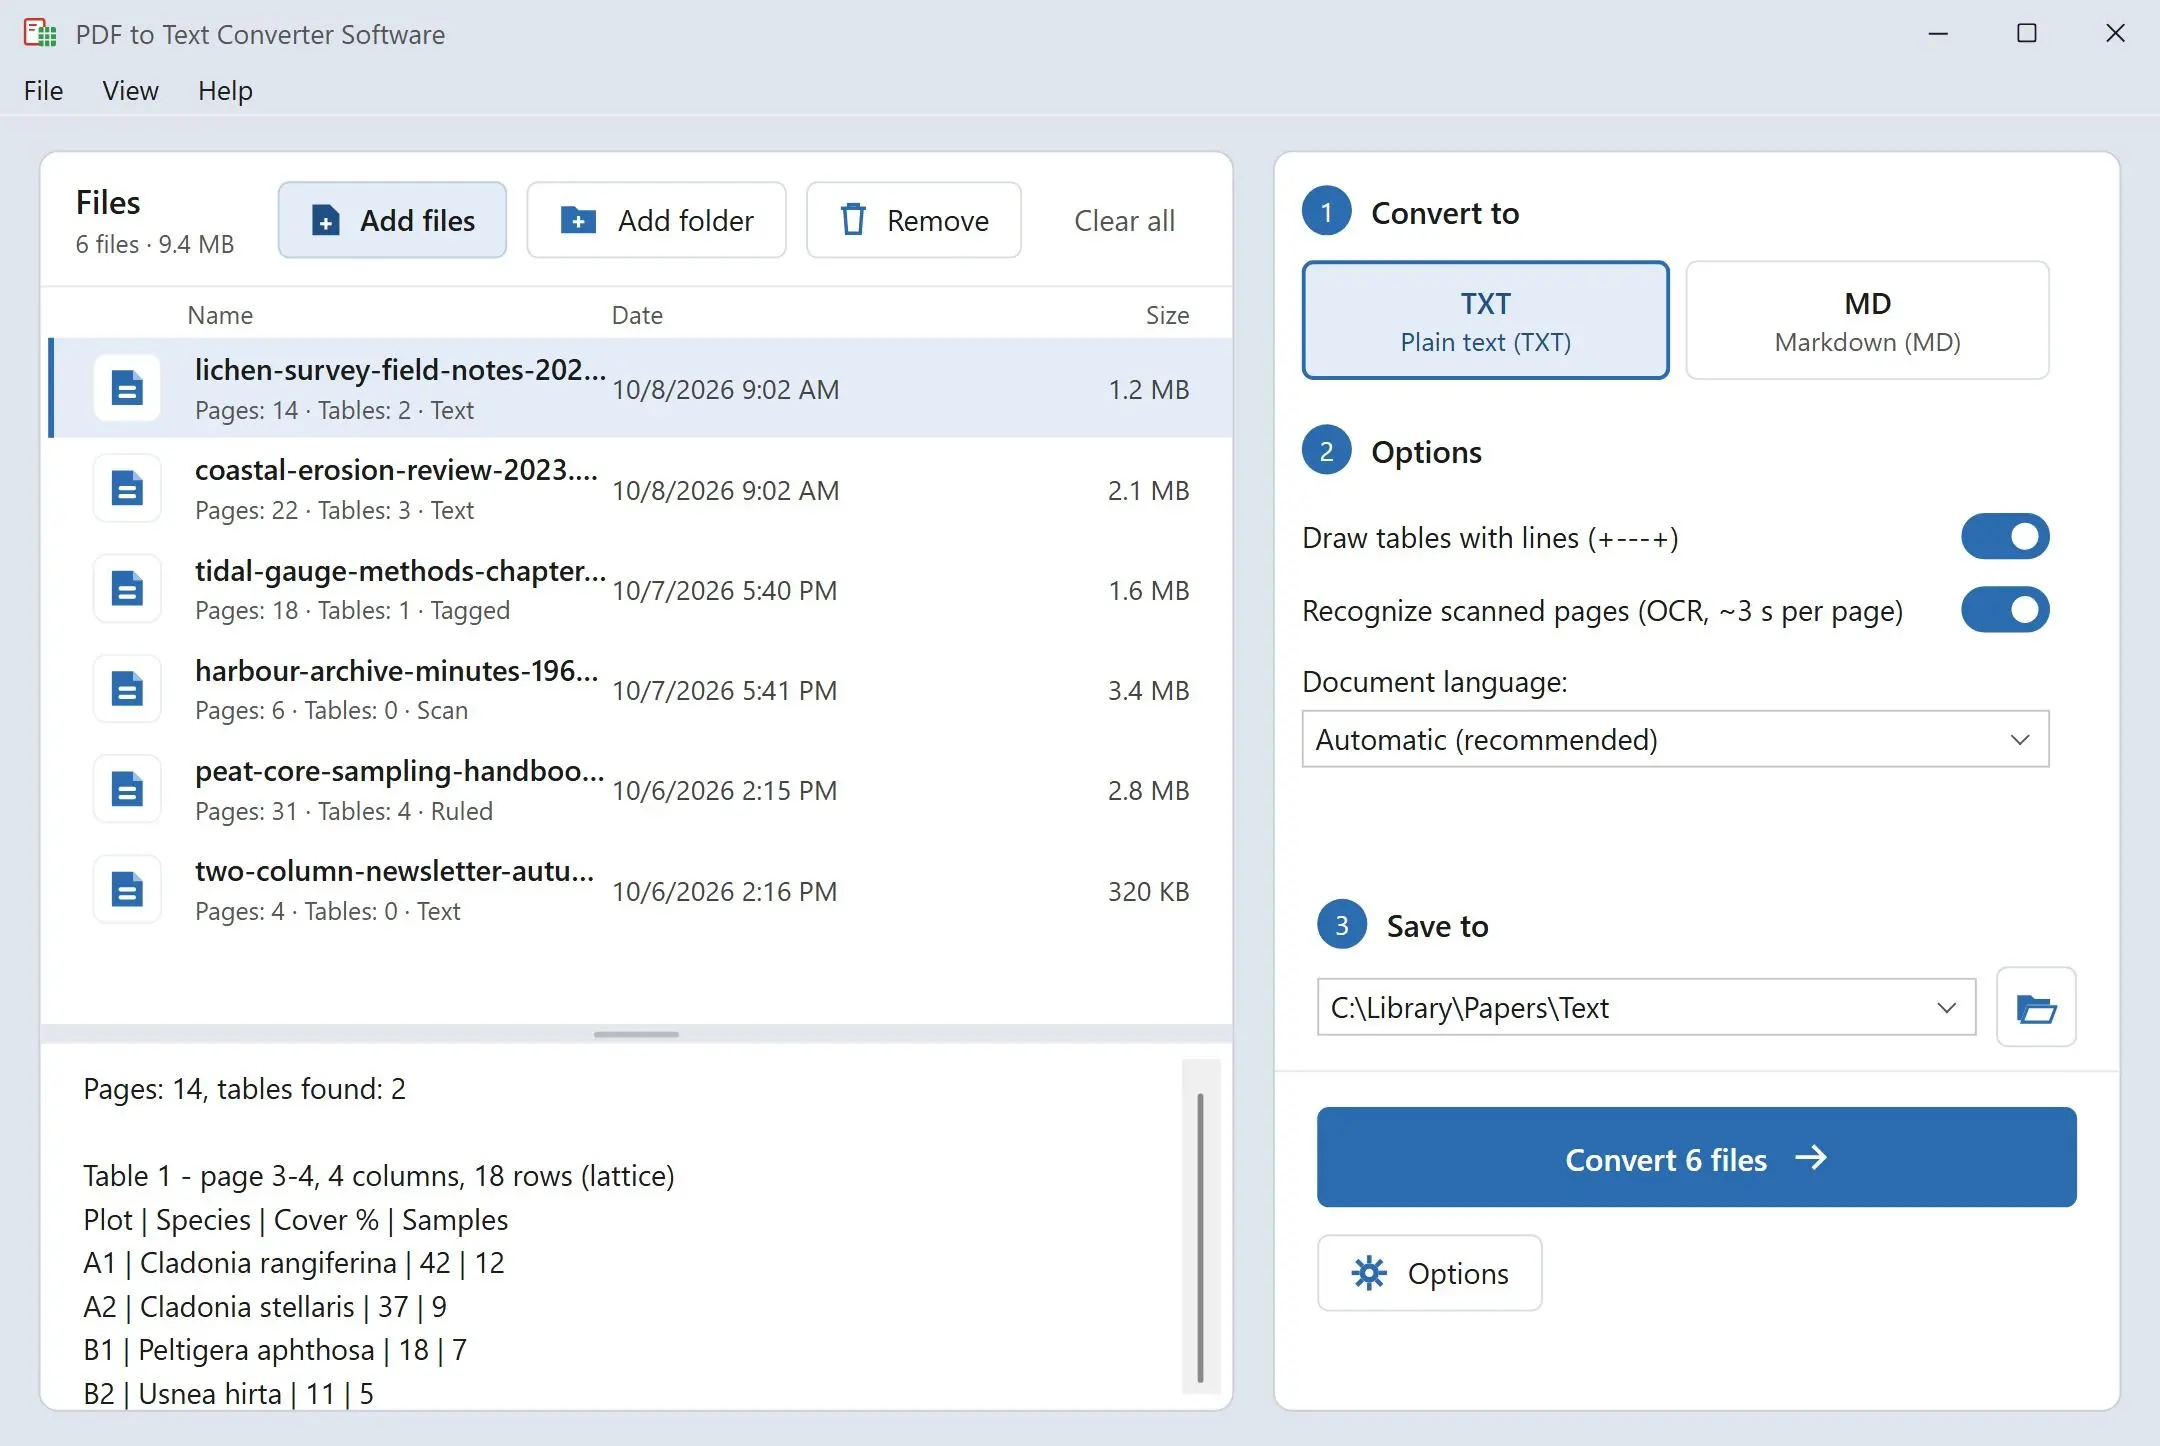
Voeg een map met PDF's toe en krijg voor elk een .txt- of .md-bestand, geschreven op je eigen Windows-pc. Kolommen komen eruit in de volgorde waarin je ze zou lezen, en tabellen houden elk cijfer onder de juiste kop.
De woorden uit een PDF halen zou geen middag moeten kosten
Selecteer alles in een PDF-viewer, plak het in Kladblok, en een artikel met twee kolommen wordt regels die midden in de zin tussen kolommen springen, terwijl een tabel instort tot een reeks getallen zonder iets om ze uit elkaar te houden. Websites doen het beter, één upload tegelijk, en bewaren je bestand een tijdje op hun server. Dit programma verwerkt een hele map in één keer: het leest elke PDF op je computer en schrijft platte tekst die je kunt lezen, doorzoeken en citeren.
How to use it
Voeg bestanden of een map toe
Sleep losse PDF's of een hele map naar de lijst. Sla de uitvoer op naast elk origineel of in één map naar keuze. Twee bestanden met dezelfde naam uit verschillende mappen krijgen aparte uitvoer, dus er wordt niets per ongeluk overschreven.
Kies platte tekst of Markdown
Platte tekst is UTF-8 met Windows-regeleinden en een form feed tussen pagina's. Tabellen worden standaard omlijnd met +---+-regels; schakel dat uit en de kolommen worden met spaties uitgelijnd. Markdown maakt van titels #-koppen en van tabellen tabellen met verticale streepjes.
Start de batch en doorzoek de resultaten
Eén start dekt de hele lijst. Als het klaar is, vertelt een overzicht hoeveel bestanden zijn geschreven en waar. Richt Windows-zoeken, je editor of grep op die map en zoek een willekeurige zin in alle documenten tegelijk.
Benefits
Kolommen gelezen zoals een mens ze leest
Op een tijdschriftpagina met twee kolommen wordt eerst de hele linkerkolom geschreven, daarna de hele rechter. Zinnen blijven heel, en sectiekoppen worden herkend aan hun grootte, dus ze belanden niet midden in een alinea.
Tabellen die je in Kladblok kunt lezen
Een prijslijst of laboratoriumrapport behoudt zijn raster: elk cijfer blijft onder zijn kolomkop, omlijnd met gewone tekens die elke teksteditor kan tonen. Alleen echte tabellen krijgen een raster, dus een pagina proza in twee kolommen blijft proza.
Niets verlaat je pc
De PDF-engine draait vanuit de programmamap op je eigen computer. Er is geen upload, geen account en geen netwerkverbinding bij betrokken, dus contracten, medische dossiers en ongepubliceerde manuscripten blijven waar ze zijn.
Waarom mensen het gebruiken
Gescande pagina's worden ook herkend
Een pagina die alleen een afbeelding van papier is, gaat op je pc door tekstherkenning, met ongeveer 3 seconden per pagina. Het dekt Latijnse en Cyrillische schriften en vereist 64-bits Windows. Pagina's die al een tekstlaag hebben worden overgenomen zoals ze zijn, en tabellen op een scan komen eruit met spaties in kolommen, zonder raster.
Klaar voor notitie-apps en AI-assistenten
Markdown-uitvoer kan zonder opschonen rechtstreeks in een notitie-app, een wiki of een chat met een AI-assistent. Koppen van # tot ###### volgen de grootte van de titels in het document, en tabellen worden tabellen met verticale streepjes met de eerste rij als kop.
Tekst in veel talen
PDF's met een tekstlaag in Chinees, Japans of Koreaans komen eruit als leesbare tekst, en Hebreeuwse en Arabische regels behouden hun volgorde van rechts naar links. Alles wordt opgeslagen als UTF-8, dus het bestand opent correct in elke moderne editor.
FAQ
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note