Bulk PDF Text Extractor
Ogni PDF della cartella, come testo in cui cercare
Converti file PDF in testo semplice o Markdown in blocco, completamente offline. Le pagine a più colonne mantengono l'ordine di lettura e le tabelle sono disegnate come griglie di testo. Prova gratuita.
Full seller details: Legal information.
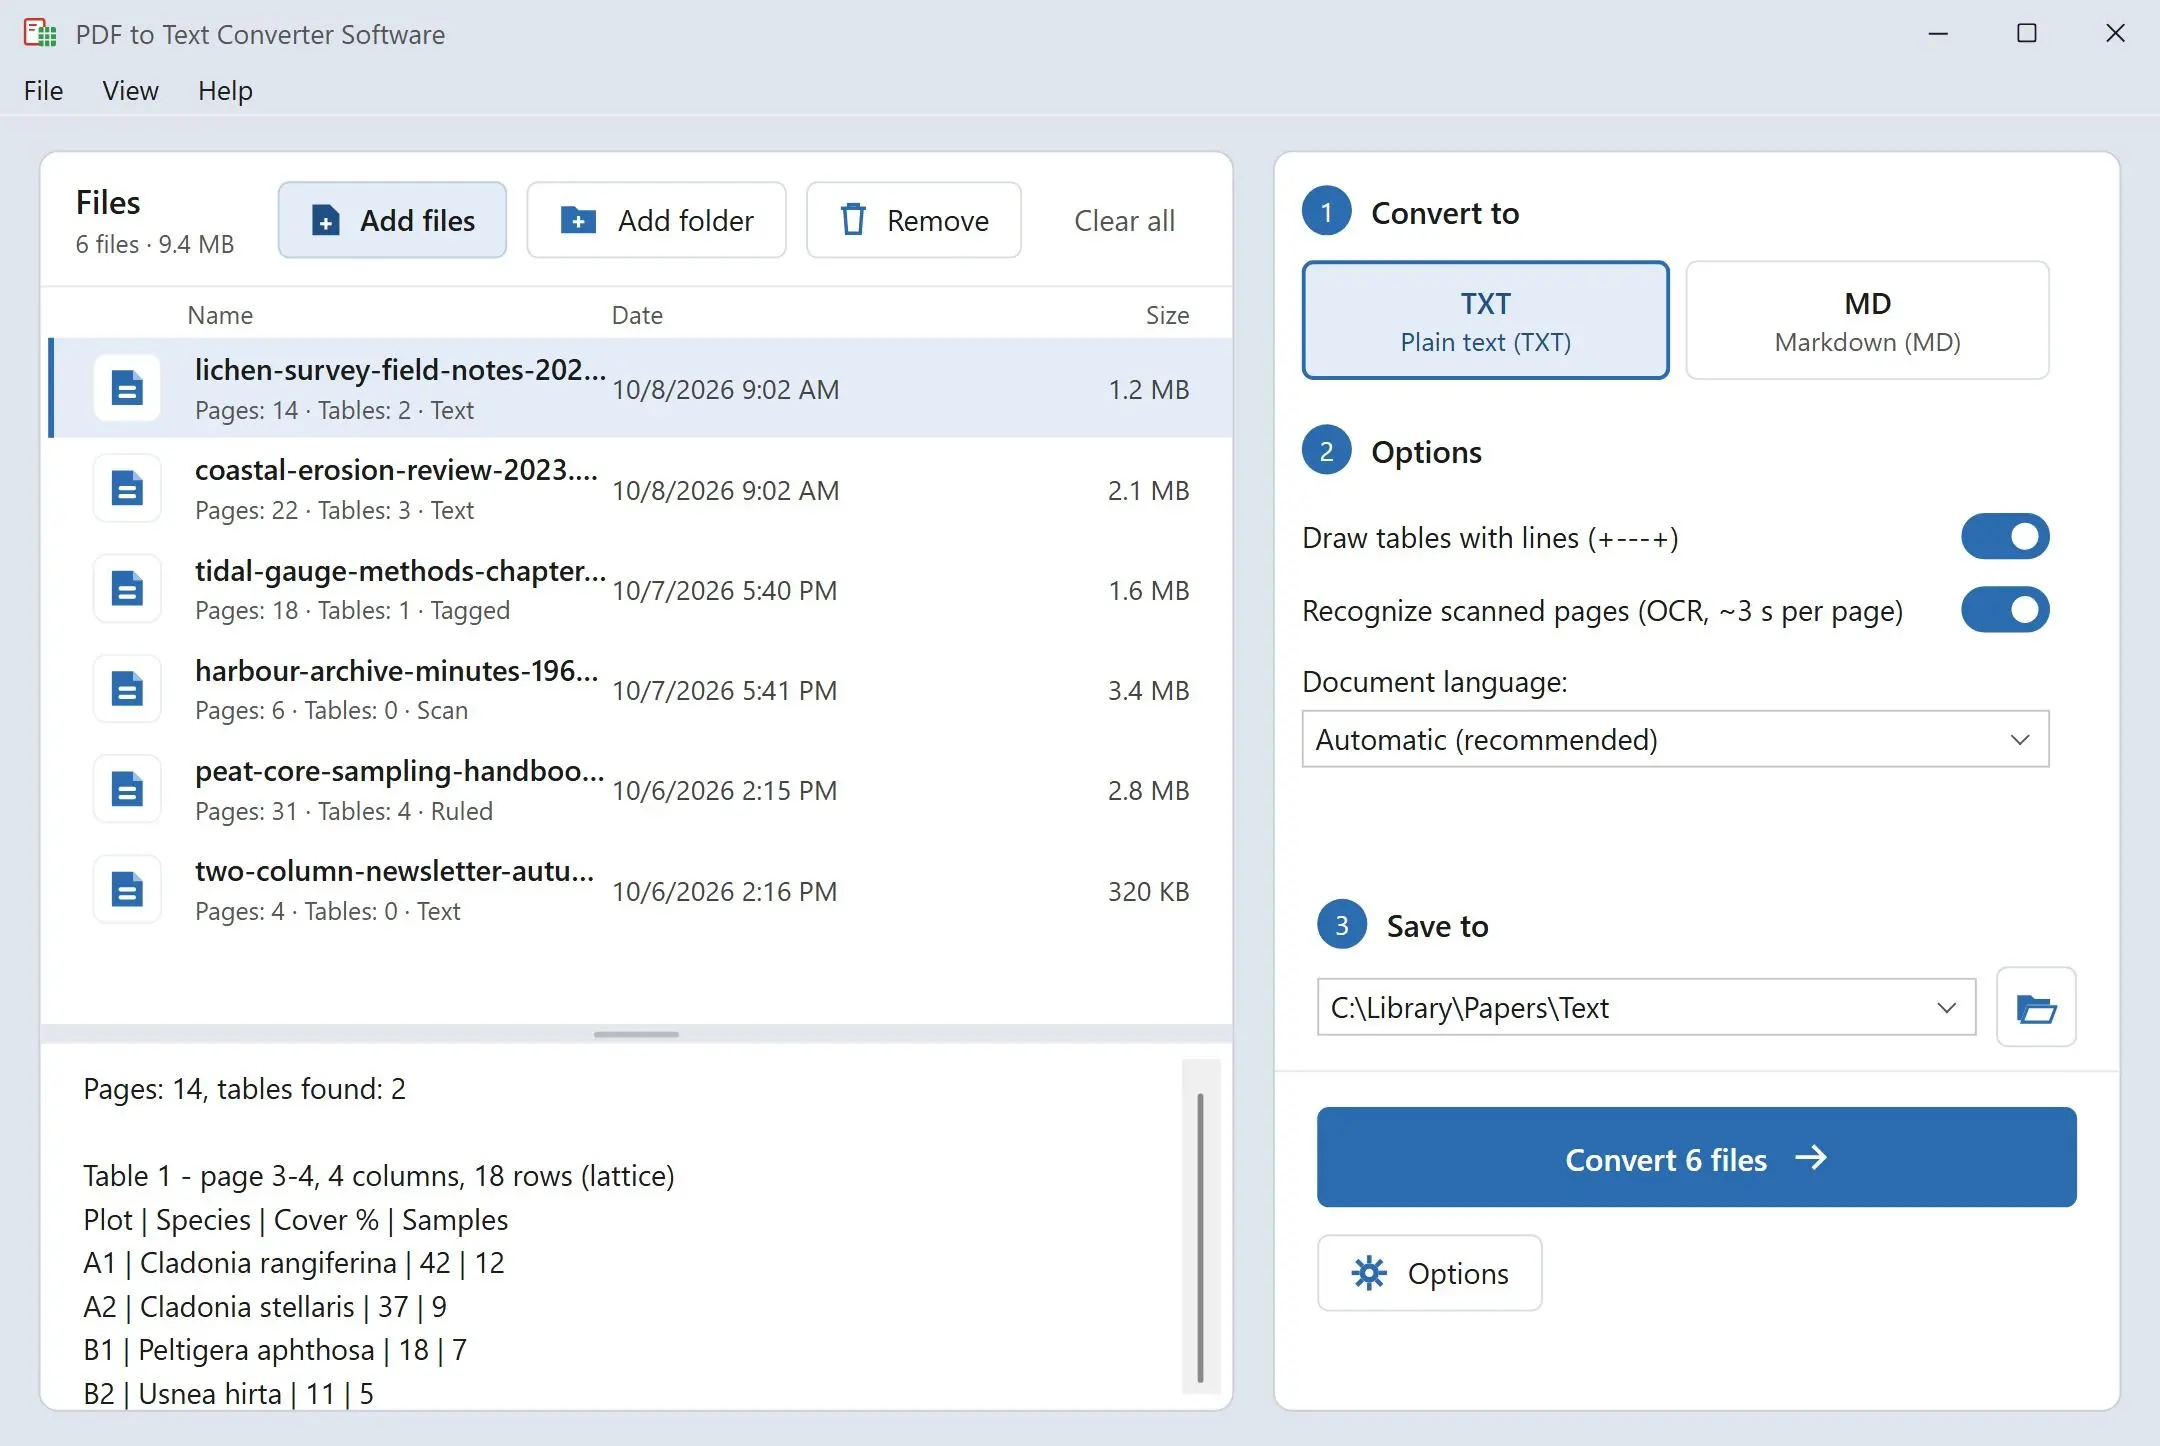
Aggiungi una cartella di PDF e ottieni un file .txt o .md per ciascuno, scritto sul tuo PC Windows. Le colonne escono nell'ordine in cui le leggeresti e le tabelle mantengono ogni cifra sotto l'intestazione giusta.
Estrarre le parole da un PDF non dovrebbe richiedere un pomeriggio
Seleziona tutto in un visualizzatore PDF, incolla nel Blocco note e un articolo a due colonne diventa righe che saltano da una colonna all'altra a metà frase, mentre una tabella si riduce a una stringa di numeri senza nulla che li distingua. I siti web fanno meglio, ma un caricamento alla volta, e tengono il tuo file sul loro server per un po'. Questo programma gestisce un'intera cartella in un colpo solo: legge ogni PDF sulla tua macchina e scrive testo semplice che puoi leggere, cercare e citare.
How to use it
Aggiungi file o una cartella
Trascina singoli PDF o un'intera cartella nell'elenco. Salva l'output accanto a ogni originale o in un'unica cartella a tua scelta. Due file con lo stesso nome da cartelle diverse ottengono output separati, quindi nulla viene sovrascritto per sbaglio.
Scegli testo semplice o Markdown
Il testo semplice è UTF-8 con fine riga di Windows e un form feed tra le pagine. Le tabelle sono incorniciate per impostazione predefinita con righe +---+; disattivalo e le colonne vengono allineate con spazi. Markdown trasforma i titoli in intestazioni # e le tabelle in tabelle con barre verticali.
Avvia il blocco e cerca nei risultati
Un solo avvio copre l'intero elenco. Al termine, un riepilogo indica quanti file sono stati scritti e dove. Punta la ricerca di Windows, il tuo editor o grep su quella cartella e cerca qualsiasi frase in tutti i documenti contemporaneamente.
Benefits
Le colonne si leggono come le legge una persona
In una pagina di rivista a due colonne viene scritta prima tutta la colonna sinistra, poi tutta la destra. Le frasi restano intere e i titoli di sezione sono riconosciuti dalla dimensione, quindi non finiscono in mezzo a un paragrafo.
Tabelle leggibili nel Blocco note
Un listino prezzi o un referto di laboratorio mantiene la sua griglia: ogni cifra resta sotto l'intestazione della sua colonna, incorniciata con caratteri semplici che qualsiasi editor di testo può mostrare. Solo le tabelle vere ottengono una griglia, quindi una pagina di prosa su due colonne resta prosa.
Nulla lascia il tuo PC
Il motore PDF gira dalla cartella del programma sulla tua macchina. Non c'è alcun caricamento, account o connessione di rete coinvolti, quindi contratti, cartelle cliniche e manoscritti inediti restano dove sono.
Perché le persone lo usano
Anche le pagine scansionate vengono riconosciute
Una pagina che è solo l'immagine di un foglio passa attraverso il riconoscimento del testo sul tuo PC, a circa 3 secondi per pagina. Copre gli alfabeti latino e cirillico e richiede Windows a 64 bit. Le pagine che hanno già uno strato di testo vengono prese così come sono, e le tabelle di una scansione escono spaziate in colonne senza la griglia.
Pronto per app di appunti e assistenti IA
L'output Markdown va direttamente in un'app di appunti, in un wiki o in una chat con un assistente IA senza ripulitura. Le intestazioni da # a ###### seguono la dimensione dei titoli nel documento, e le tabelle diventano tabelle con barre verticali con la prima riga come intestazione.
Testo in molte lingue
I PDF con strato di testo in cinese, giapponese o coreano escono come testo leggibile, e le righe in ebraico e arabo mantengono l'ordine da destra a sinistra. Tutto viene salvato in UTF-8, quindi il file si apre correttamente in qualsiasi editor moderno.
FAQ
System Requirements
Bulk PDF Text Extractor
Languages
3.5
9 Mb
September 15, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note