PDF to Structured XML Exporter
让程序读得懂的 XML,来自 PDF 的内容
离线批量将 PDF 文件转换为结构化 XML:页面、标题、段落和表格(行与单元格)。每个块可选输出坐标和字体。免费试用。
Full seller details: Legal information.
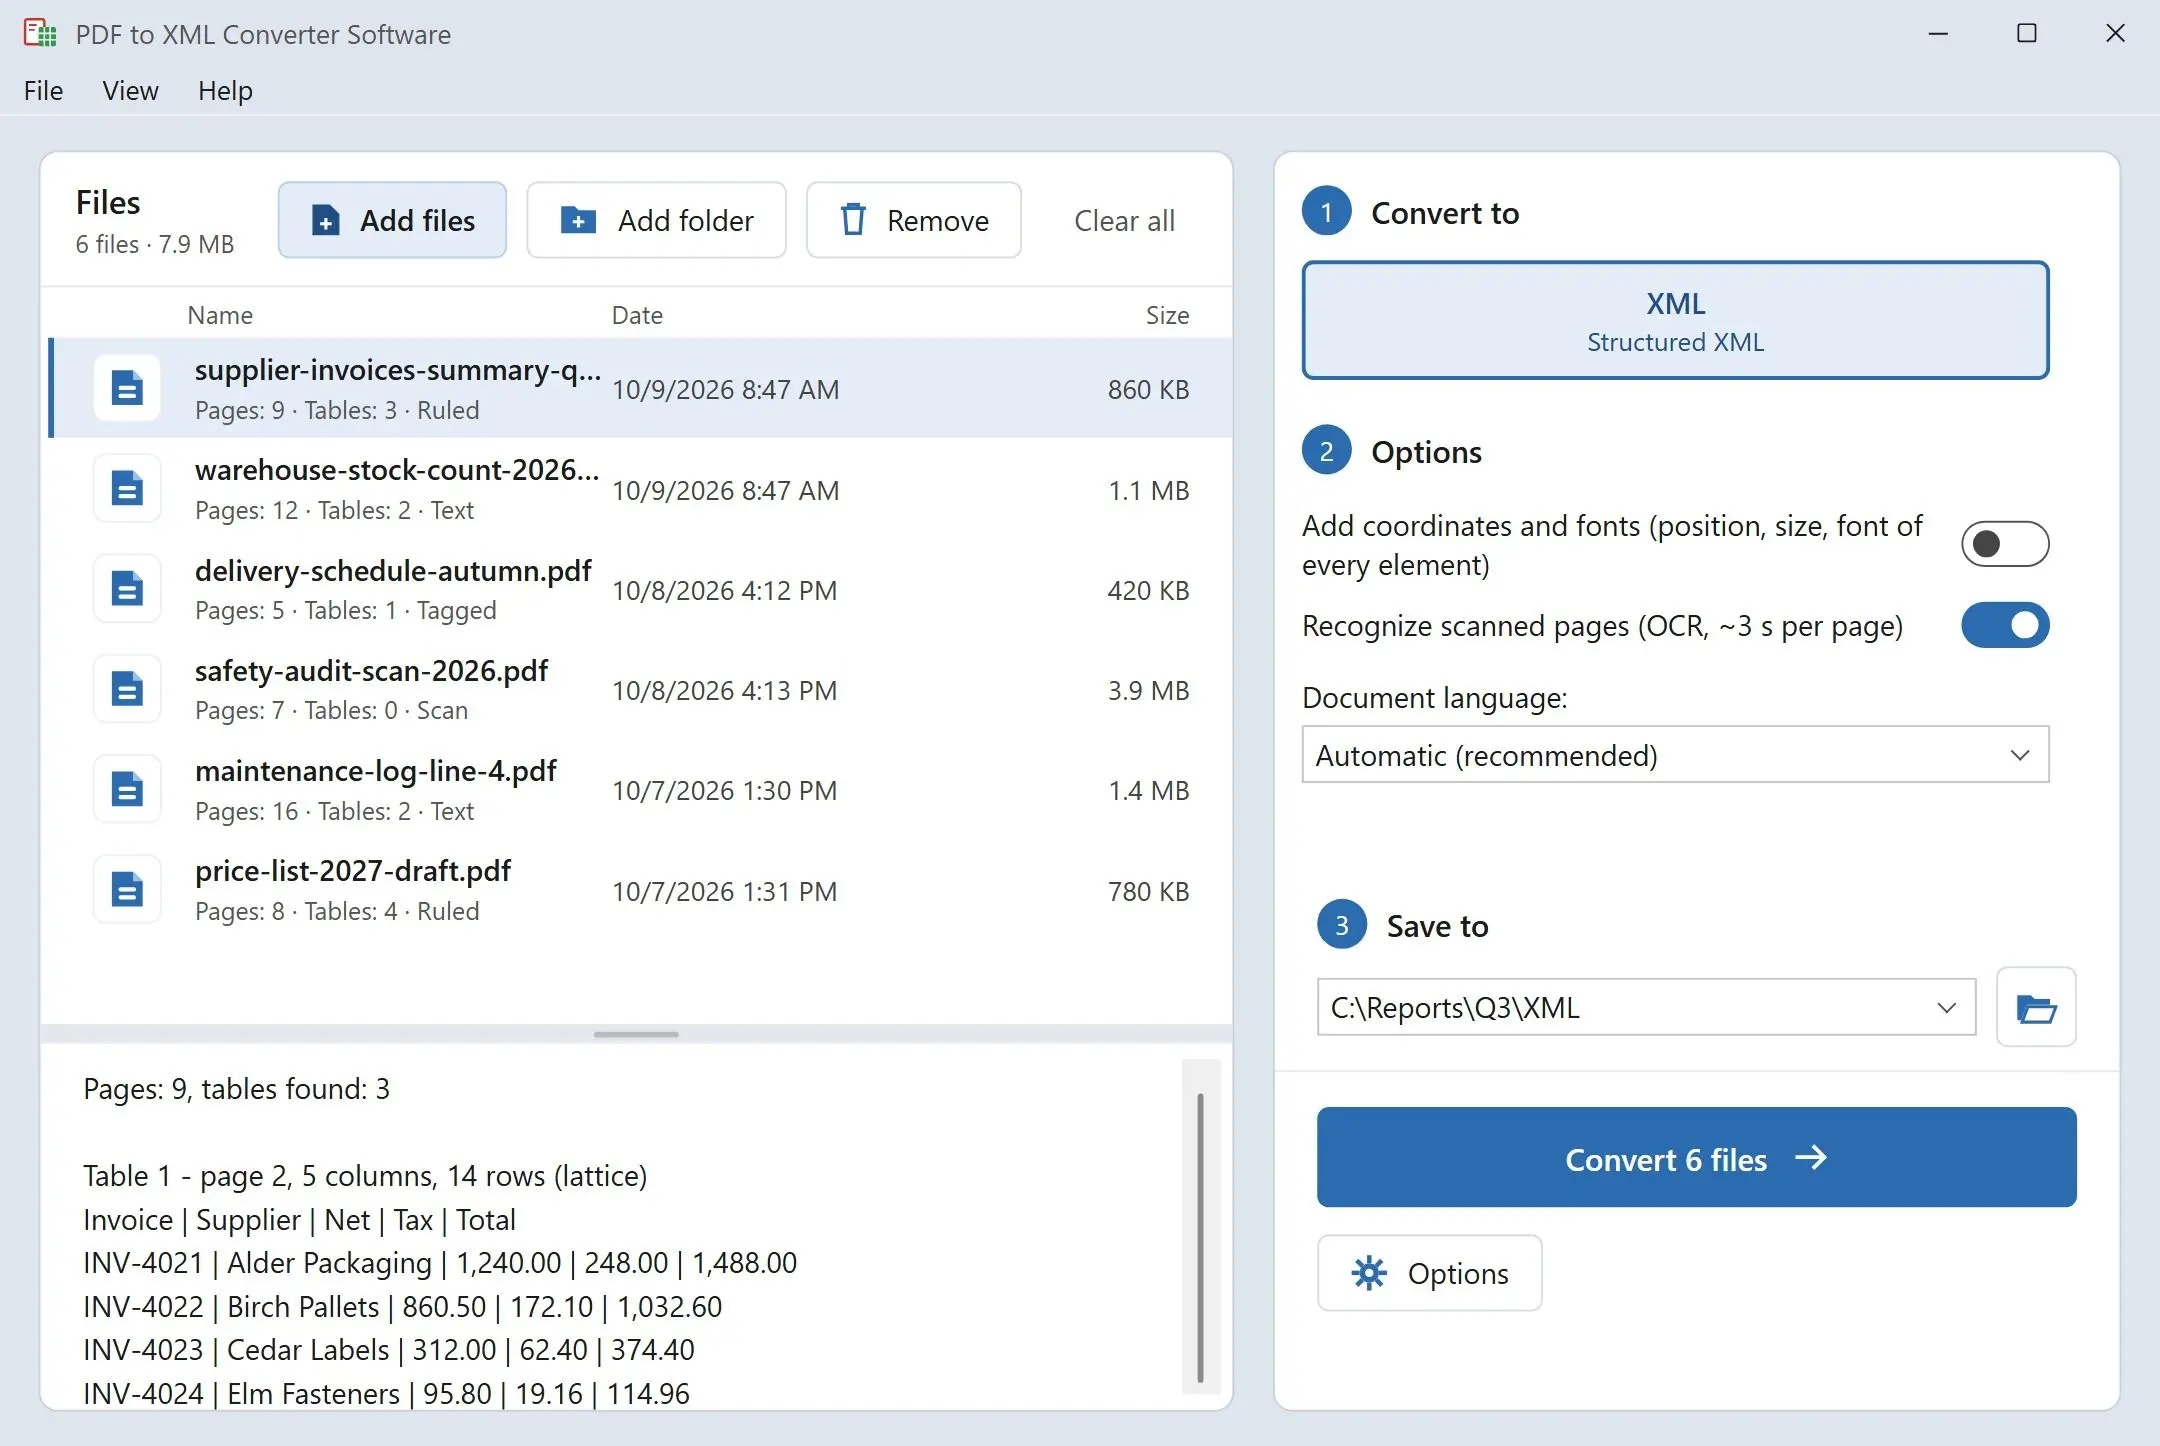
给它一个装满报告的文件夹,每个 PDF 就得到一个 XML 文件:每页一个 page 元素,标题带有级别,还有段落,以及拆成行和单元格的表格。它运行在你的 Windows 电脑上,所以不会上传任何东西。
PDF 只知道墨迹落在哪里,不知道它是什么意思
PDF 内部没有段落,没有标题,也没有表格,只有放在页面坐标上的一段段文字。这对打印来说没问题,对导入脚本却毫无用处。PDF 编辑器里的 XML 导出大多只是描述这种版面,上传类网站也很少说明输出是怎么生成的。本程序则重建结构:把行归并成段落,按字号给标题分级,找出表格网格,并且每次都以同一种模式写出,所以读取它的代码不必去猜。
How to use it
加载 PDF
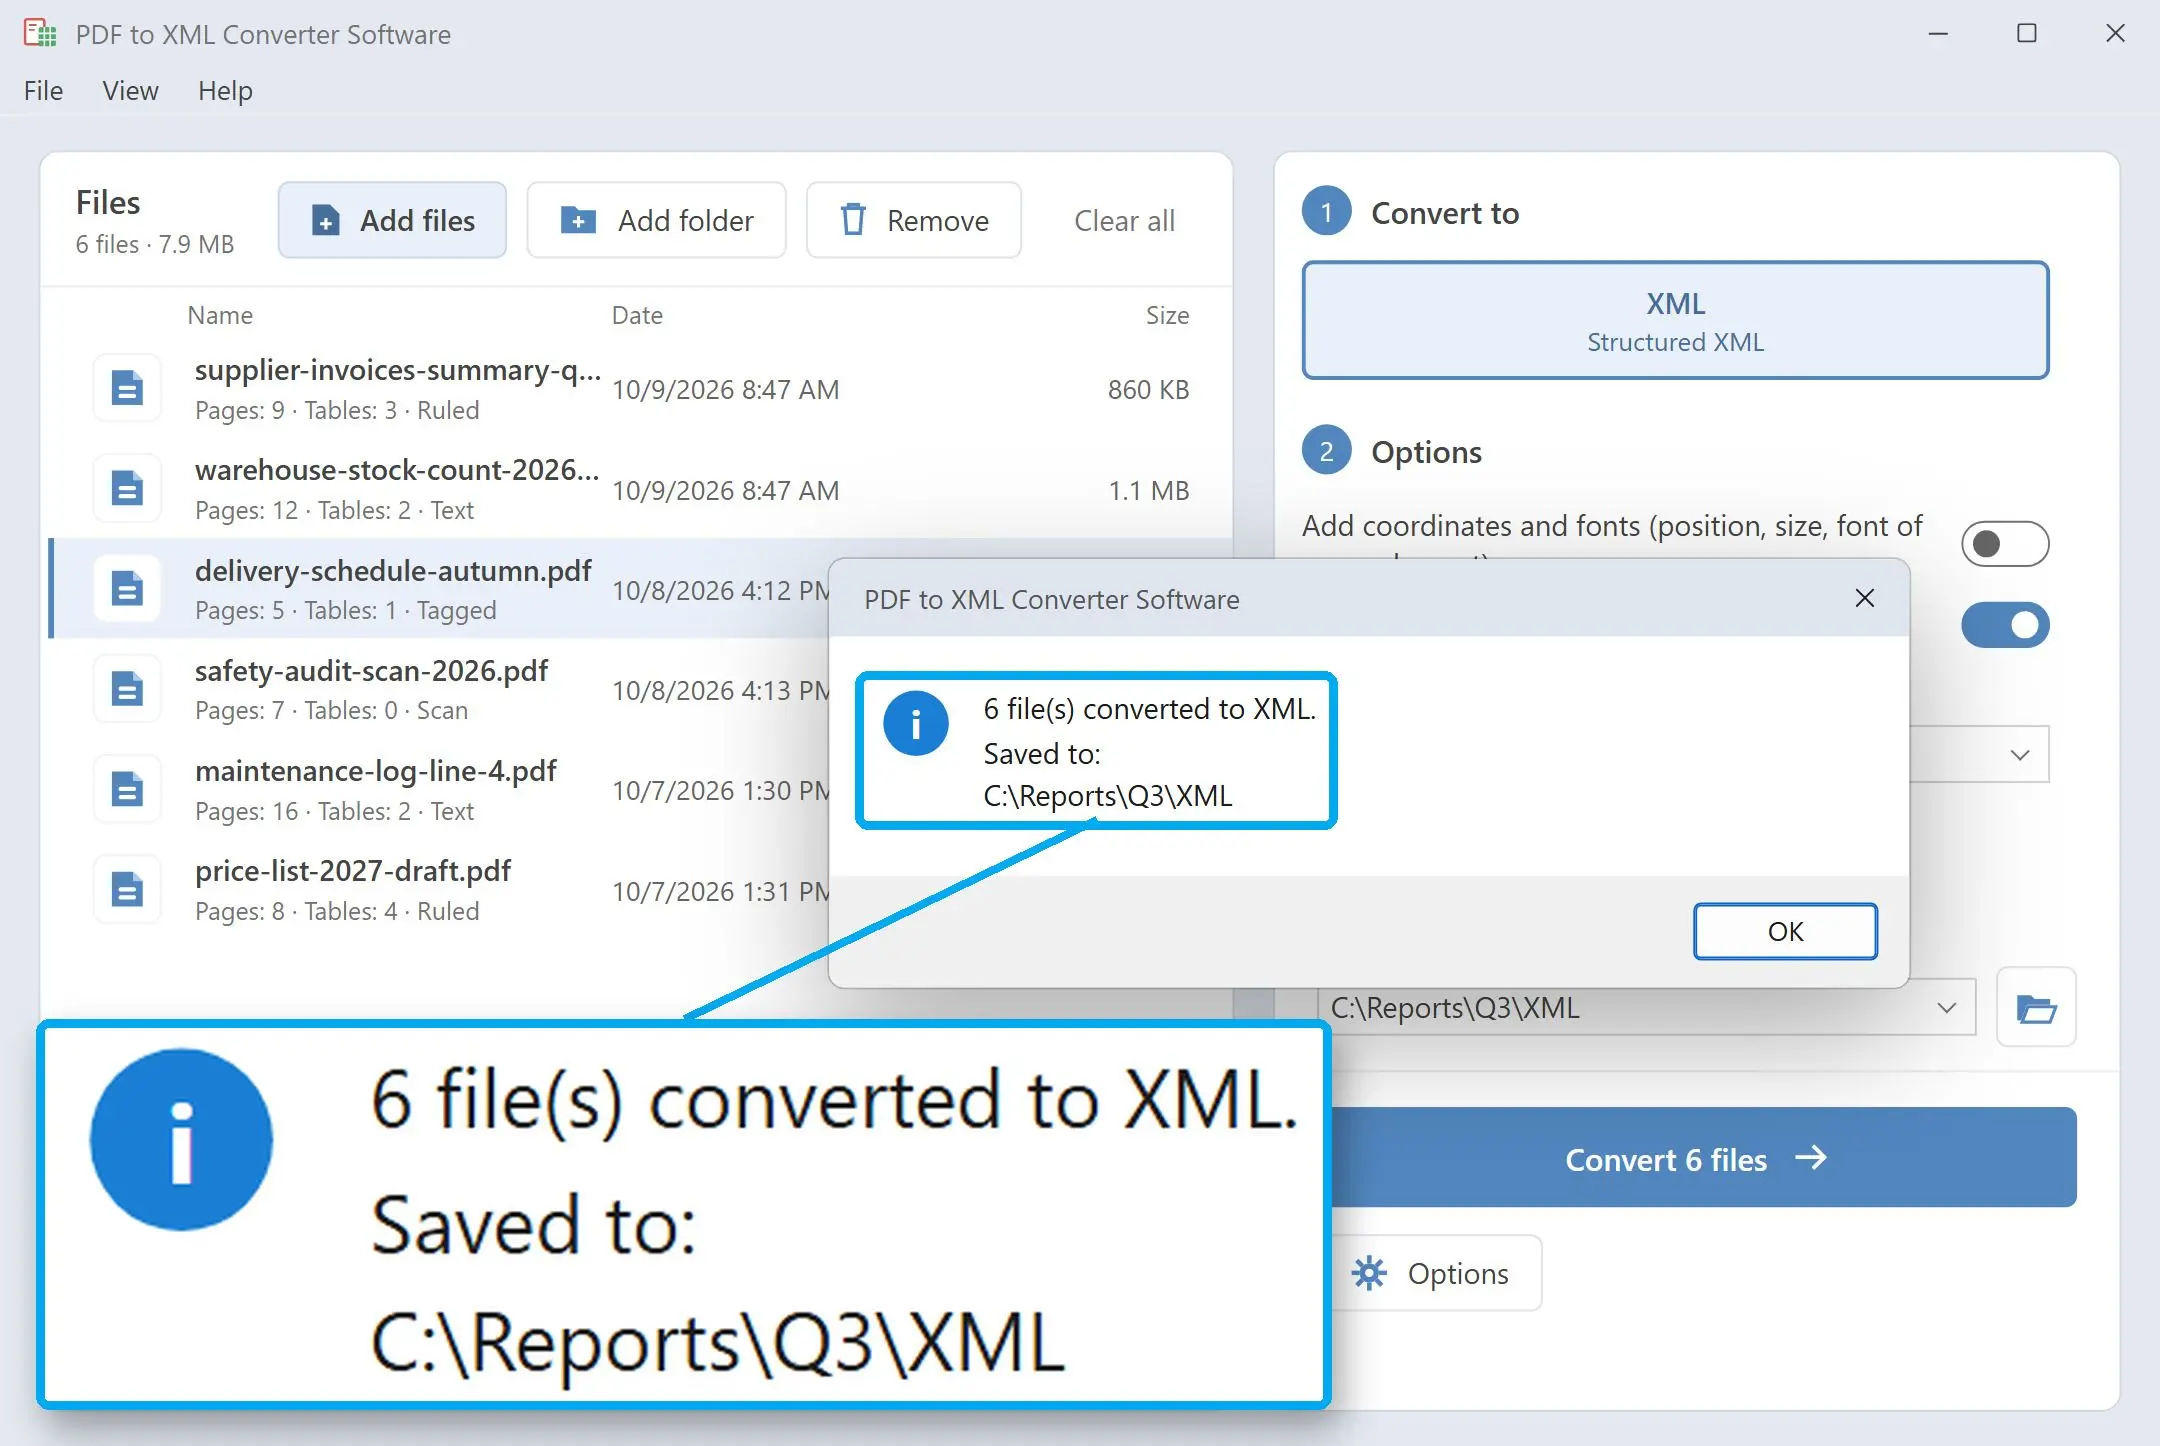
添加单个文件或整个文件夹。每个 PDF 都会得到一个以源文件命名的 XML 文件,在替换旧输出之前,程序每批只询问一次。
选择精简或详细输出
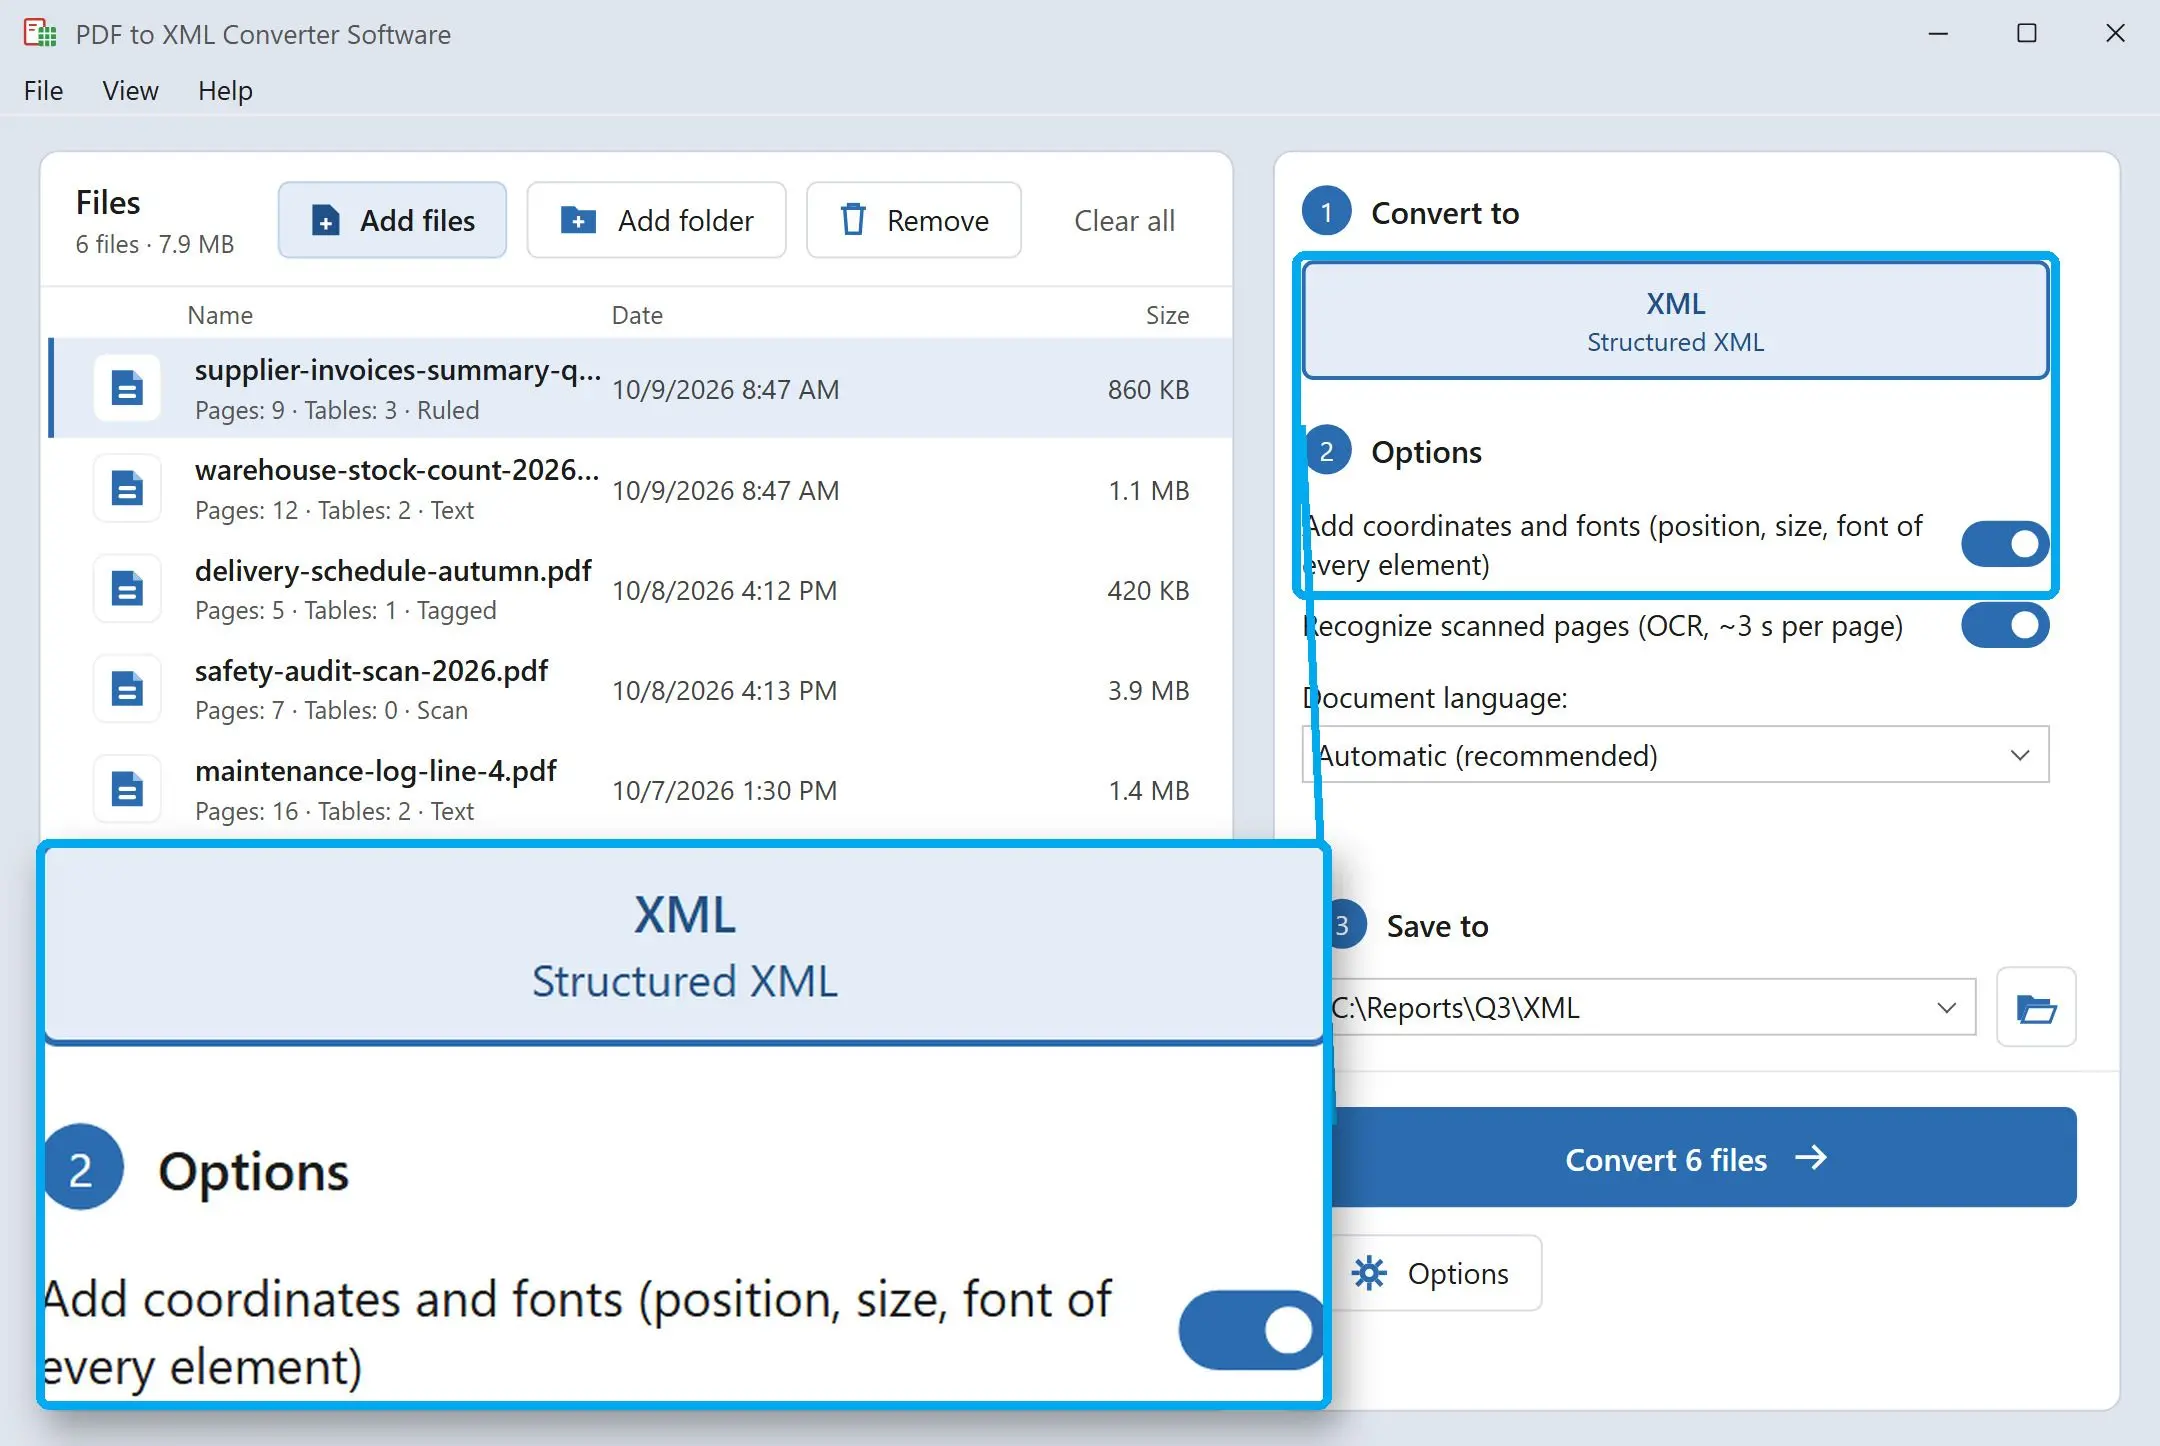
关闭坐标可得到只含结构和文本的紧凑文件。开启后,每个块都会有以点为单位的 x、y、w 和 h,一个指向字体条目的引用,以及嵌套的 line 和 text 元素,详细程度相当于 pdftohtml -xml 的输出。
把文件交给你的代码
每个文件都是格式良好的 UTF-8,不含字节顺序标记。可以用 ElementTree、lxml、XSLT 或数据库的 XML 加载器读取;元素名称在不同报告之间保持不变。
Benefits
人们为什么使用它
可以信赖的标题级别
1 到 6 的级别是根据字号与整份文档正文的比较确定的,而不是逐页判断。第 40 页的章节标题与第 2 页的章节标题级别相同,所以搜索索引或目录可以放心依赖。
扫描页会被标记,而不是被隐藏
没有文字层的页面会标记为 scanned="1"。如果其文字来自识别(拉丁字母和西里尔字母),该页会带有 ocr="1" 和一个置信度数值,并且只输出段落,识别过的页面不会检测表格。你的流程可以把这些页面转给人工检查。
不会把正文误认成表格
单词之间的大间距会骗过许多表格检测工具,把双栏文章变成假的网格。这类候选会被拒绝,而每个真正的表格都会在其 source 属性中记录自己是如何被发现的:来自 PDF 标签、来自分隔线,还是来自文本对齐。
常见问题解答
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note