PDF to Structured XML Exporter
Obsah PDF jako XML, které program přečte
Převádějte soubory PDF na strukturované XML hromadně a offline: stránky, nadpisy, odstavce a tabulky jako řádky a buňky. Volitelně souřadnice a písma pro každý blok. Zkušební verze zdarma.
Full seller details: Legal information.
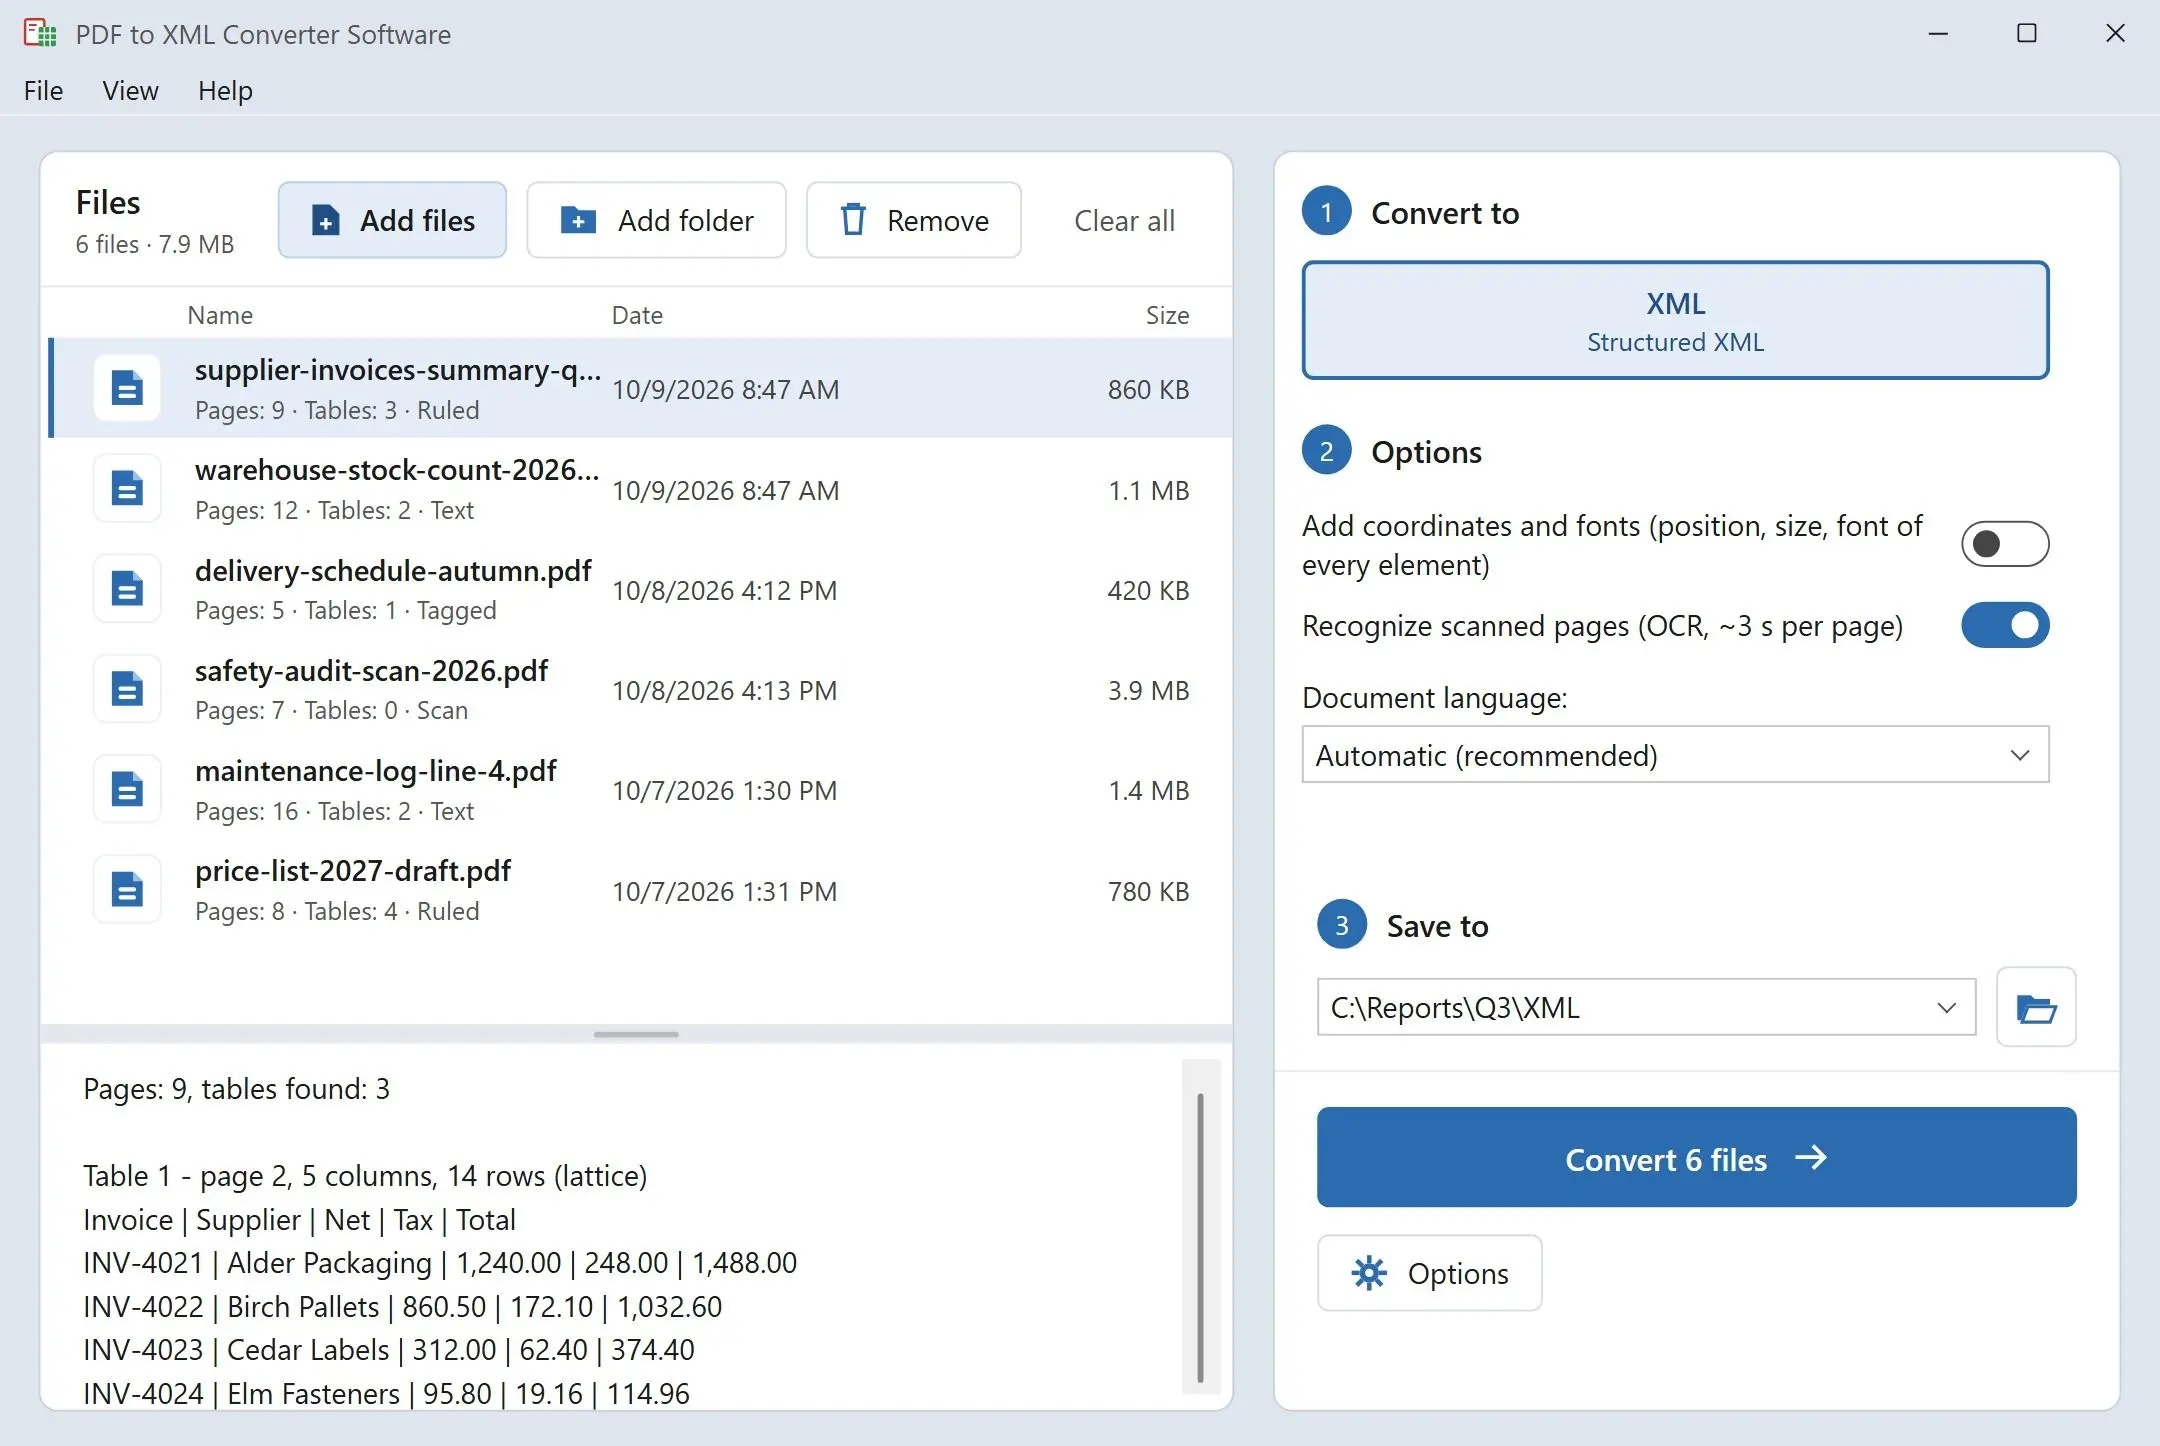
Předložte složku zpráv a získejte jeden soubor XML na každý PDF: prvek page pro každou stránku, nadpisy s jejich úrovní, odstavce a tabulky rozložené na řádky a buňky. Běží na vašem počítači s Windows, takže se nic nenahrává.
PDF ví, kam padá inkoust, ne co to znamená
Uvnitř PDF není žádný odstavec, žádný nadpis a žádná tabulka - jen kousky textu umístěné na souřadnicích na stránce. Pro tisk to stačí, pro importní skript je to k ničemu. Export do XML v editorech PDF většinou popisuje právě toto rozvržení a stránky pro nahrávání málokdy uvádějí, jak se jejich výstup tvoří. Tento program místo toho strukturu znovu sestaví: seskupí řádky do odstavců, seřadí nadpisy podle velikosti písma, najde mřížky tabulek a vše zapíše vždy do stejného schématu, takže kód, který to čte, nemusí hádat.
How to use it
Načtěte PDF
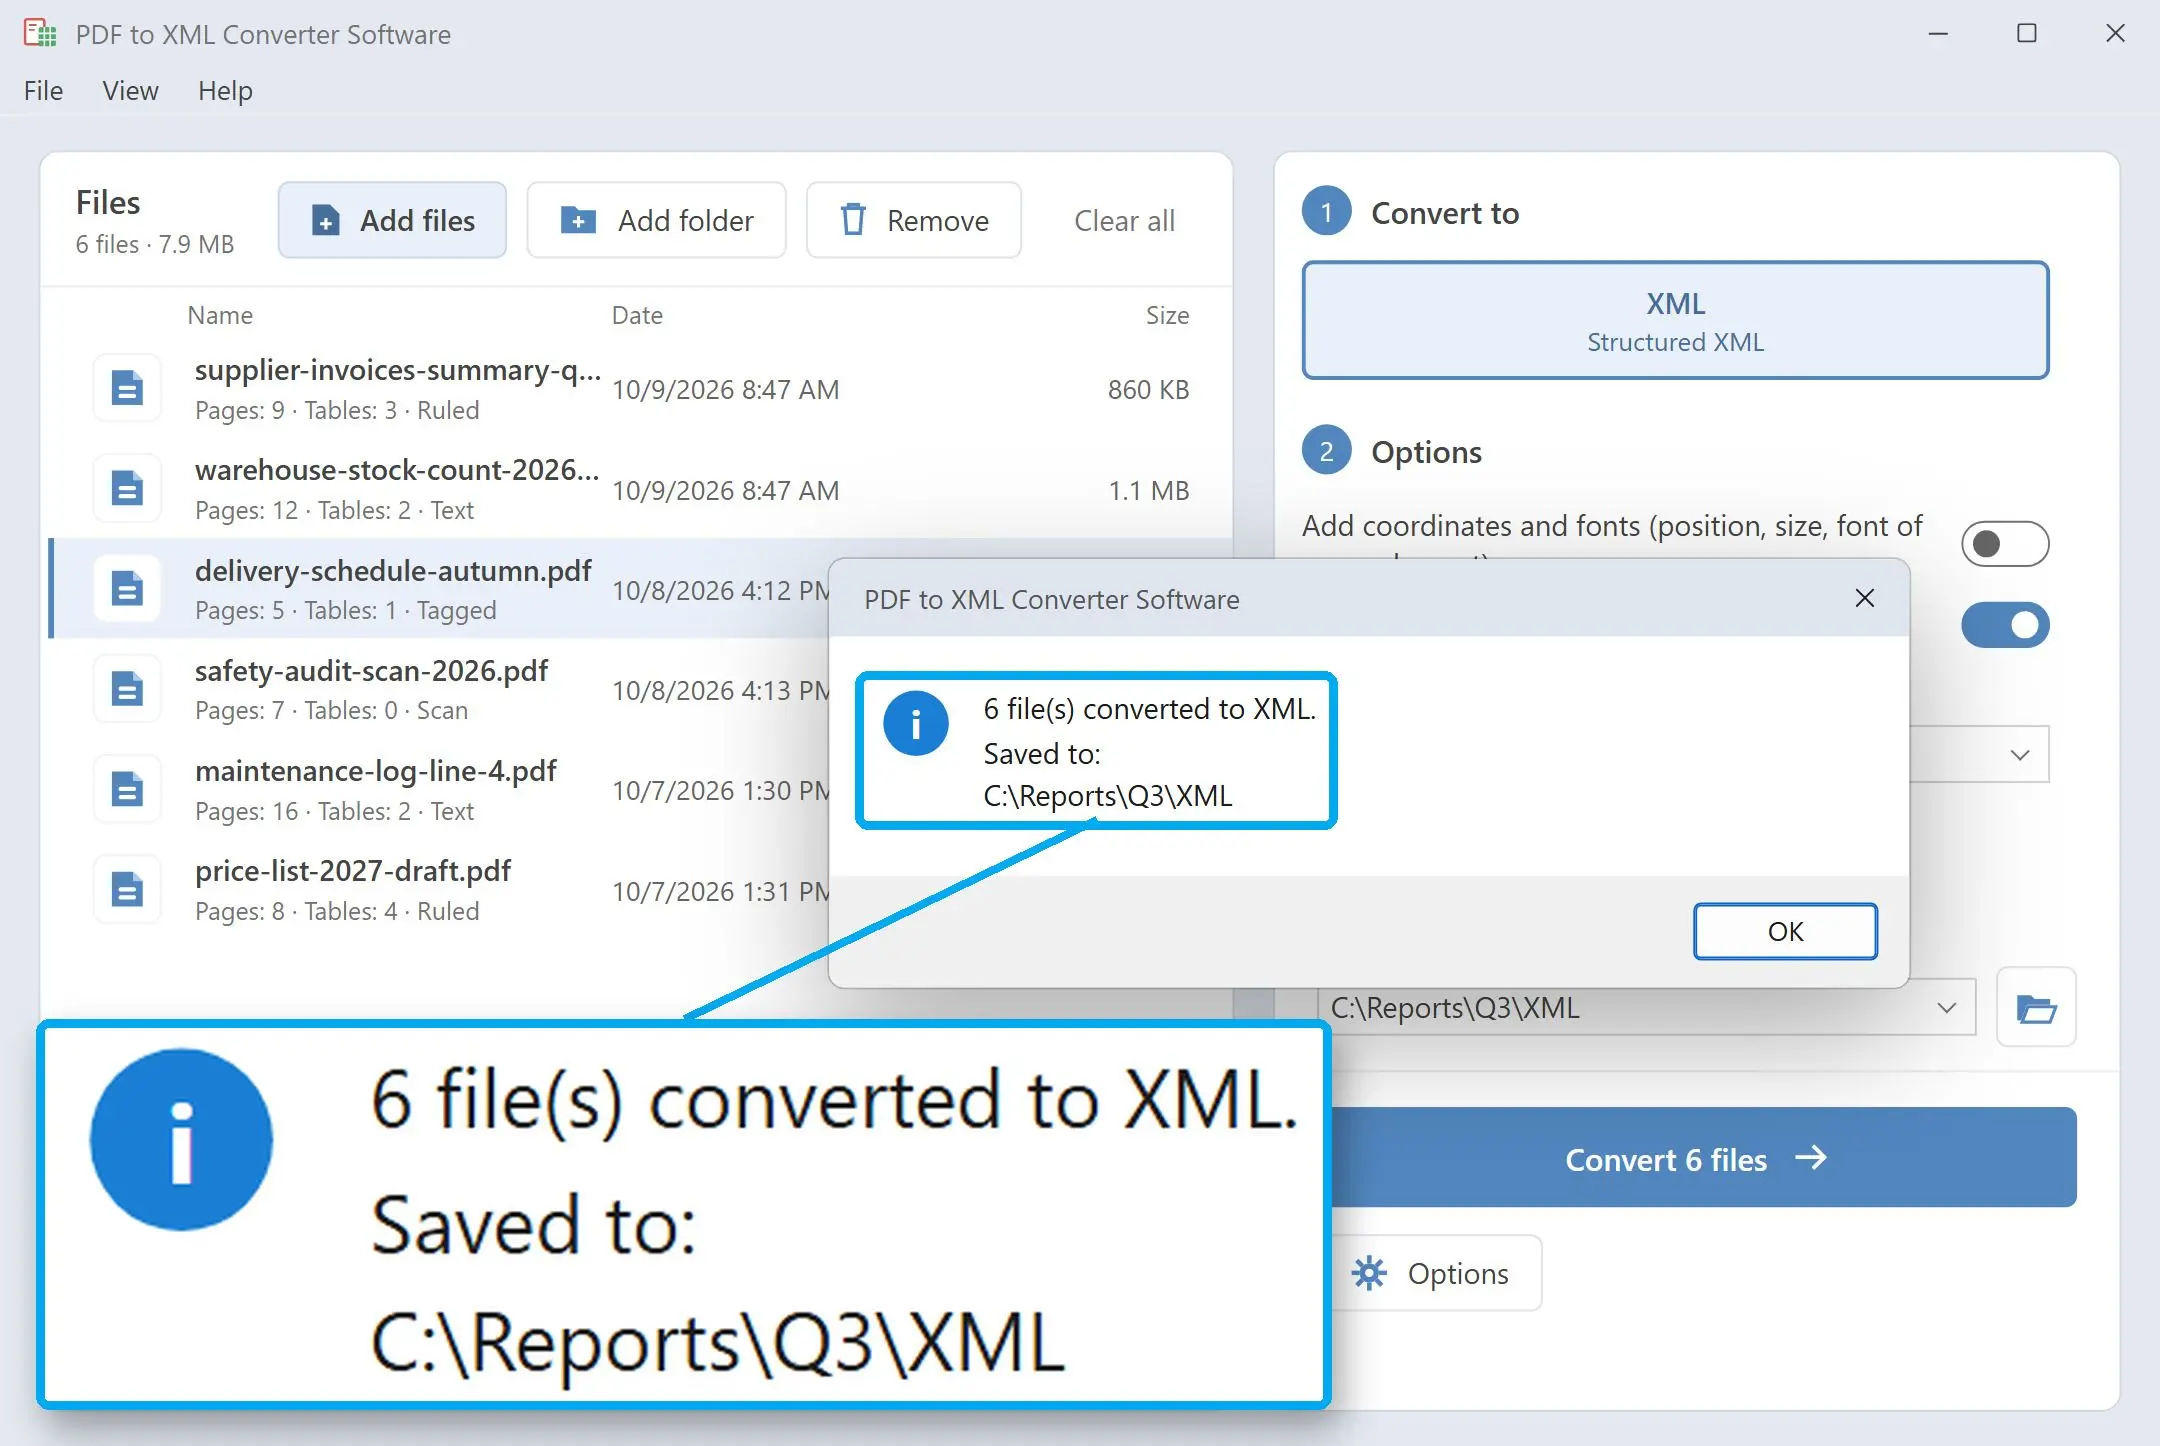
Přidejte jednotlivé soubory nebo celou složku. Každý PDF dostane vlastní soubor XML pojmenovaný podle zdroje a program se před nahrazením starších výstupů zeptá jednou za dávku.
Vyberte lehký nebo podrobný výstup
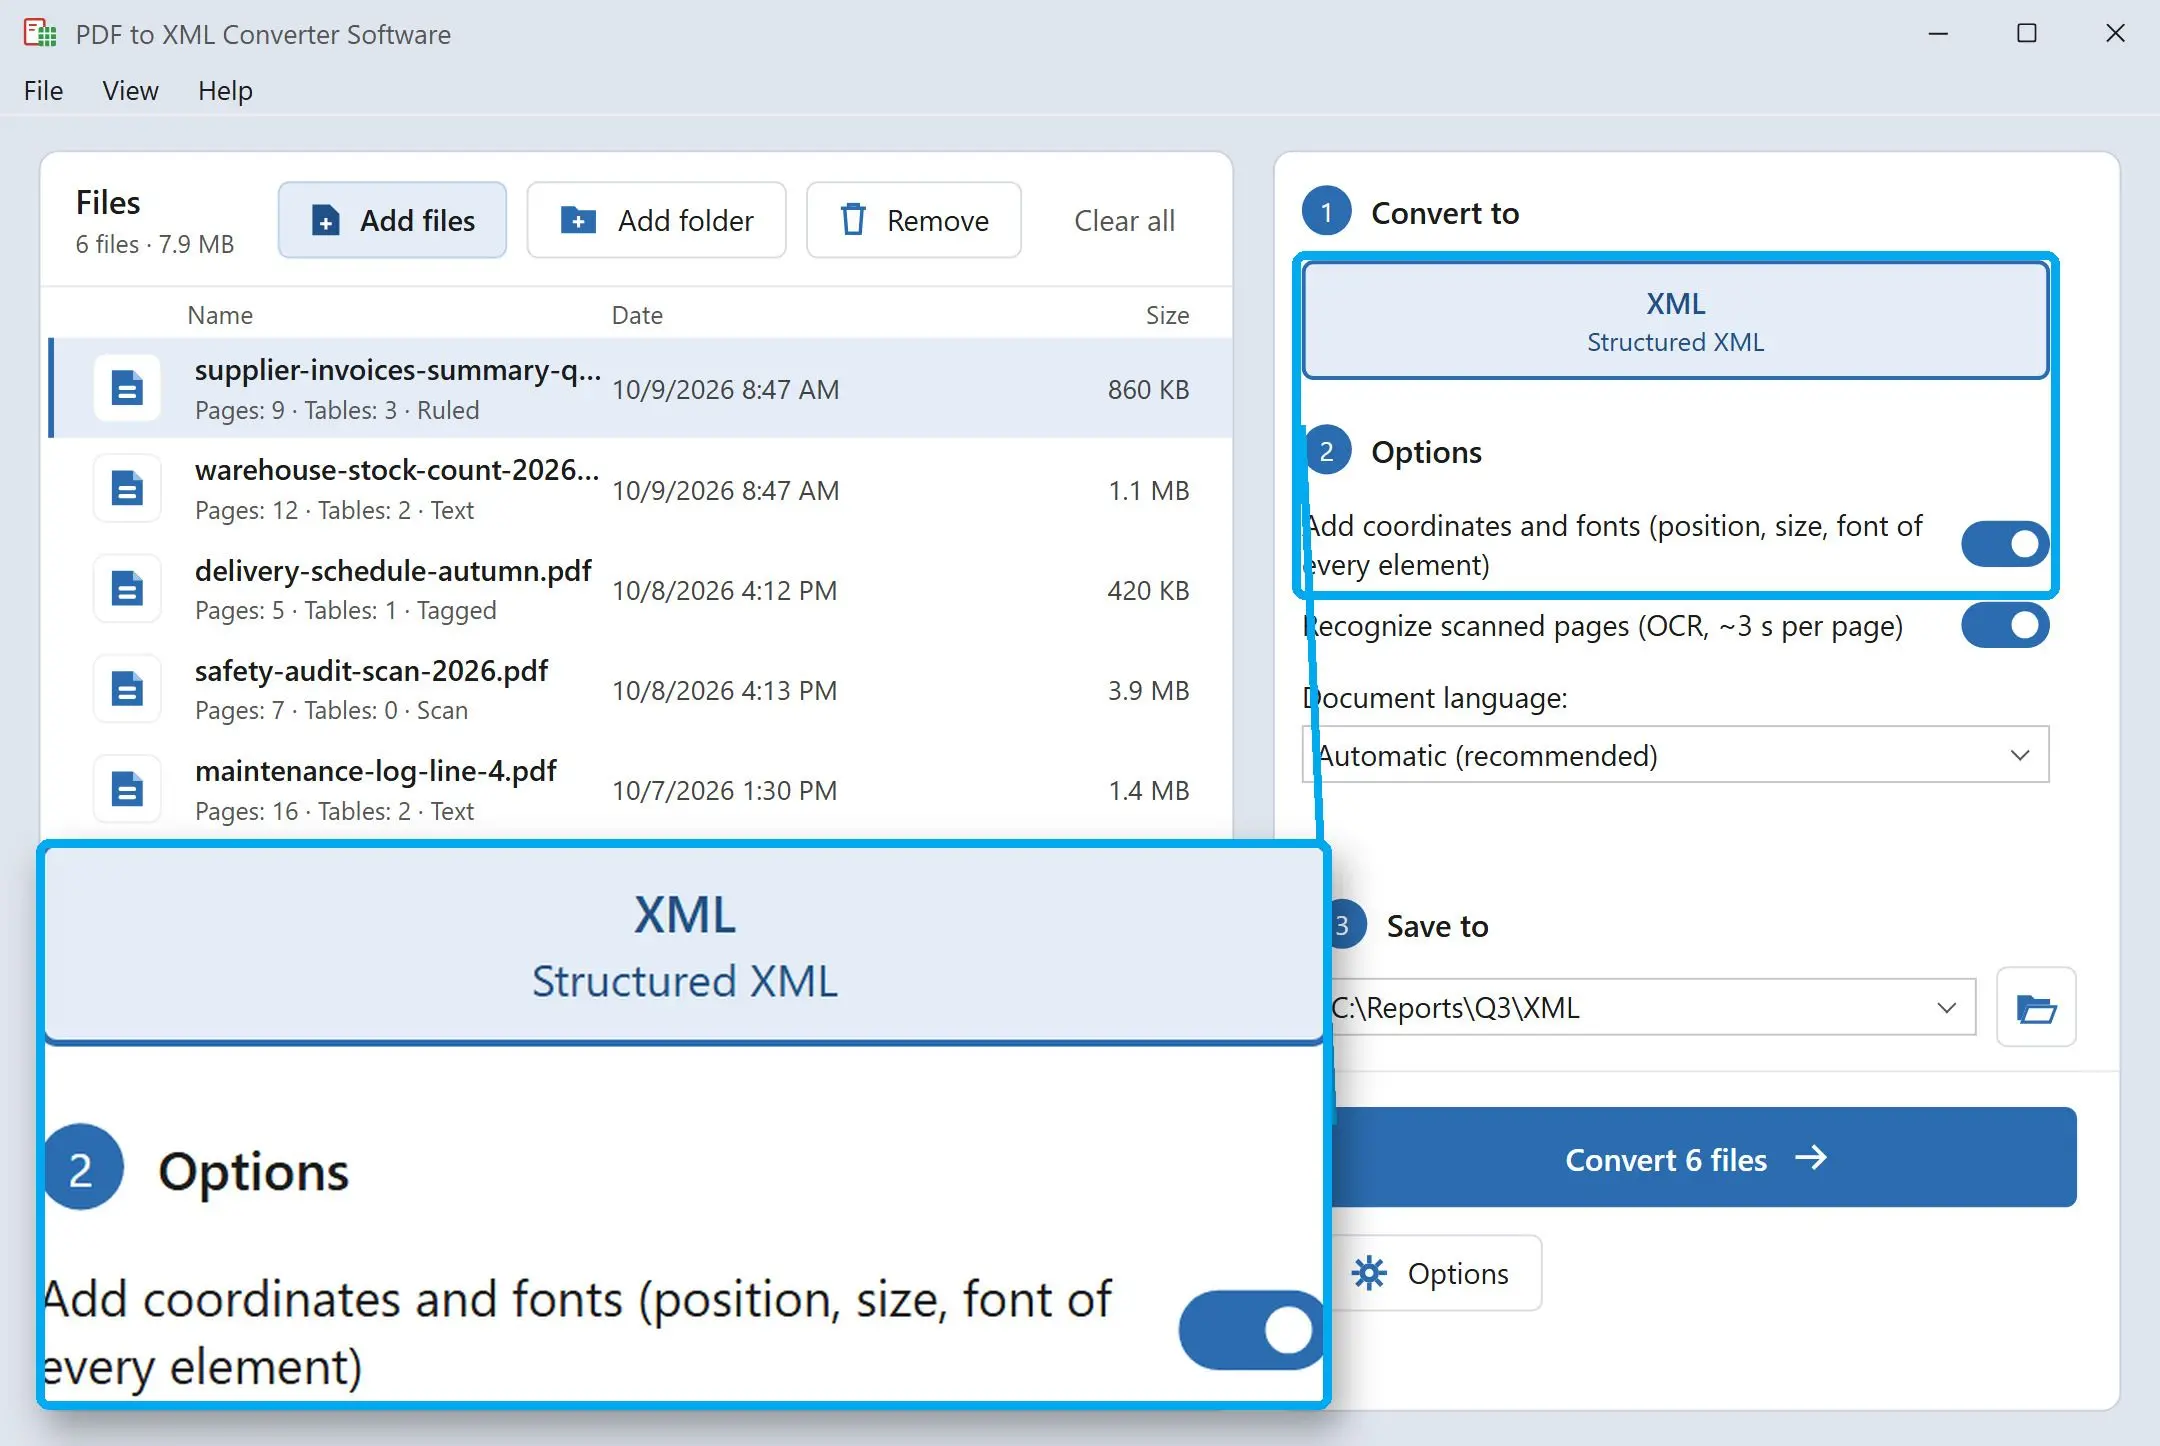
Souřadnice nechte vypnuté pro kompaktní soubor jen se strukturou a textem. Zapněte je a každý blok dostane x, y, w a h v bodech, odkaz na položku písma a vnořené prvky řádků a textu - úroveň detailu, jakou čekáte od pdftohtml -xml.
Předejte soubory svému kódu
Každý soubor je správně utvořený UTF-8 bez značky pořadí bajtů. Čtěte ho přes ElementTree, lxml, XSLT nebo zavaděč XML vaší databáze; názvy prvků se nemění od jedné zprávy k další.
Benefits
Tabulky přicházejí jako mřížka, ne jako volné řetězce
Každá tabulka nese počty řádků a sloupců, řádek hlavičky označený header="1" a colspan nebo rowspan u sloučených buněk. Váš zavaděč může vzít názvy sloupců z hlavičky a každý další řádek změnit na záznam. Tabulka, která pokračuje přes několik stránek, se zapíše jako jedna tabulka na stránku.
Jedno schéma pro každý soubor
document, page, heading, paragraph, table, row, cell - stejné názvy a atributy v každém výstupu, ať PDF přišlo z financí, od dodavatele nebo ze skeneru. Až dorazí zpráva za příští čtvrtletí, import, který jste napsali pro tuto, přečte i ji.
Běží na vašem vlastním počítači
Zprávy, smlouvy a ceníky se čtou a zapisují lokálně, bez nahrávání a bez účtu. Důvěrné dokumenty zůstávají mimo služby třetích stran a úloha běží i na počítači bez přístupu k internetu.
Proč to lidé používají
Úrovně nadpisů, na které se můžete spolehnout
Úrovně 1 až 6 se určují podle velikosti písma v porovnání s běžným textem celého dokumentu, ne po stránkách. Název kapitoly na straně 40 dostane stejnou úroveň jako ten na straně 2, takže mu může věřit vyhledávací index nebo obsah.
Skenované stránky jsou označené, ne skryté
Stránka bez textové vrstvy je označena scanned="1". Když její text pochází z rozpoznávání (latinka a cyrilice), stránka nese ocr="1" a hodnotu spolehlivosti a dostanete jen odstavce - na rozpoznaných stránkách se tabulky nezjišťují. Váš zpracovatelský řetězec může takové stránky poslat na ruční kontrolu.
Próza se nezamění za tabulku
Široké mezery mezi slovy oklamou mnoho detektorů tabulek a změní dvousloupcový článek na falešnou mřížku. Takoví kandidáti se zamítají a každá skutečná tabulka zaznamená v atributu source, jak byla nalezena - z tagů PDF, z čar nebo ze zarovnání textu.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note