PDF to Structured XML Exporter
PDF-inhoud als XML die een programma kan lezen
Zet PDF-bestanden in batch om naar gestructureerde XML, offline: pagina's, koppen, alinea's en tabellen als rijen en cellen. Optioneel coördinaten en lettertypen voor elk blok. Gratis proefversie.
Full seller details: Legal information.
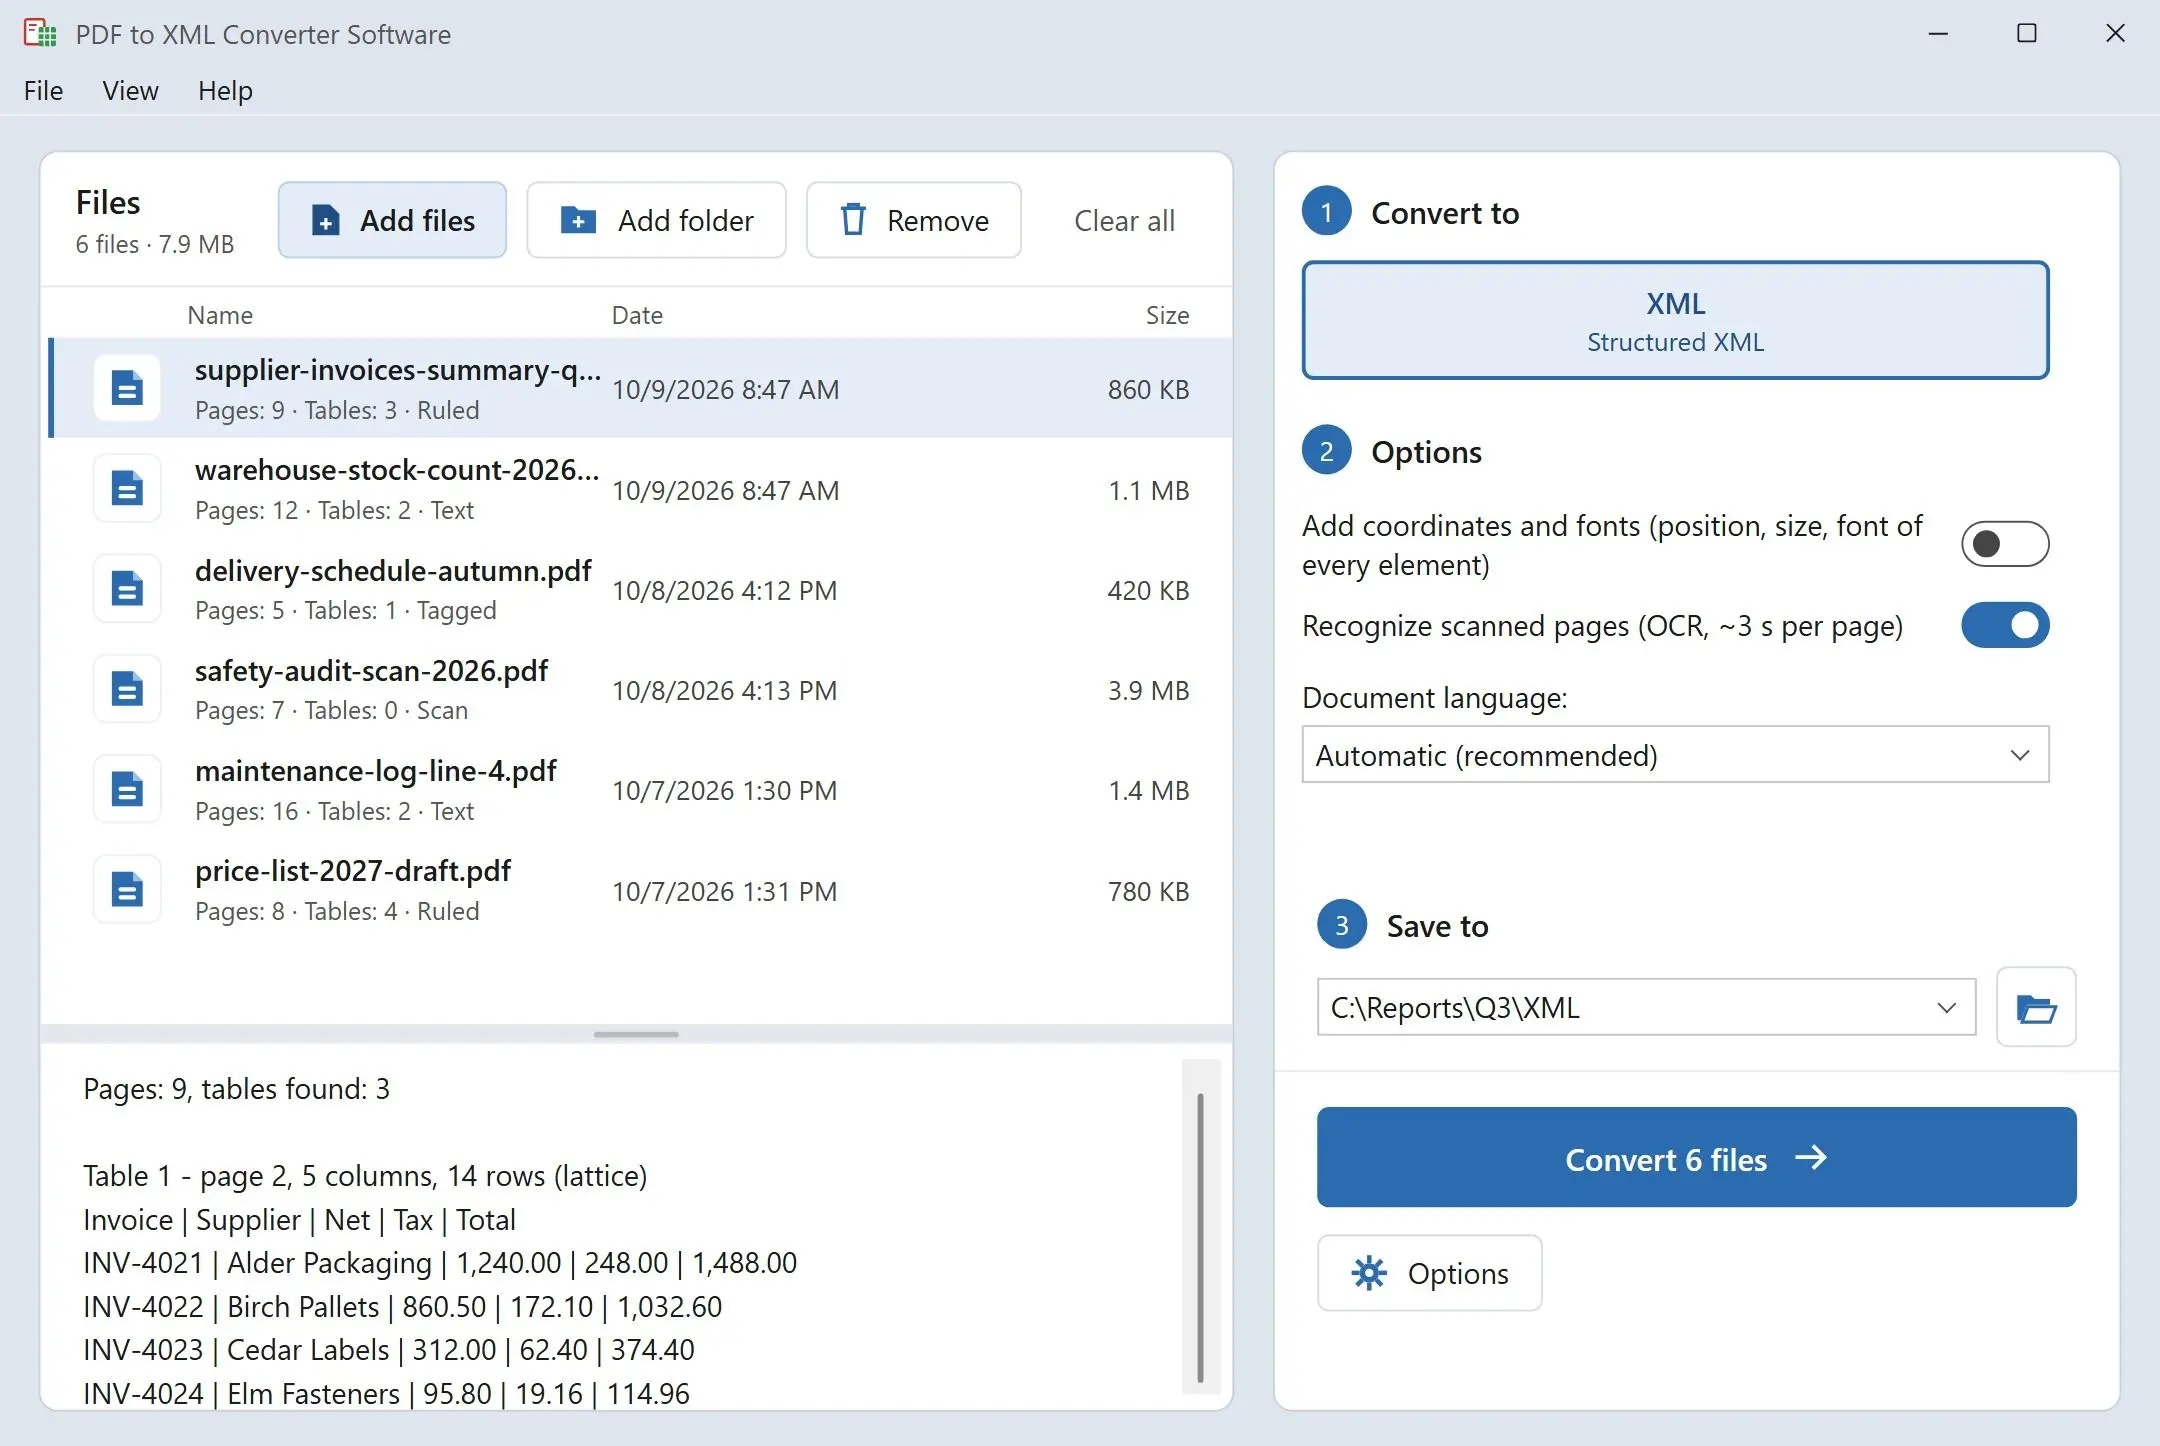
Geef het een map met rapporten en krijg één XML-bestand per PDF: een page-element voor elke pagina, koppen met hun niveau, alinea's, en tabellen opgesplitst in rijen en cellen. Het draait op je Windows-pc, dus er wordt niets geüpload.
Een PDF weet waar de inkt komt, niet wat het betekent
In een PDF bestaat geen alinea, geen kop en geen tabel - alleen stukjes tekst die op coördinaten op een pagina zijn geplaatst. Dat is prima om te printen en nutteloos voor een importscript. De XML-export in PDF-editors beschrijft vooral die opmaak, en uploadsites vertellen zelden hoe hun uitvoer is opgebouwd. Dit programma bouwt de structuur opnieuw op: het groepeert regels tot alinea's, rangschikt koppen op lettergrootte, vindt tabelrasters en schrijft alles elke keer in hetzelfde schema, zodat de code die het leest niet hoeft te gokken.
How to use it
Laad de PDF's
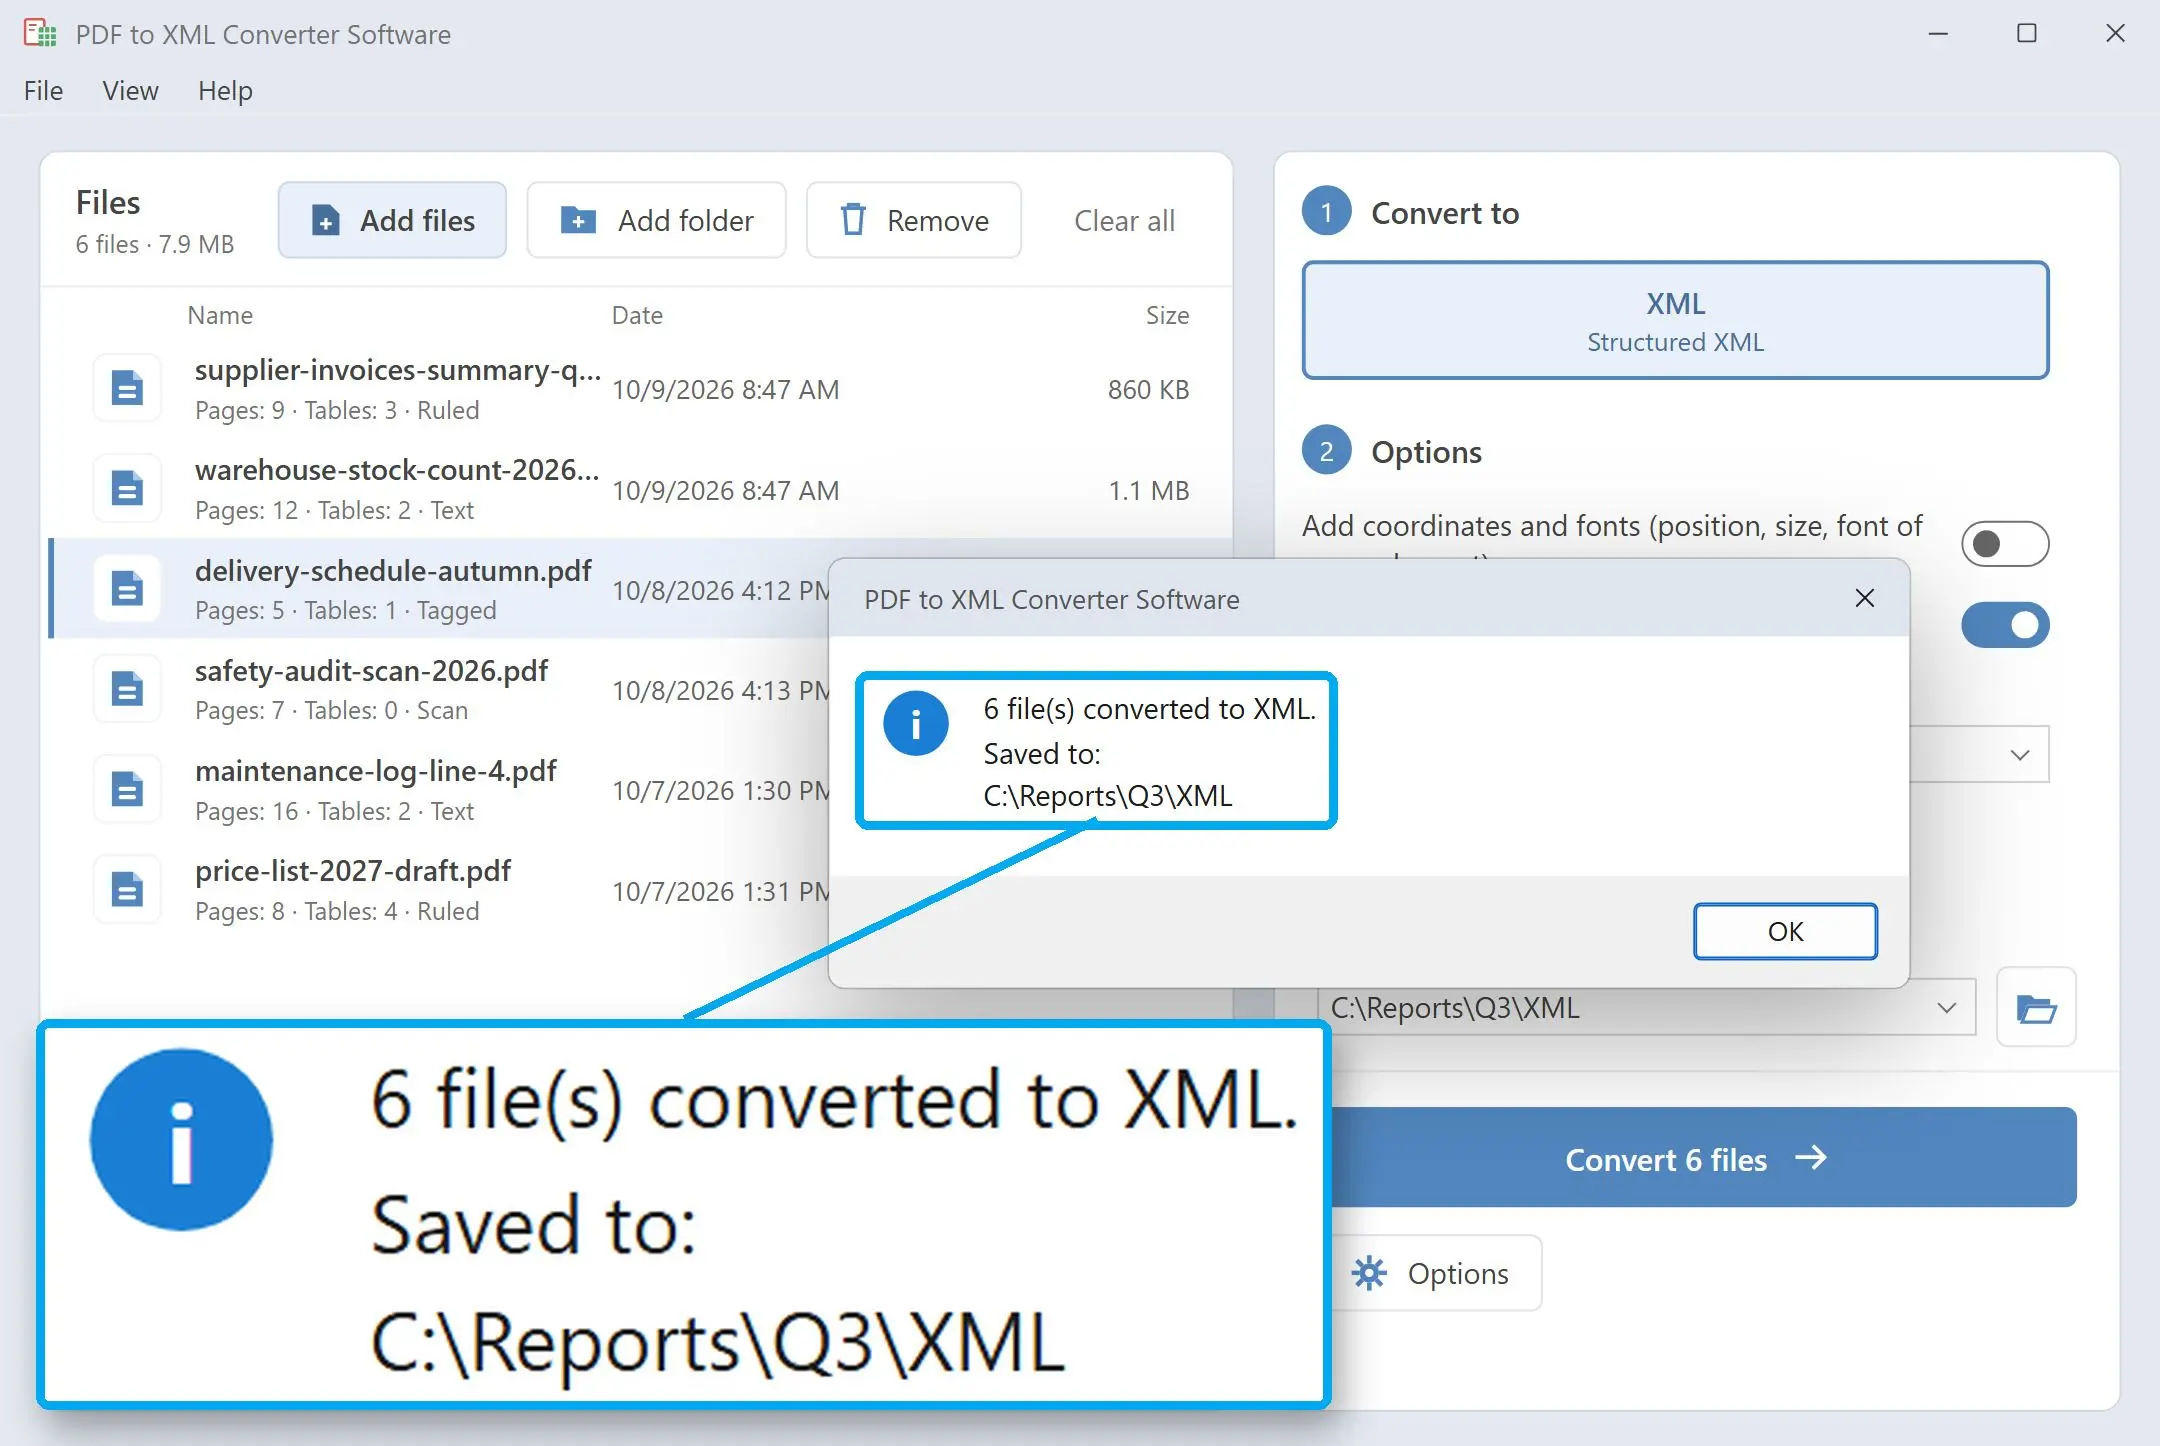
Voeg losse bestanden of een hele map toe. Elke PDF krijgt een eigen XML-bestand, genoemd naar de bron, en het programma vraagt één keer per batch voordat het oudere uitvoer vervangt.
Kies lichte of gedetailleerde uitvoer
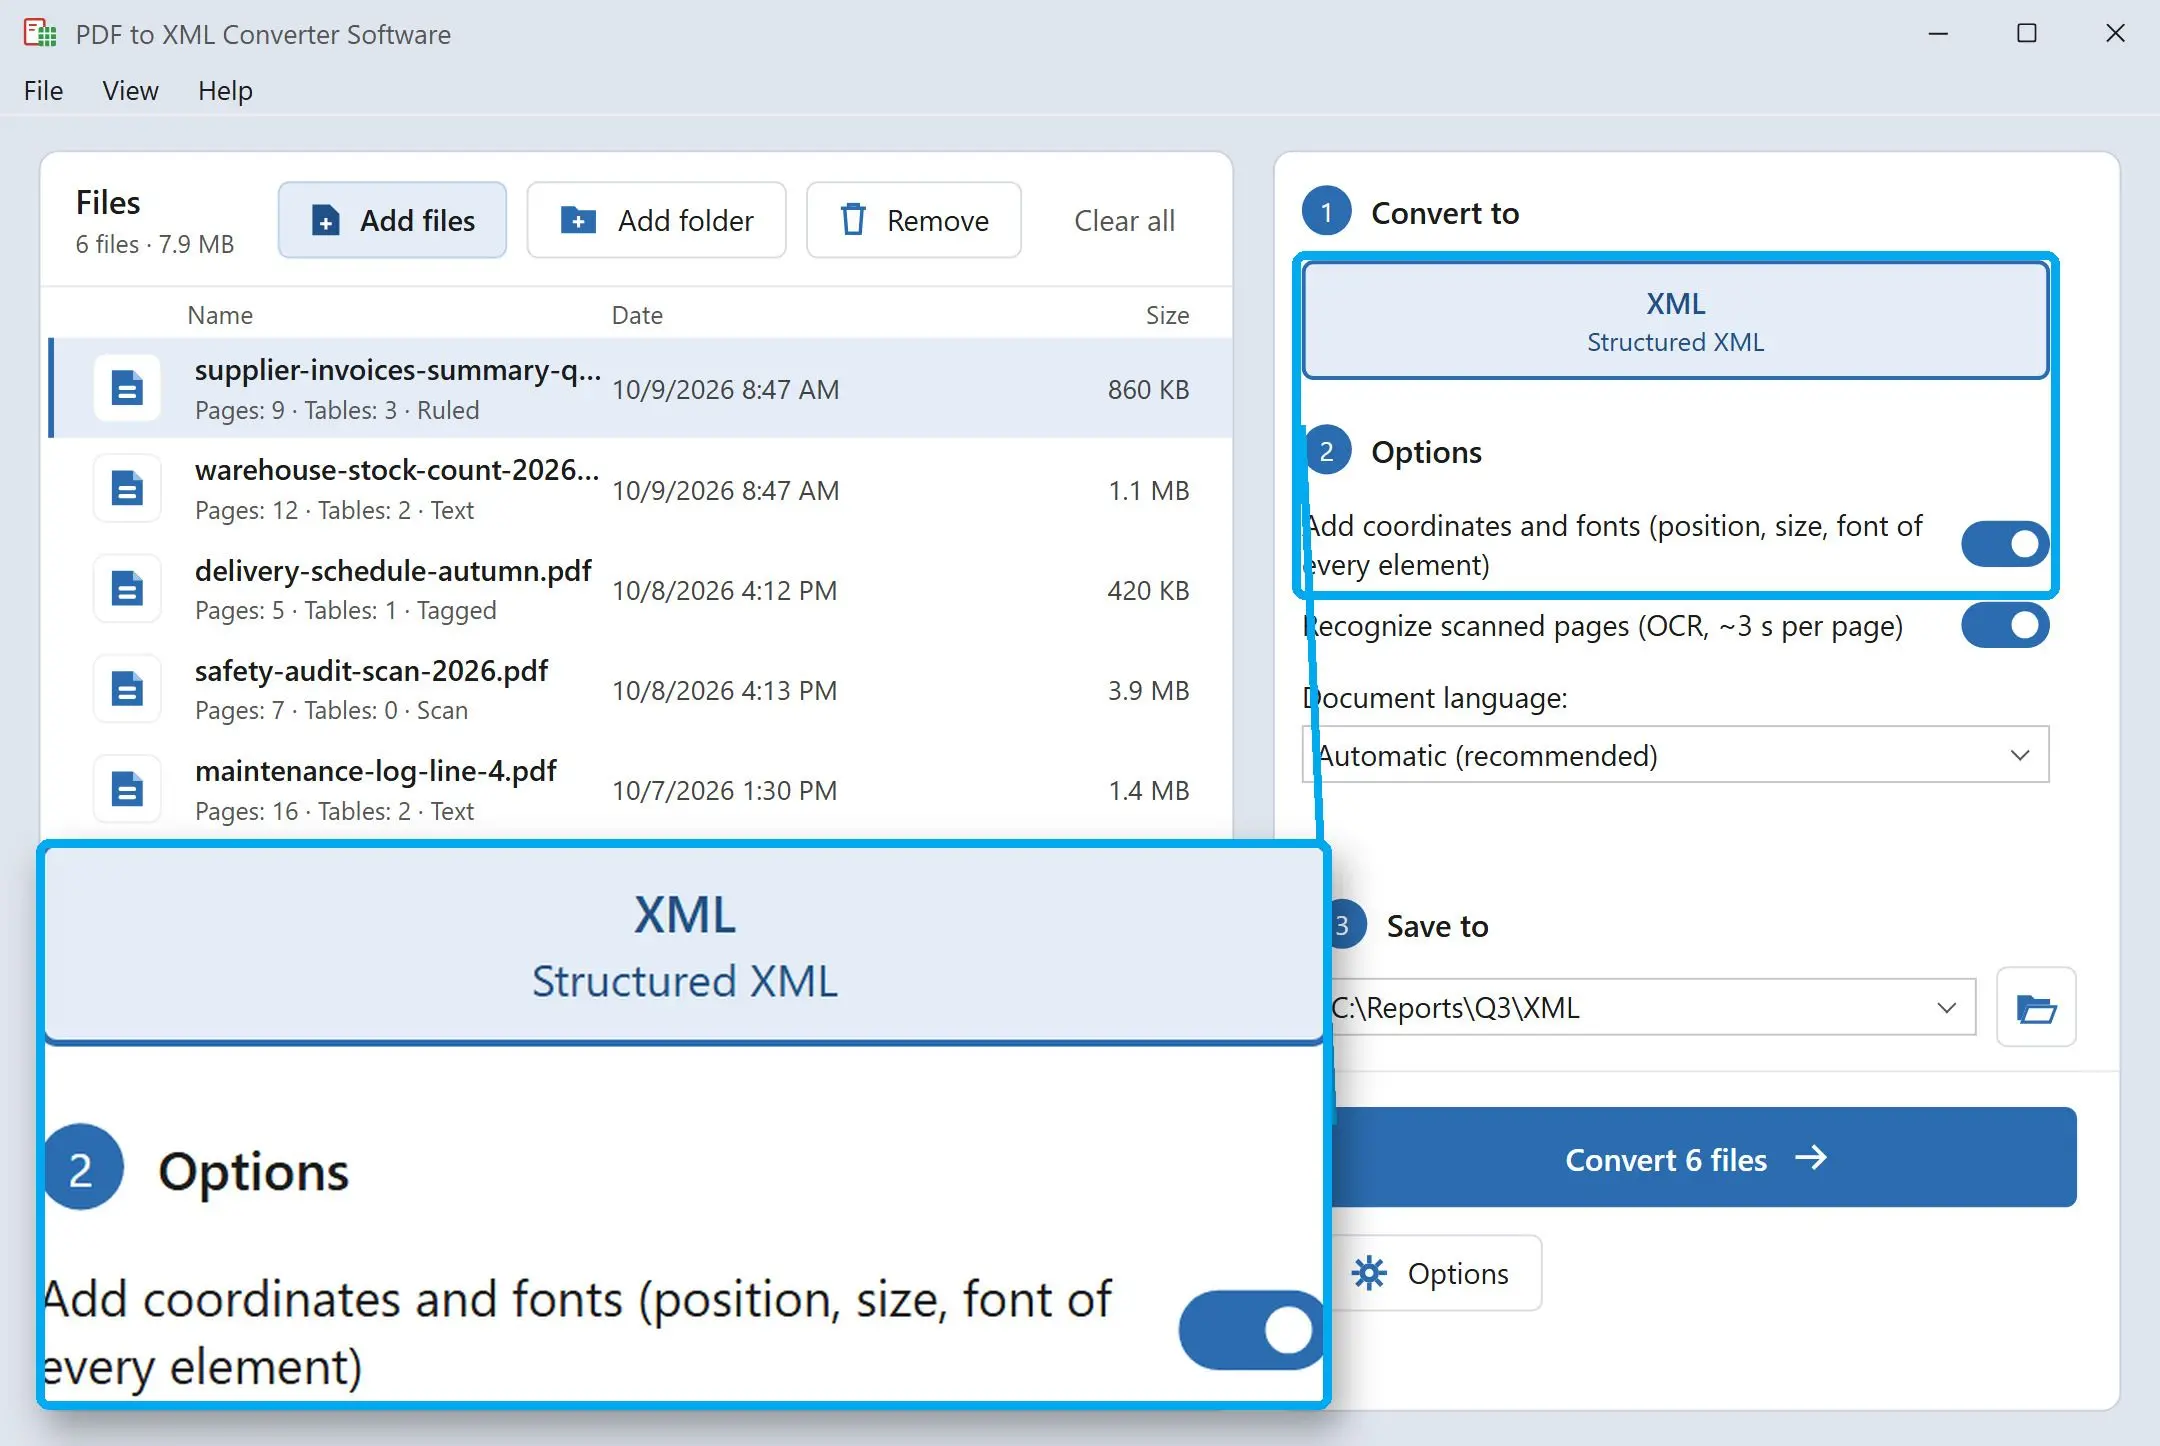
Laat coördinaten uit voor een compact bestand met alleen structuur en tekst. Zet ze aan en elk blok krijgt x, y, w en h in punten, een verwijzing naar een lettertype-item, en geneste line- en text-elementen - het detailniveau dat je van pdftohtml -xml zou verwachten.
Geef de bestanden aan je code
Elk bestand is goedgevormde UTF-8 zonder byte order mark. Lees het met ElementTree, lxml, XSLT of de XML-lader van je database; de elementnamen veranderen niet van het ene rapport op het andere.
Benefits
Tabellen komen als raster, niet als losse tekenreeksen
Elke tabel heeft zijn aantal rijen en kolommen, een kopregel gemarkeerd met header="1", en colspan of rowspan op samengevoegde cellen. Je lader kan kolomnamen uit de kopregel halen en van elke andere rij een record maken. Een tabel die over meerdere pagina's loopt, wordt als één tabel per pagina geschreven.
Eén schema voor elk bestand
document, page, heading, paragraph, table, row, cell - dezelfde namen en attributen in elke uitvoer, of de PDF nu van finance, een leverancier of een scanner komt. Wanneer het rapport van het volgende kwartaal binnenkomt, leest de import die je voor dit rapport schreef dat ook.
Draait op je eigen pc
Rapporten, contracten en prijslijsten worden lokaal gelezen en geschreven, zonder upload en zonder account. Vertrouwelijke documenten blijven buiten diensten van derden, en de taak draait op een machine zonder enige internettoegang.
Waarom mensen het gebruiken
Kopniveaus waarop je kunt vertrouwen
Niveaus 1 tot en met 6 worden bepaald uit de lettergrootte ten opzichte van de lopende tekst van het hele document, niet per pagina. Een hoofdstuktitel op pagina 40 krijgt hetzelfde niveau als die op pagina 2, zodat een zoekindex of inhoudsopgave erop kan vertrouwen.
Gescande pagina's worden gemarkeerd, niet verborgen
Een pagina zonder tekstlaag wordt gemarkeerd met scanned="1". Komt de tekst uit herkenning (Latijnse en Cyrillische schriften), dan krijgt de pagina ocr="1" en een betrouwbaarheidswaarde, en krijg je alleen alinea's - tabellen worden op herkende pagina's niet gedetecteerd. Je pipeline kan die pagina's naar een handmatige controle sturen.
Proza wordt niet voor een tabel aangezien
Grote ruimtes tussen woorden misleiden veel tabeldetectors, die van een artikel met twee kolommen een nepraster maken. Zulke kandidaten worden afgewezen, en elke echte tabel legt in zijn source-attribuut vast hoe hij is gevonden - uit PDF-tags, uit lijnen of uit tekstuitlijning.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note