PDF to Structured XML Exporter
Il contenuto del PDF come XML che un programma sa leggere
Converti file PDF in XML strutturato in blocco e offline: pagine, intestazioni, paragrafi e tabelle come righe e celle. Coordinate e font facoltativi per ogni blocco. Prova gratuita.
Full seller details: Legal information.
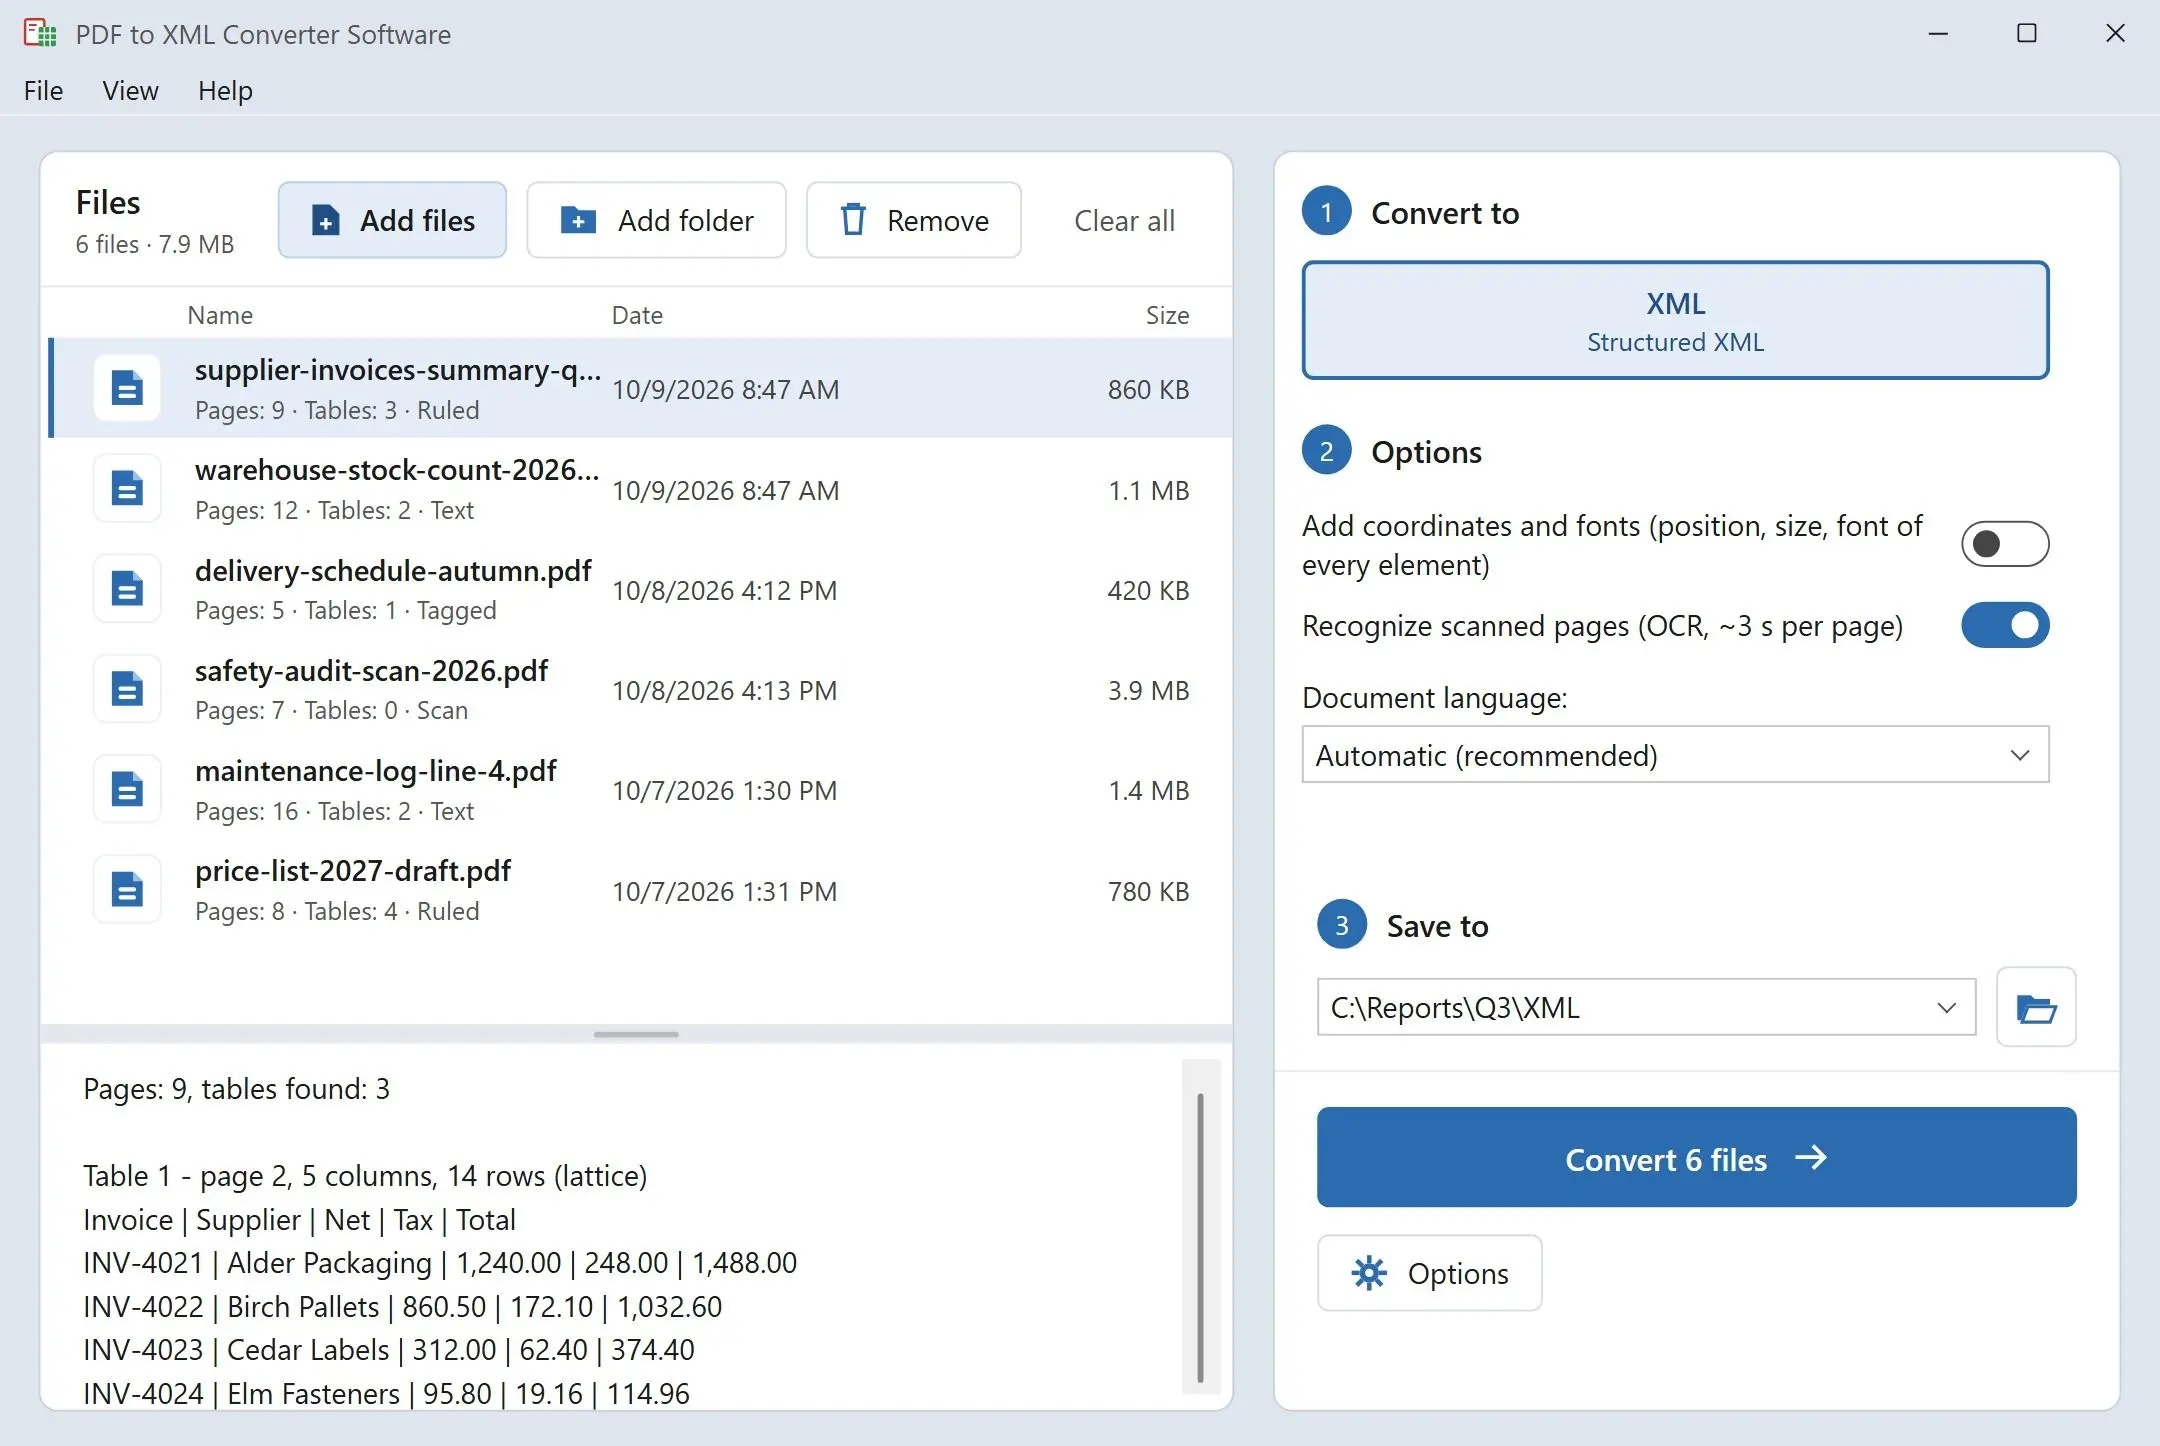
Dagli una cartella di report e ottieni un file XML per ogni PDF: un elemento page per ogni pagina, intestazioni con il loro livello, paragrafi e tabelle suddivise in righe e celle. Gira sul tuo PC Windows, quindi non viene caricato nulla.
Un PDF sa dove va l'inchiostro, non cosa significa
Dentro un PDF non esistono paragrafi, intestazioni né tabelle: solo frammenti di testo posizionati su coordinate in una pagina. Va bene per stampare ed è inutile per uno script di importazione. L'esportazione XML degli editor PDF descrive per lo più quell'impaginazione, e i siti di caricamento raramente dicono come è costruito il loro output. Questo programma ricostruisce invece la struttura: raggruppa le righe in paragrafi, classifica le intestazioni per dimensione del font, trova le griglie delle tabelle e scrive tutto sempre con lo stesso schema, così il codice che lo legge non deve indovinare.
How to use it
Carica i PDF
Aggiungi singoli file o un'intera cartella. Ogni PDF ottiene il proprio file XML con il nome della sorgente, e il programma chiede una volta per blocco prima di sostituire un output precedente.
Scegli output leggero o dettagliato
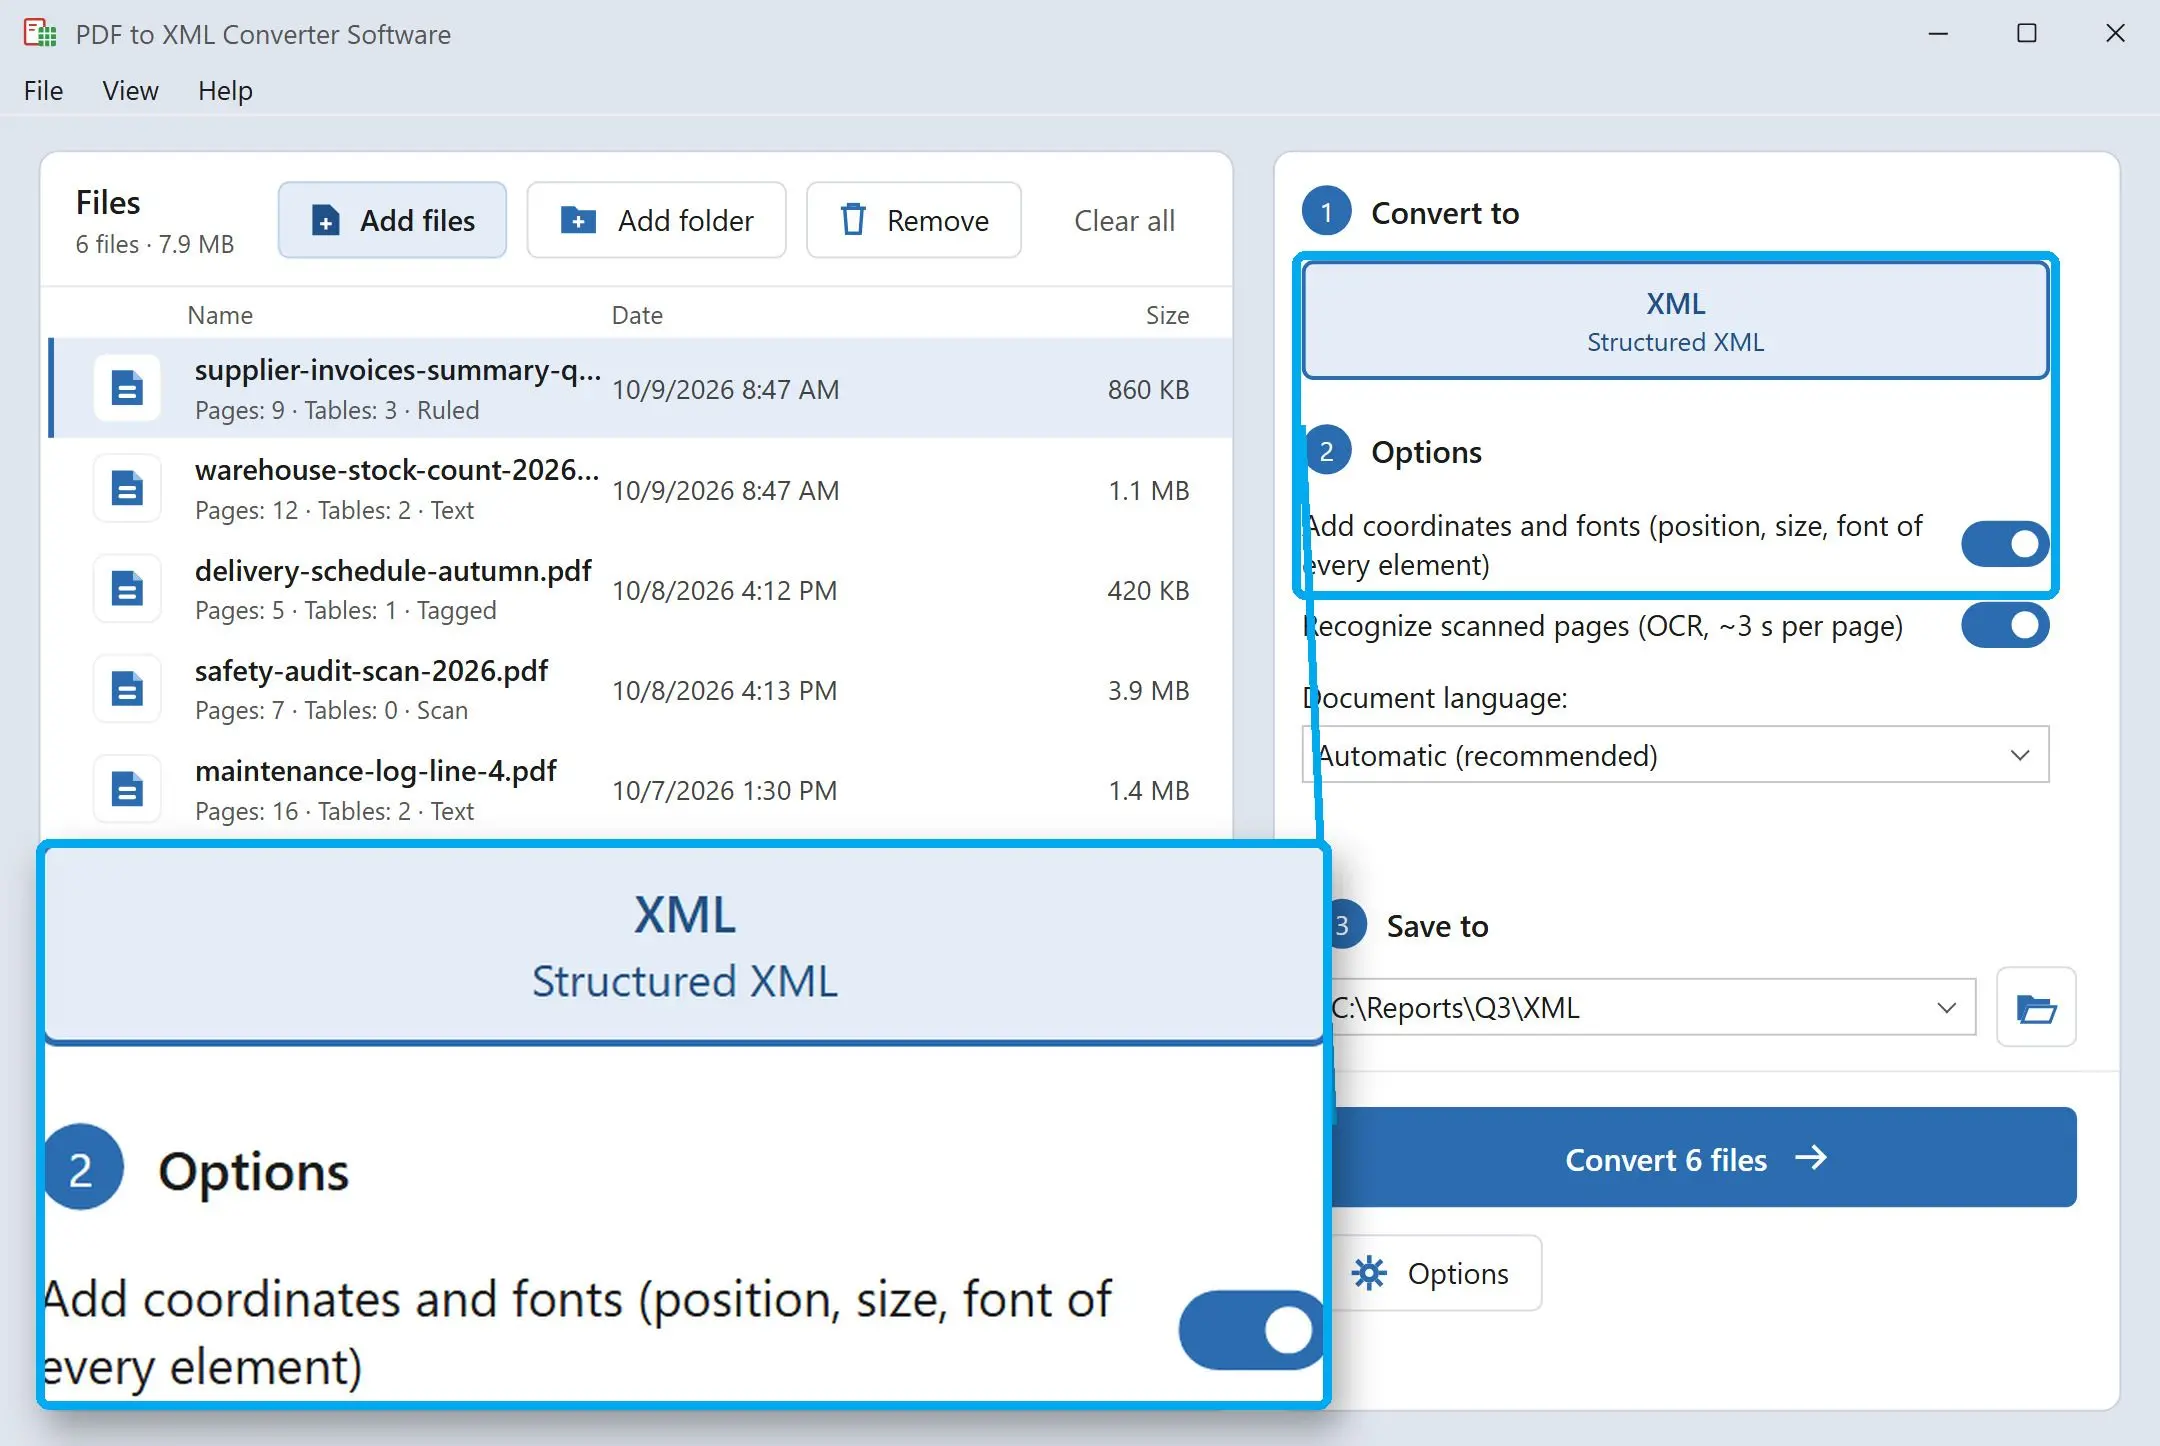
Lascia disattivate le coordinate per un file compatto con solo struttura e testo. Attivale e ogni blocco ottiene x, y, w e h in punti, un riferimento a una voce di font ed elementi annidati di riga e di testo: il livello di dettaglio che ti aspetteresti da pdftohtml -xml.
Passa i file al tuo codice
Ogni file è UTF-8 ben formato senza byte order mark. Leggilo con ElementTree, lxml, XSLT o il caricatore XML del tuo database; i nomi degli elementi non cambiano da un report all'altro.
Benefits
Le tabelle arrivano come griglia, non come stringhe sciolte
Ogni tabella riporta il numero di righe e colonne, una riga di intestazione contrassegnata con header="1", e colspan o rowspan sulle celle unite. Il tuo caricatore può prendere i nomi delle colonne dall'intestazione e trasformare ogni altra riga in un record. Una tabella che si estende su più pagine viene scritta come una tabella per pagina.
Uno schema per ogni file
document, page, heading, paragraph, table, row, cell: stessi nomi e attributi in ogni output, che il PDF provenga dall'amministrazione, da un fornitore o da uno scanner. Quando arriva il report del trimestre successivo, l'importazione che hai scritto per questo lo legge allo stesso modo.
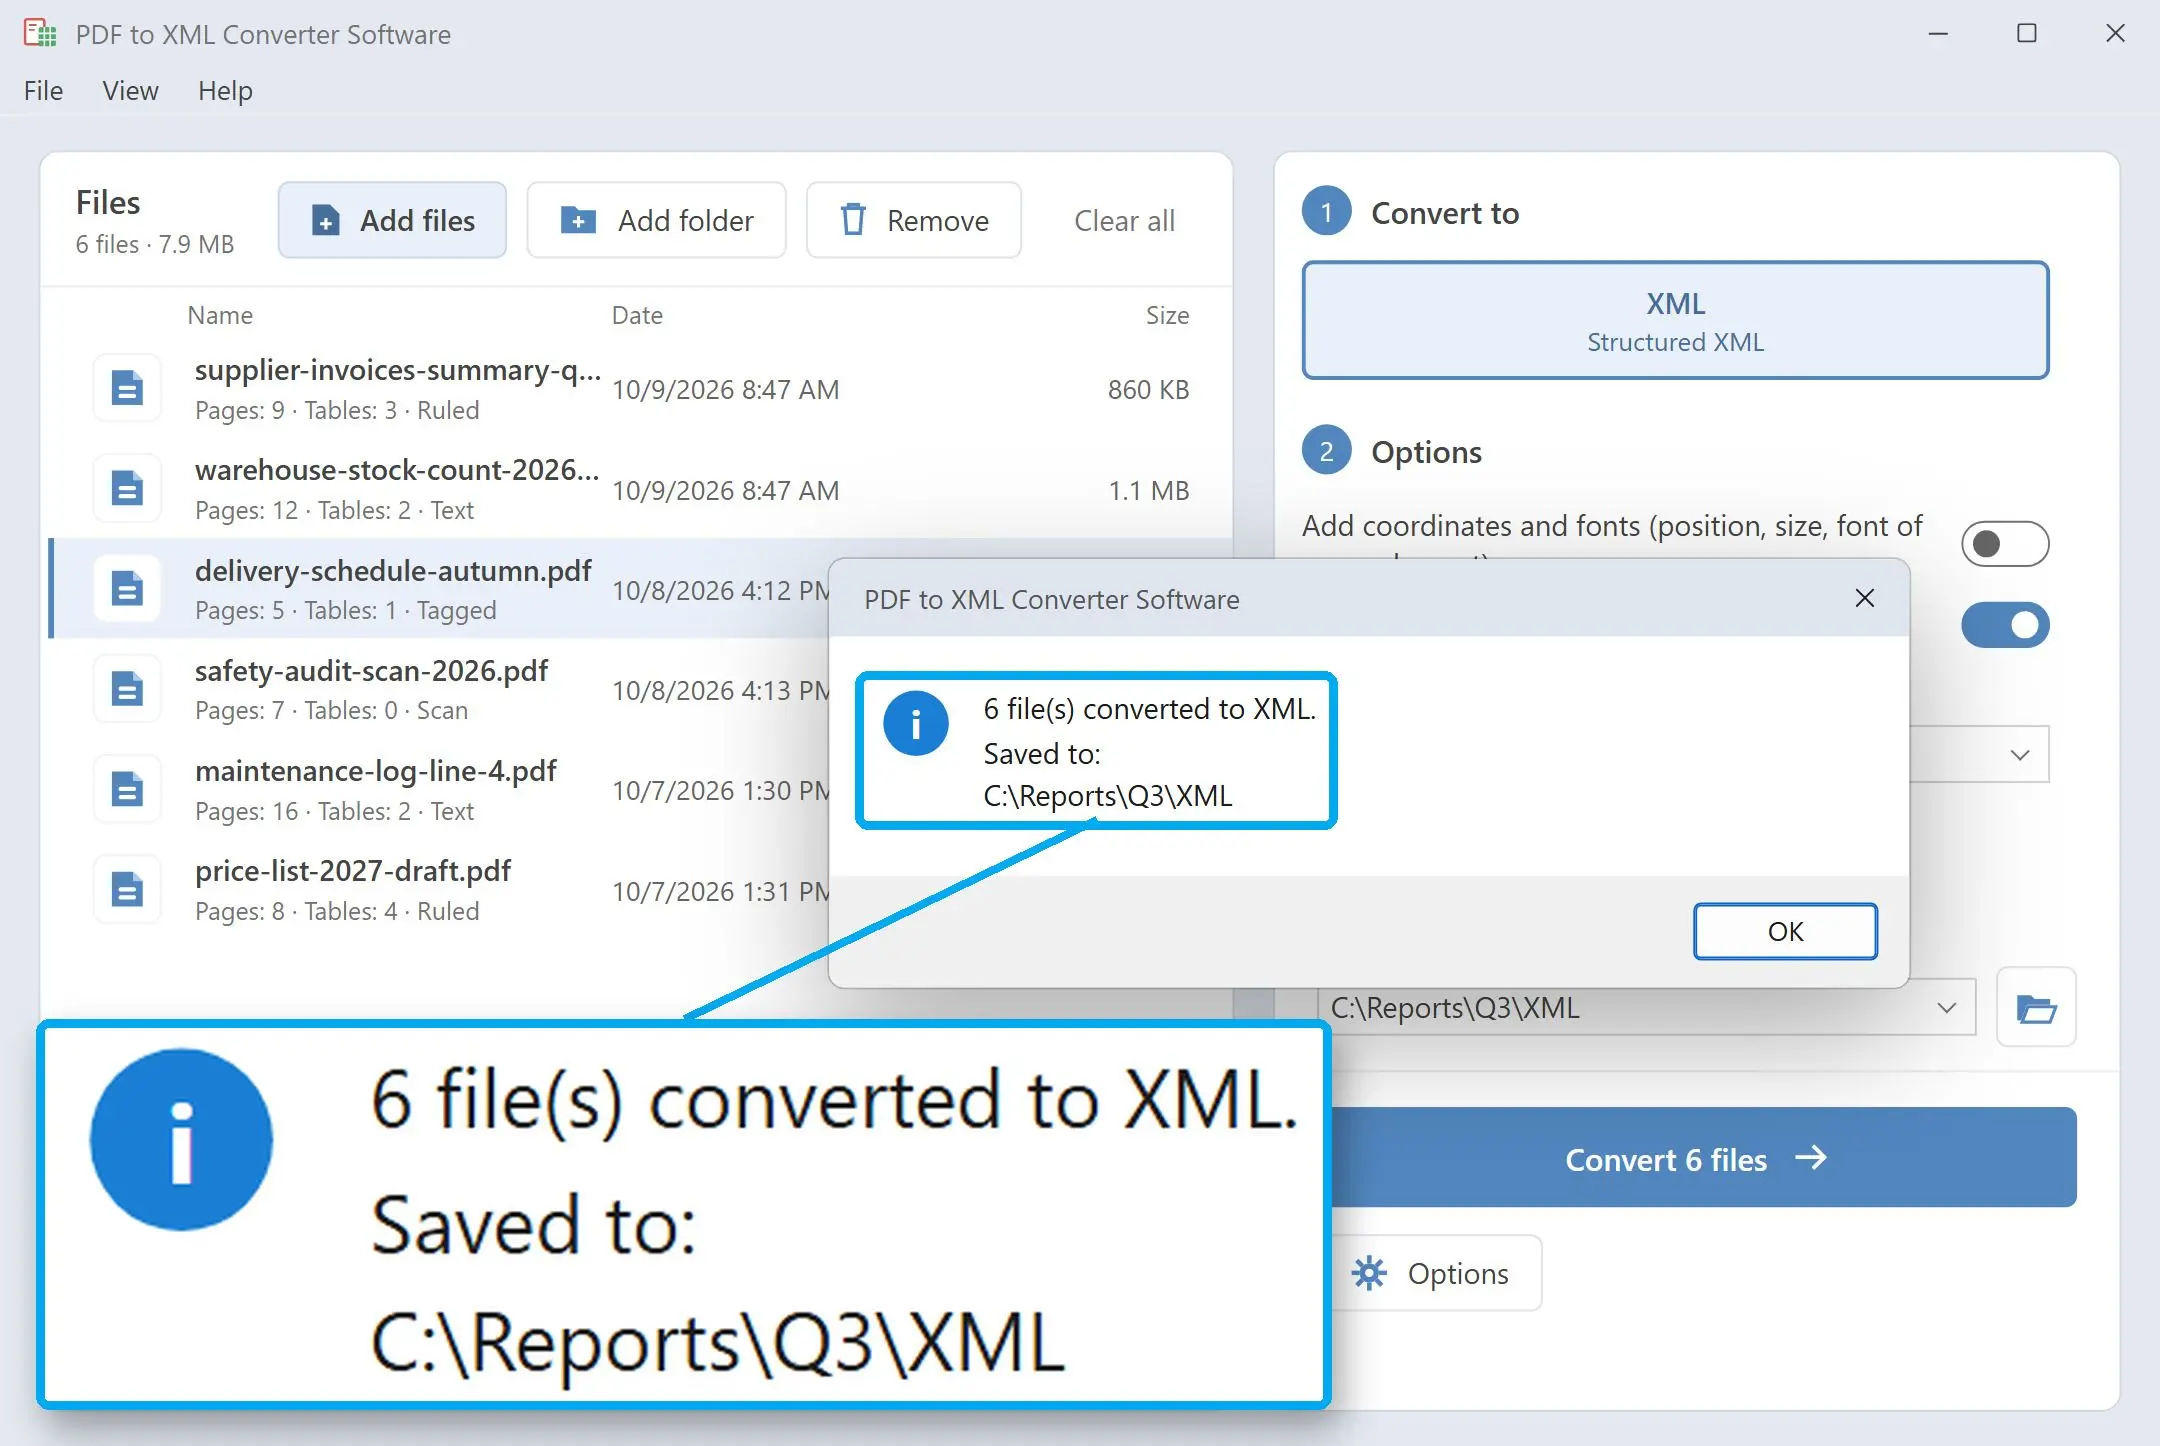
Gira sul tuo PC
Report, contratti e listini vengono letti e scritti in locale, senza caricamenti né account. I documenti riservati restano fuori dai servizi di terze parti, e il lavoro gira su una macchina senza alcun accesso a internet.
Perché le persone lo usano
Livelli di intestazione su cui puoi contare
I livelli da 1 a 6 sono assegnati in base alla dimensione del font rispetto al testo del corpo dell'intero documento, non pagina per pagina. Il titolo di un capitolo a pagina 40 ottiene lo stesso livello di quello a pagina 2, quindi un indice di ricerca o un sommario possono fidarsene.
Le pagine scansionate sono segnalate, non nascoste
Una pagina senza strato di testo è contrassegnata con scanned="1". Quando il suo testo deriva dal riconoscimento (alfabeti latino e cirillico), la pagina riporta ocr="1" e un valore di confidenza, e ottieni solo paragrafi: nelle pagine riconosciute le tabelle non vengono rilevate. La tua pipeline può inviare quelle pagine a un controllo manuale.
La prosa non viene scambiata per una tabella
Ampi spazi tra le parole ingannano molti rilevatori di tabelle, che trasformano un articolo a due colonne in una finta griglia. I candidati di questo tipo vengono scartati, e ogni tabella vera registra come è stata trovata (dai tag del PDF, dalle linee di riga o dall'allineamento del testo) nel suo attributo source.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note