PDF to Structured XML Exporter
PDF-innehåll som XML som ett program kan läsa
Konvertera PDF-filer till strukturerad XML i bulk, offline: sidor, rubriker, stycken och tabeller som rader och celler. Valfria koordinater och typsnitt för varje block. Gratis provperiod.
Full seller details: Legal information.
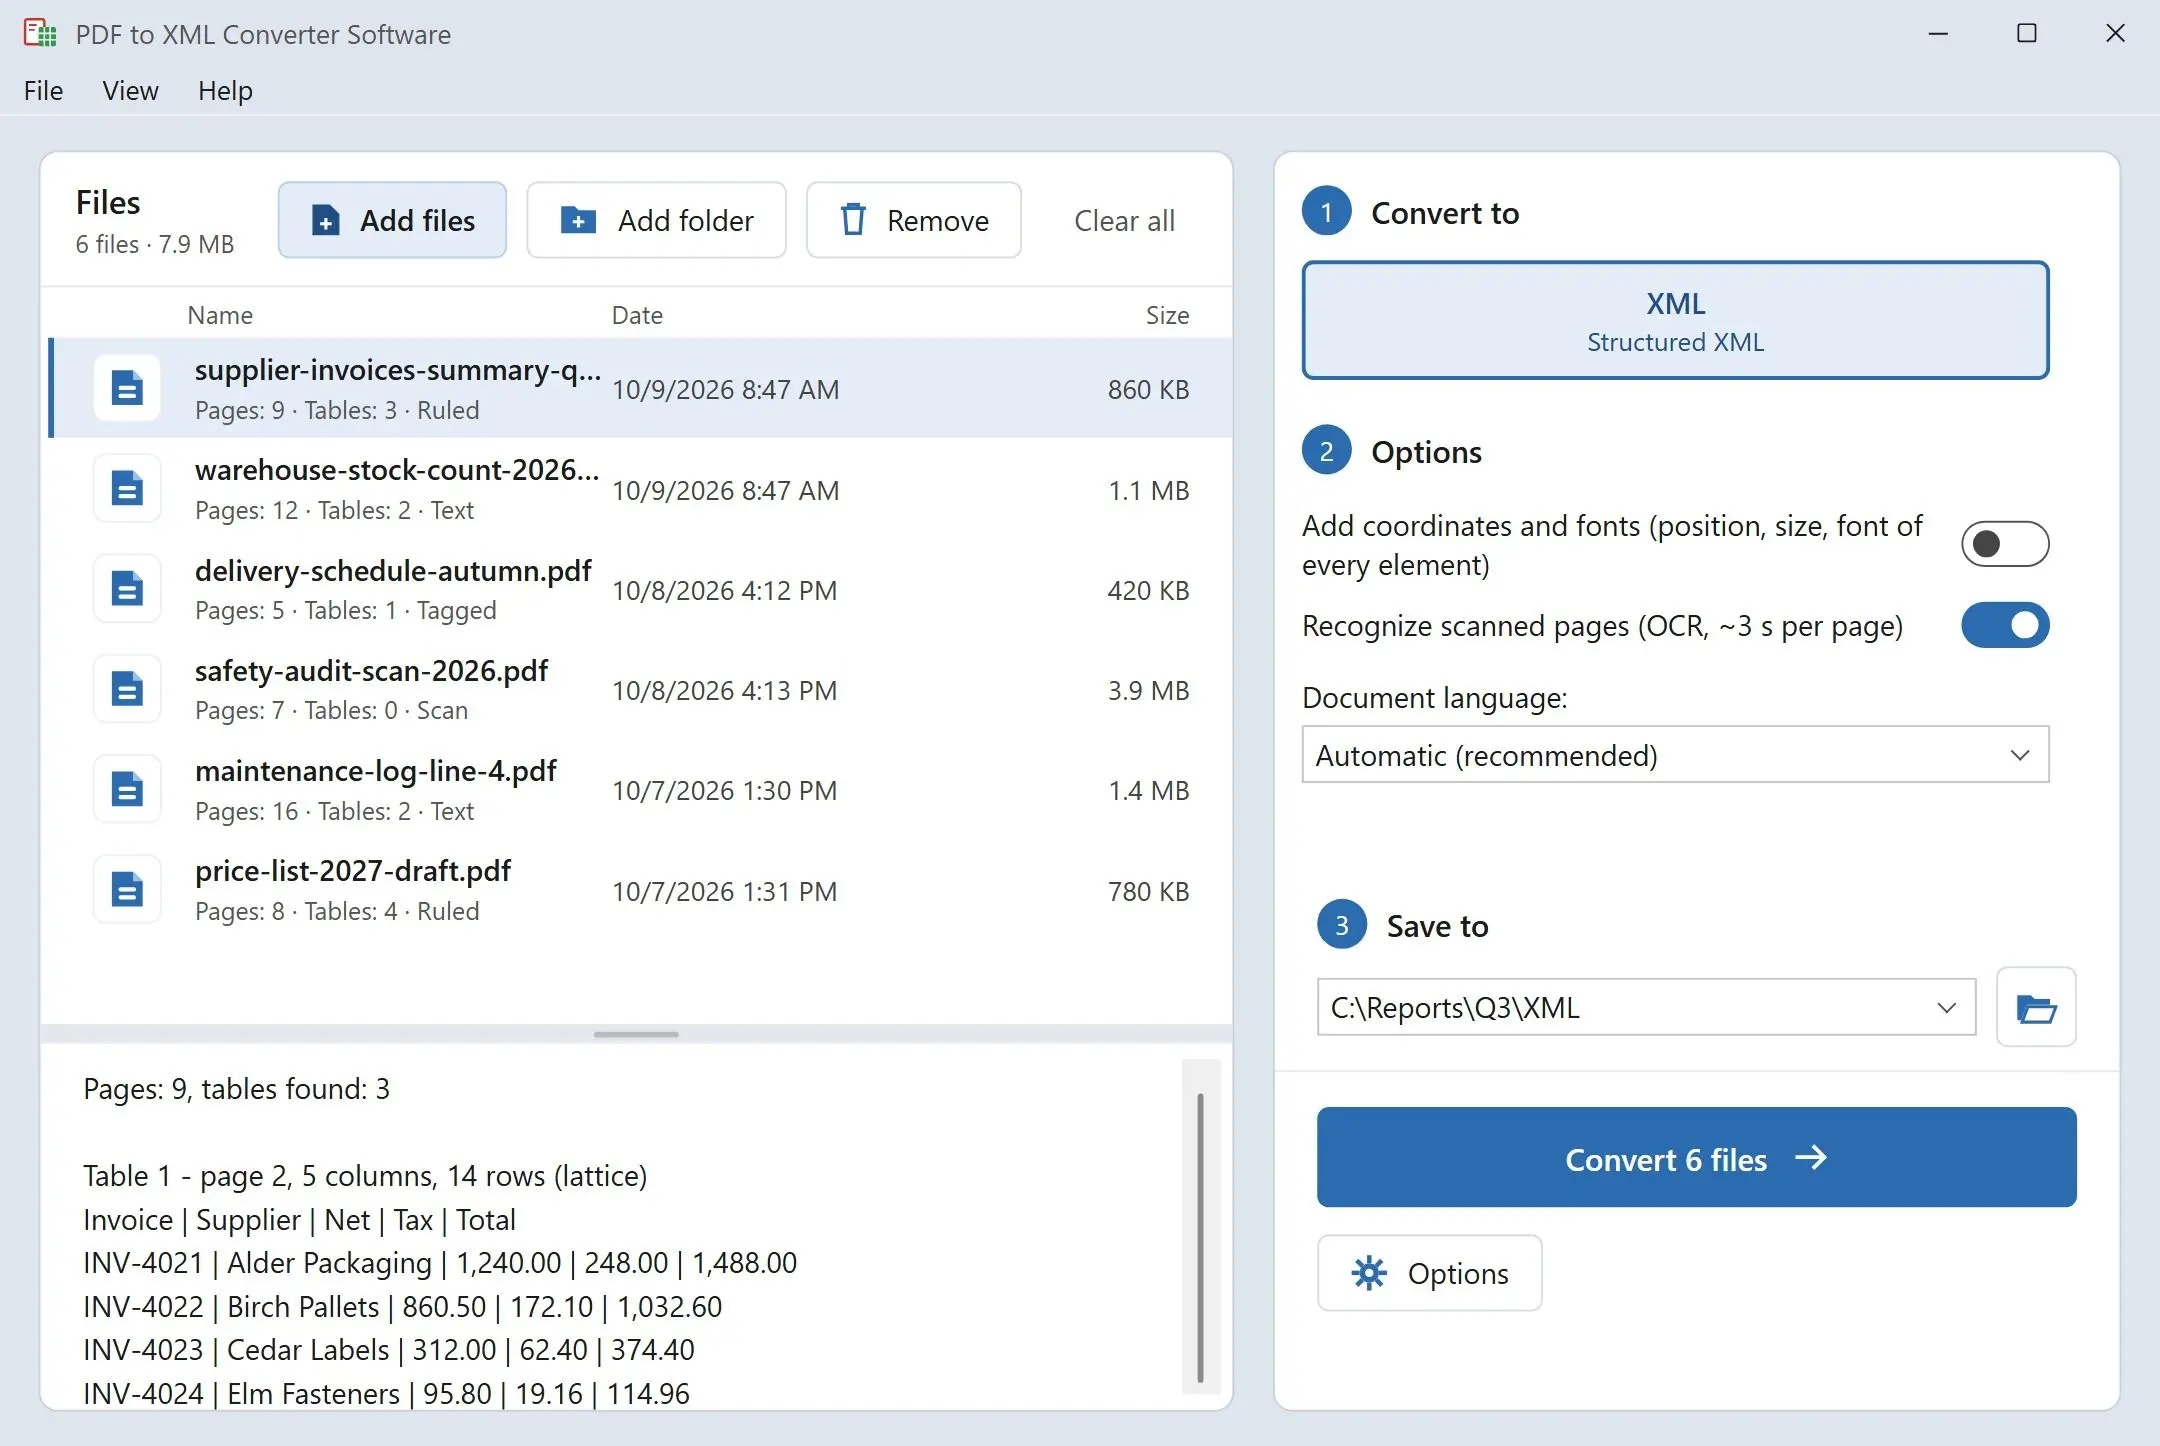
Mata in en mapp med rapporter och få en XML-fil per PDF: ett sidelement för varje sida, rubriker med sin nivå, stycken och tabeller uppdelade i rader och celler. Det körs på din Windows-dator, så ingenting laddas upp.
En PDF vet var färgen hamnar, inte vad den betyder
Inne i en PDF finns inget stycke, ingen rubrik och ingen tabell - bara bitar av text placerade vid koordinater på en sida. Det går bra för utskrift och är värdelöst för ett importskript. XML-exporten i PDF-redigerare beskriver mest den layouten, och uppladdningssajter säger sällan hur deras utdata är uppbyggt. Det här programmet bygger i stället upp strukturen: det grupperar rader till stycken, rangordnar rubriker efter teckenstorlek, hittar tabellrutnät och skriver allt enligt samma schema varje gång, så koden som läser det inte behöver gissa.
How to use it
Läs in PDF-filerna
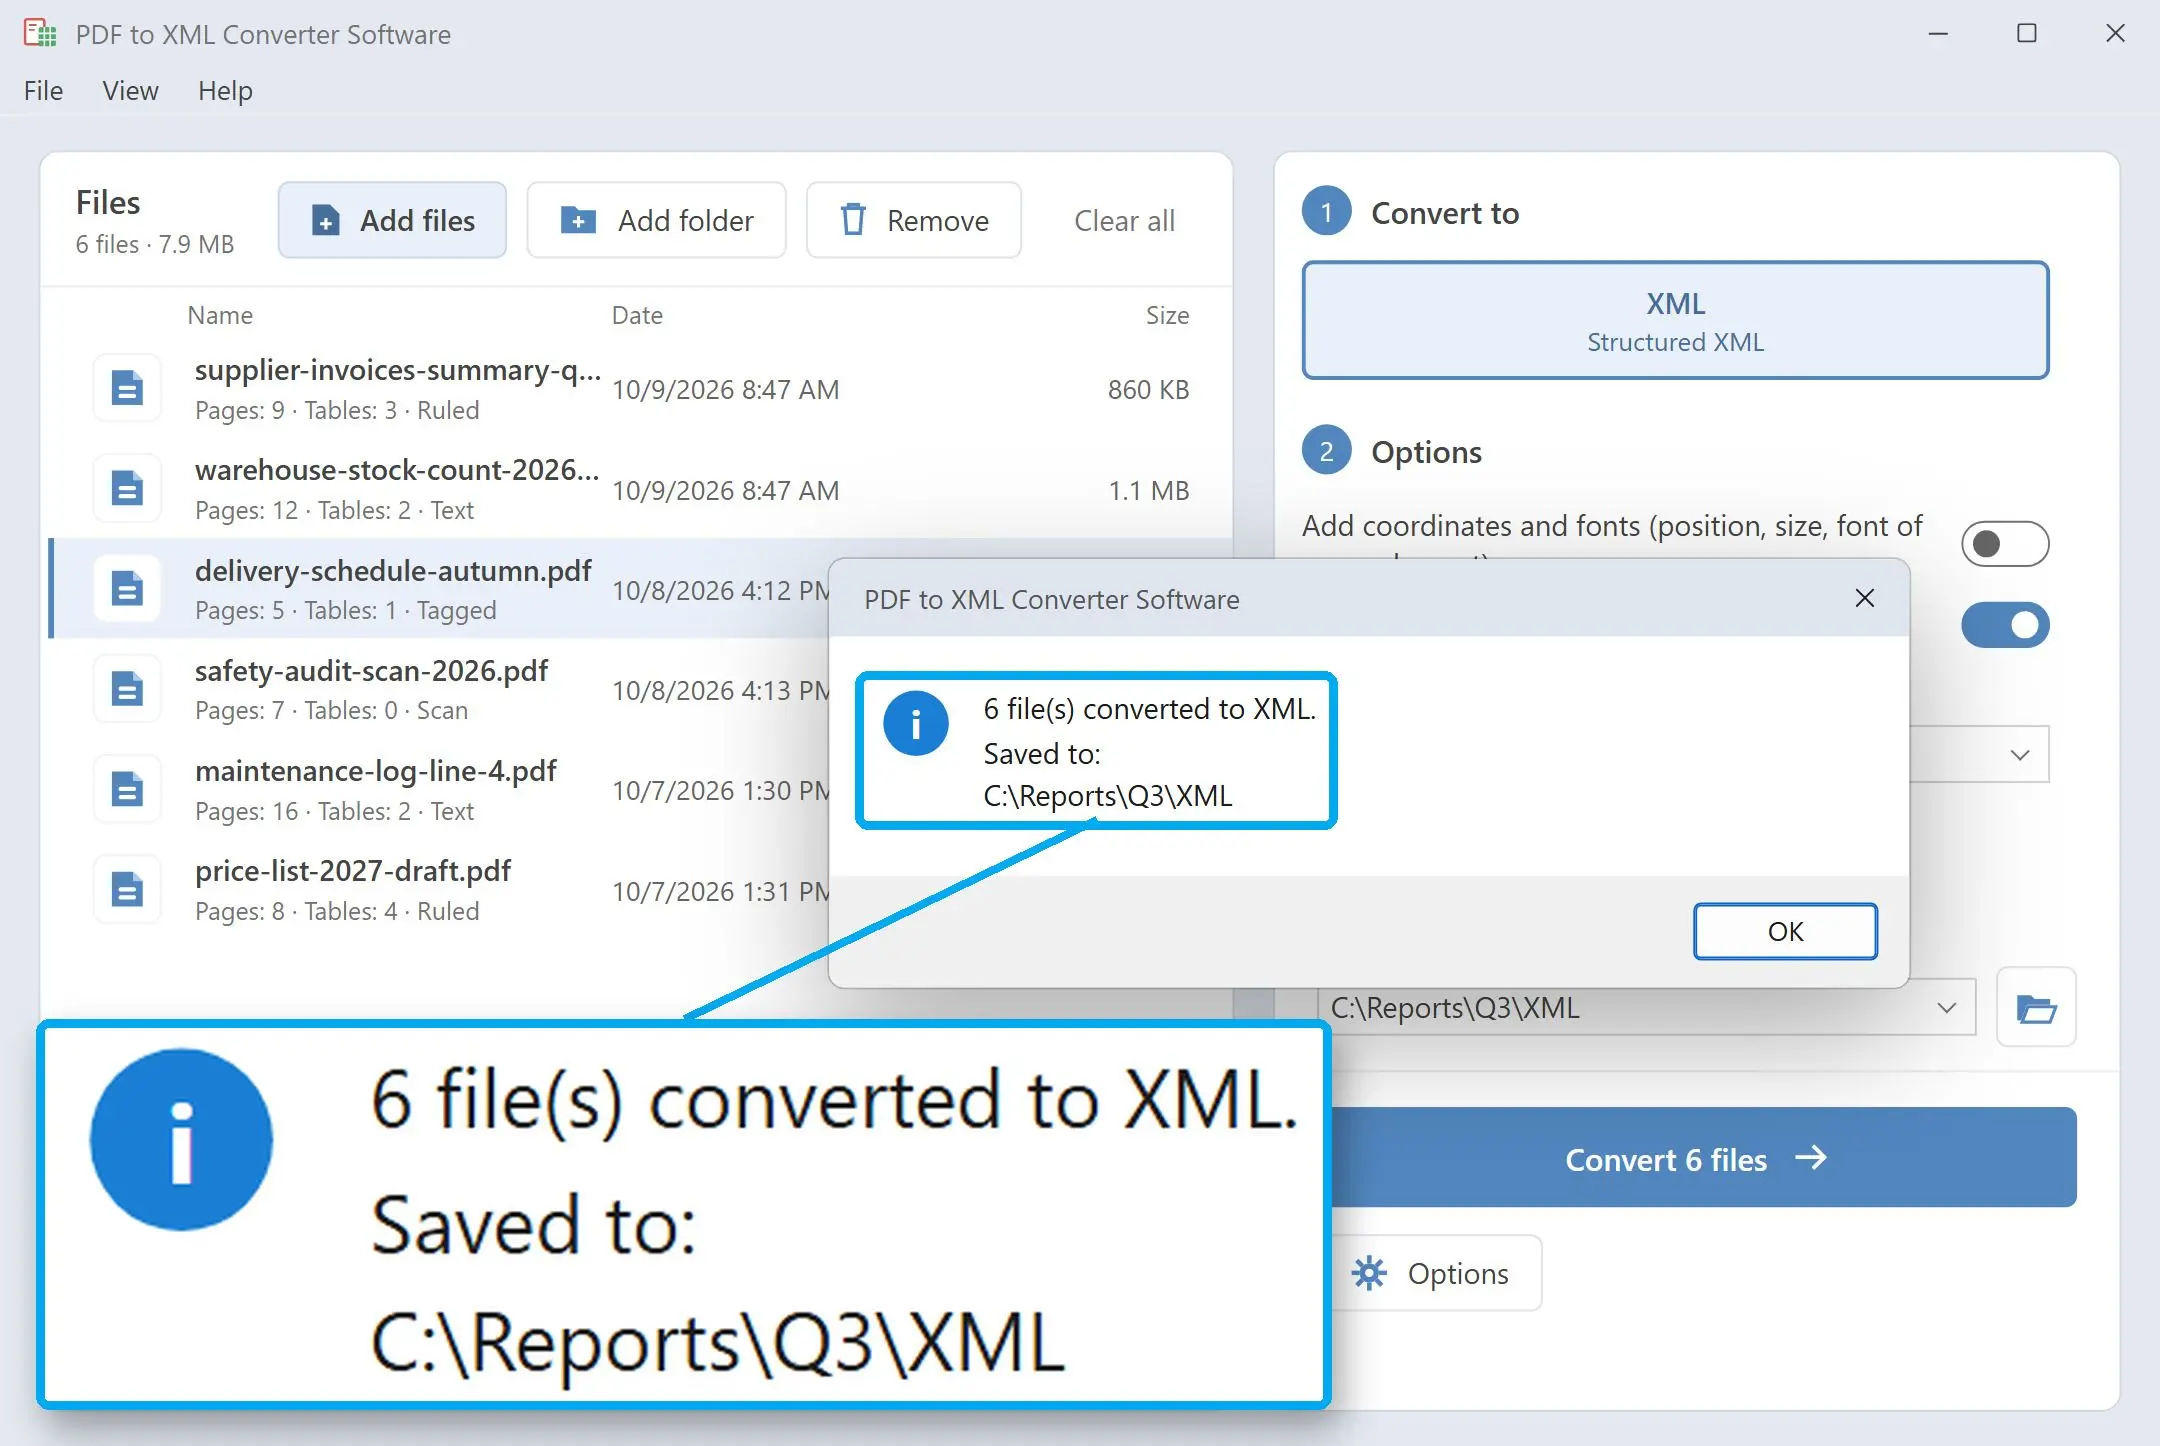
Lägg till enskilda filer eller en hel mapp. Varje PDF får sin egen XML-fil uppkallad efter källan, och programmet frågar en gång per bulkkörning innan det ersätter äldre utdata.
Välj lätt eller detaljerad utdata
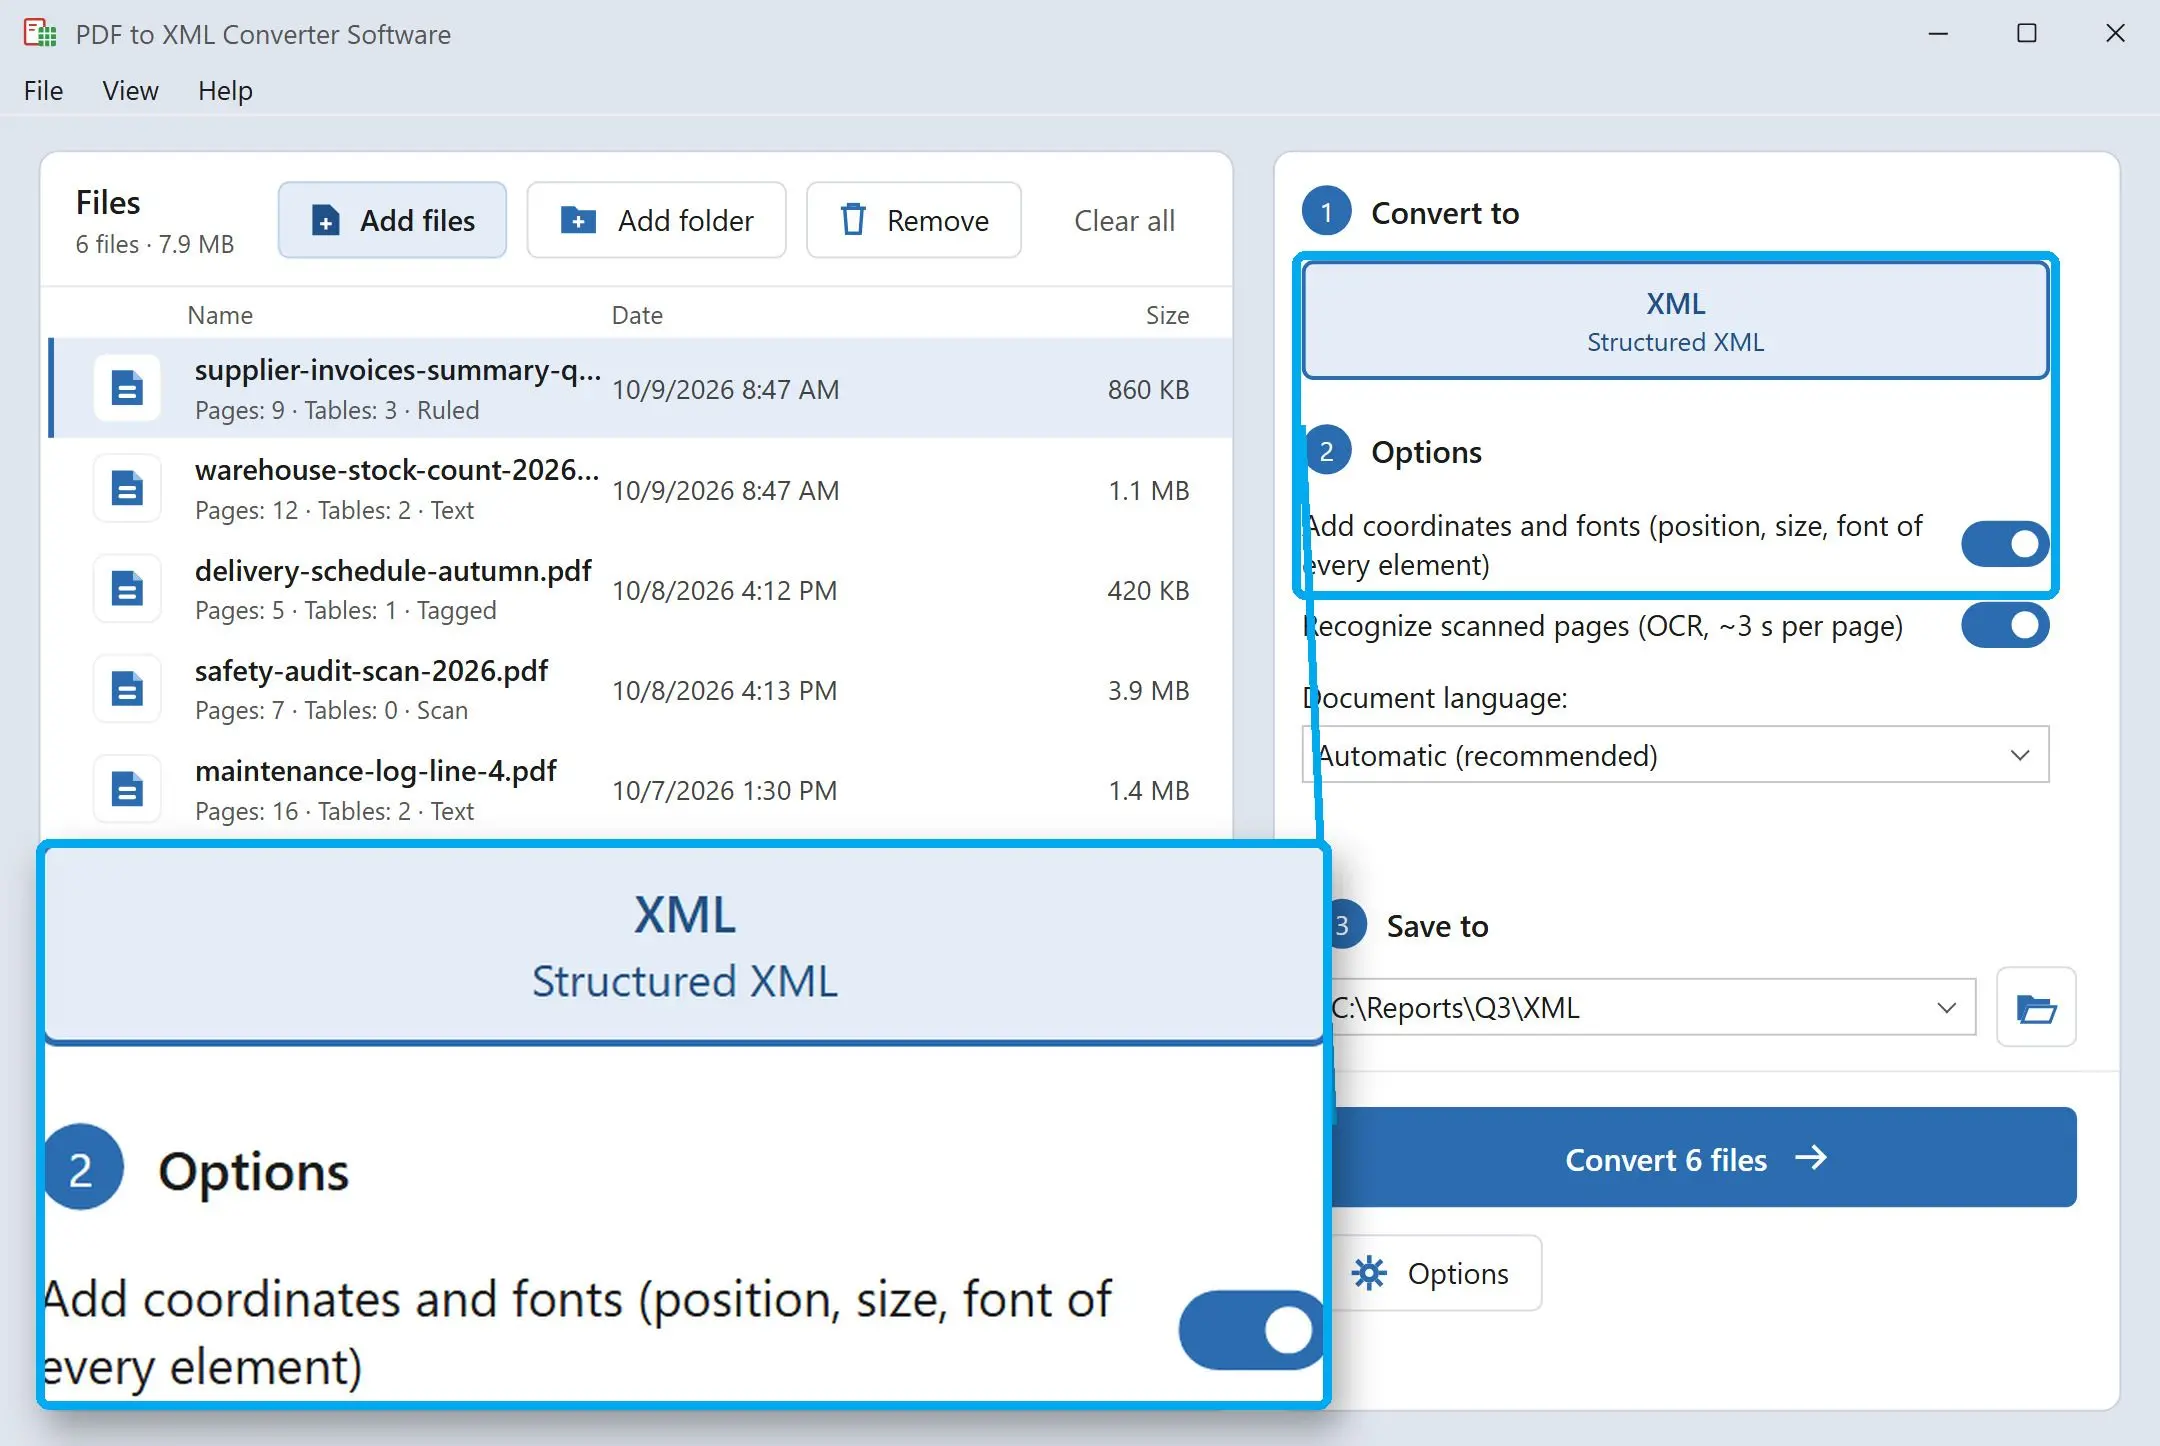
Lämna koordinaterna av för en kompakt fil med bara struktur och text. Slå på dem så får varje block x, y, w och h i punkter, en referens till en typsnittspost samt nästlade rad- och textelement - den detaljnivå du kan vänta dig av pdftohtml -xml.
Lämna över filerna till din kod
Varje fil är välformad UTF-8 utan byte order mark. Läs den med ElementTree, lxml, XSLT eller XML-inläsaren i din databas; elementnamnen ändras inte från en rapport till nästa.
Benefits
Tabeller kommer som ett rutnät, inte lösa strängar
Varje tabell har sitt antal rader och kolumner, en rubrikrad markerad header="1" samt colspan eller rowspan på sammanslagna celler. Din inläsare kan hämta kolumnnamn från rubriken och göra varje annan rad till en post. En tabell som löper över flera sidor skrivs som en tabell per sida.
Ett schema för varje fil
document, page, heading, paragraph, table, row, cell - samma namn och attribut i varje utdata, oavsett om PDF-filen kom från ekonomi, en leverantör eller en skanner. När nästa kvartals rapport kommer läser importen du skrev för den här även den.
Körs på din egen dator
Rapporter, kontrakt och prislistor läses och skrivs lokalt, utan uppladdning och utan konto. Konfidentiella dokument hålls borta från tredjepartstjänster, och jobbet går att köra på en maskin helt utan internetåtkomst.
Varför folk använder det
Rubriknivåer du kan lita på
Nivå 1 till 6 sätts utifrån teckenstorlek jämfört med brödtexten i hela dokumentet, inte sida för sida. En kapitelrubrik på sidan 40 får samma nivå som den på sidan 2, så ett sökindex eller en innehållsförteckning kan lita på det.
Skannade sidor flaggas, de döljs inte
En sida utan textlager markeras scanned="1". När dess text kommer från igenkänning (latinska och kyrilliska skriftsystem) får sidan ocr="1" och ett konfidensvärde, och du får bara stycken - tabeller upptäcks inte på igenkända sidor. Din pipeline kan skicka de sidorna till en manuell kontroll.
Löpande text förväxlas inte med en tabell
Breda mellanrum mellan ord lurar många tabelldetektorer att göra en tvåkolumnsartikel till ett falskt rutnät. Sådana kandidater förkastas, och varje riktig tabell registrerar hur den hittades - från PDF-taggar, från linjer eller från textjustering - i sitt source-attribut.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note