PDF to Structured XML Exporter
Treść PDF jako XML, który program potrafi odczytać
Konwertuj pliki PDF na ustrukturyzowany XML wsadowo, offline: strony, nagłówki, akapity i tabele jako wiersze i komórki. Opcjonalnie współrzędne i czcionki każdego bloku. Bezpłatna wersja próbna.
Full seller details: Legal information.
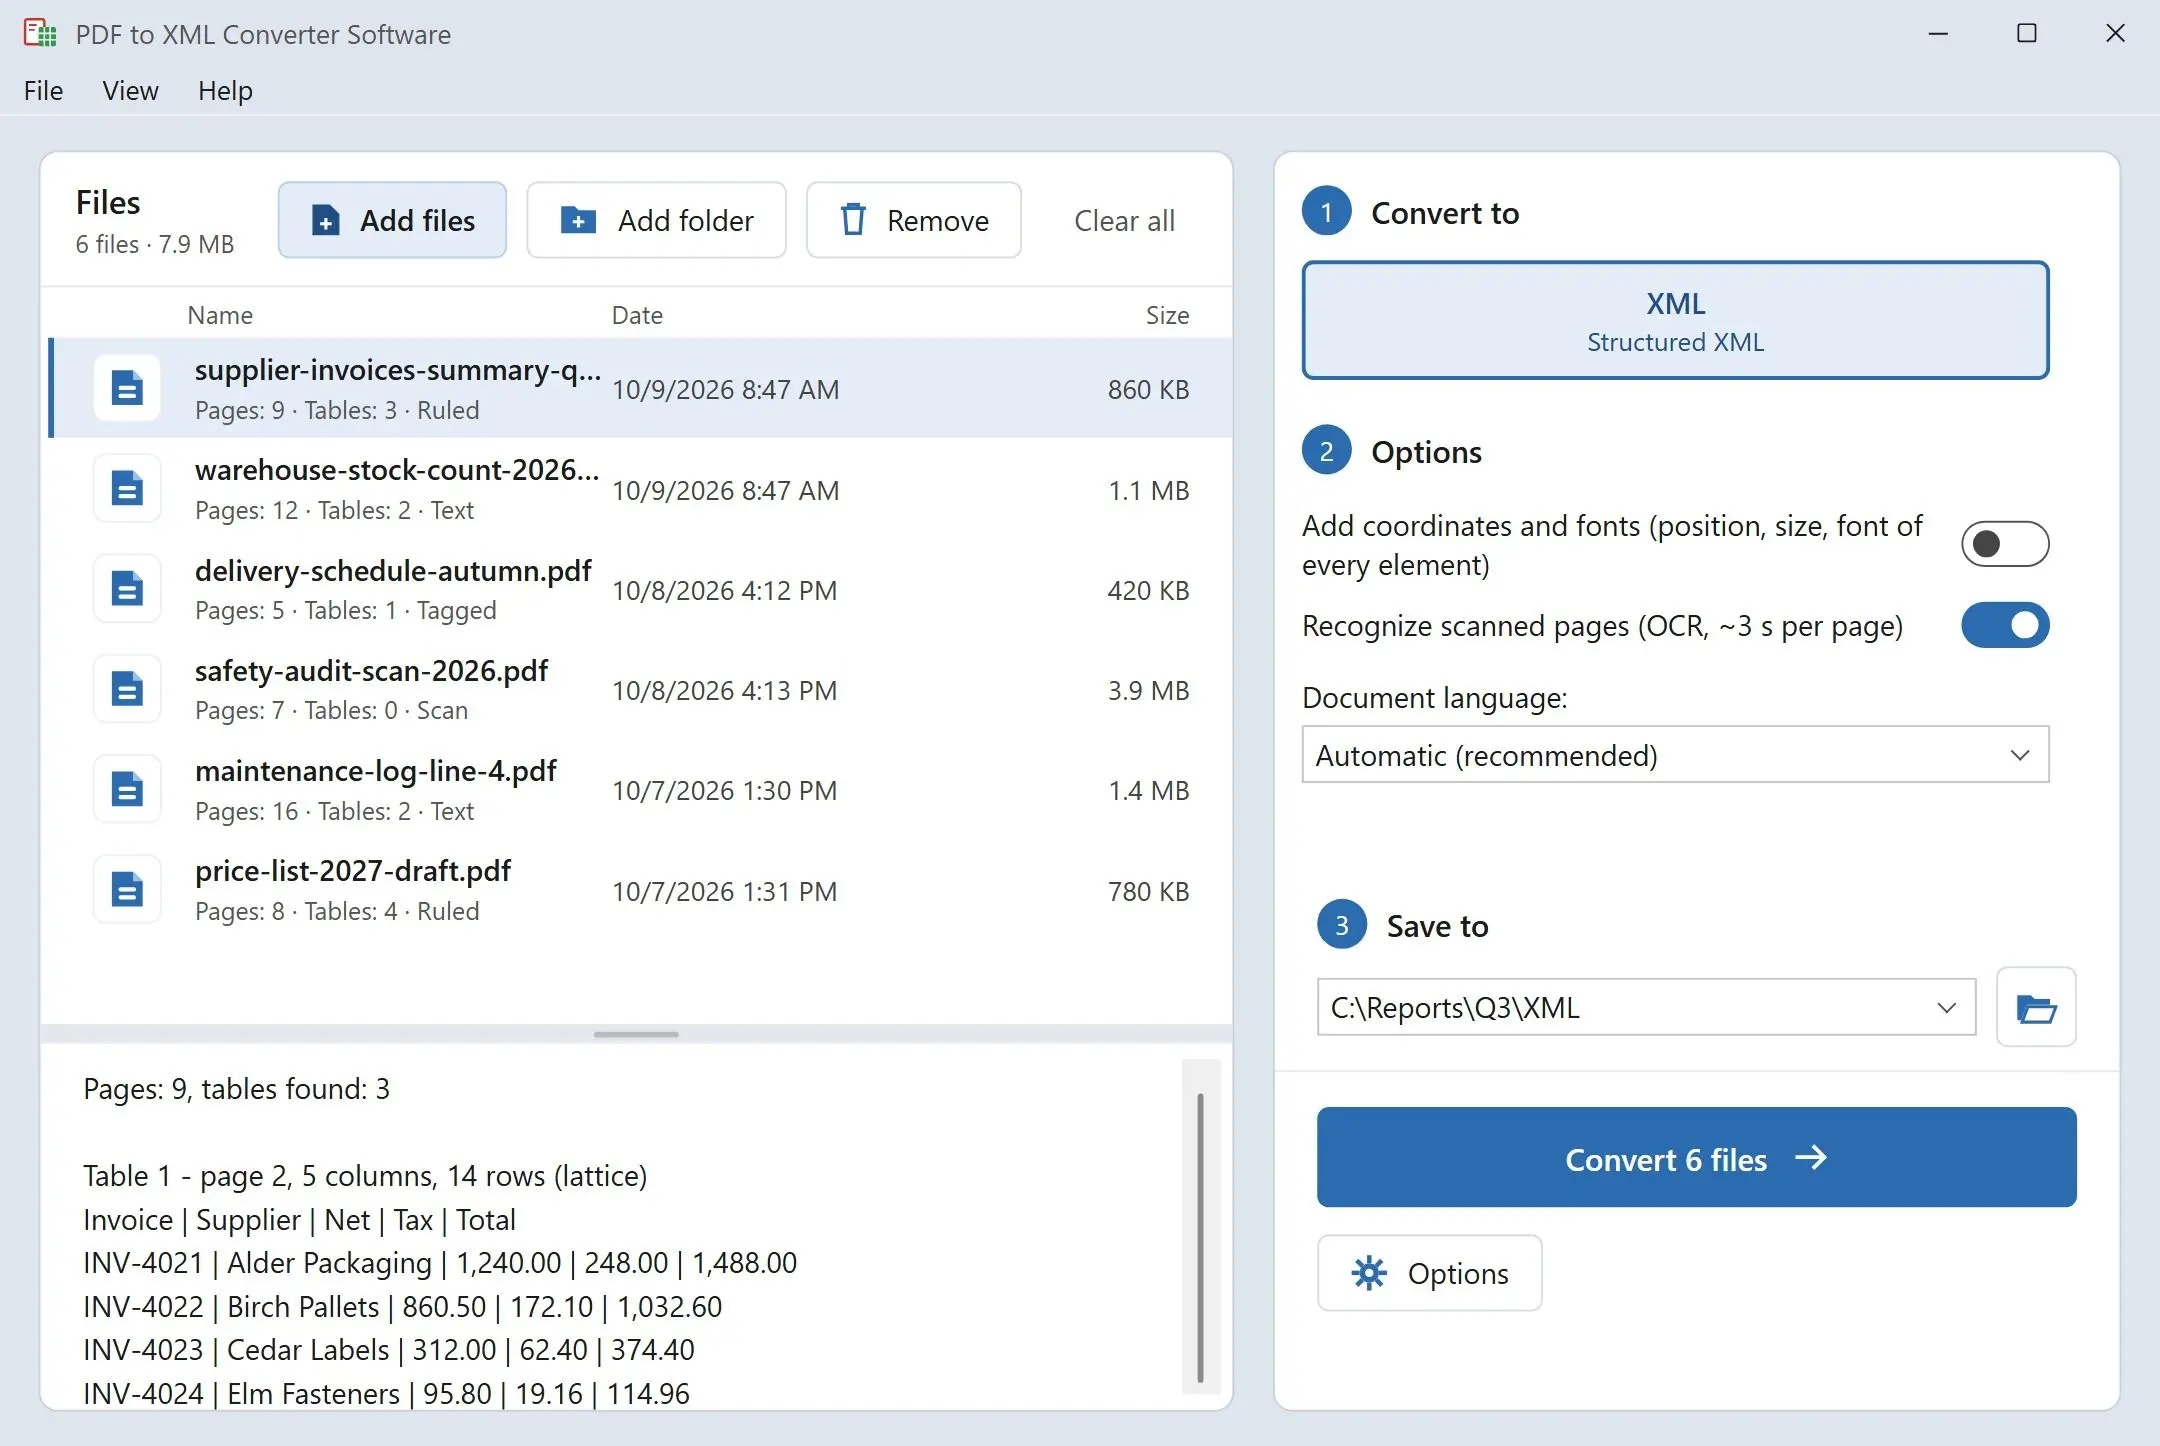
Podaj folder z raportami i dostań po jednym pliku XML na PDF: element strony dla każdej strony, nagłówki z poziomem, akapity oraz tabele rozbite na wiersze i komórki. Działa na Twoim komputerze z Windows, więc nic nie jest wgrywane.
PDF wie, gdzie trafia tusz, a nie co to znaczy
W PDF nie ma akapitu, nagłówka ani tabeli - są tylko fragmenty tekstu umieszczone we współrzędnych na stronie. To wystarcza do druku, a jest bezużyteczne dla skryptu importu. Eksport XML w edytorach PDF opisuje głównie ten układ, a strony do wgrywania rzadko mówią, jak zbudowany jest ich wynik. Ten program odtwarza strukturę: grupuje wiersze w akapity, szereguje nagłówki według rozmiaru czcionki, znajduje siatki tabel i za każdym razem zapisuje wszystko w tym samym schemacie, więc kod, który to czyta, nie musi zgadywać.
How to use it
Wczytaj pliki PDF
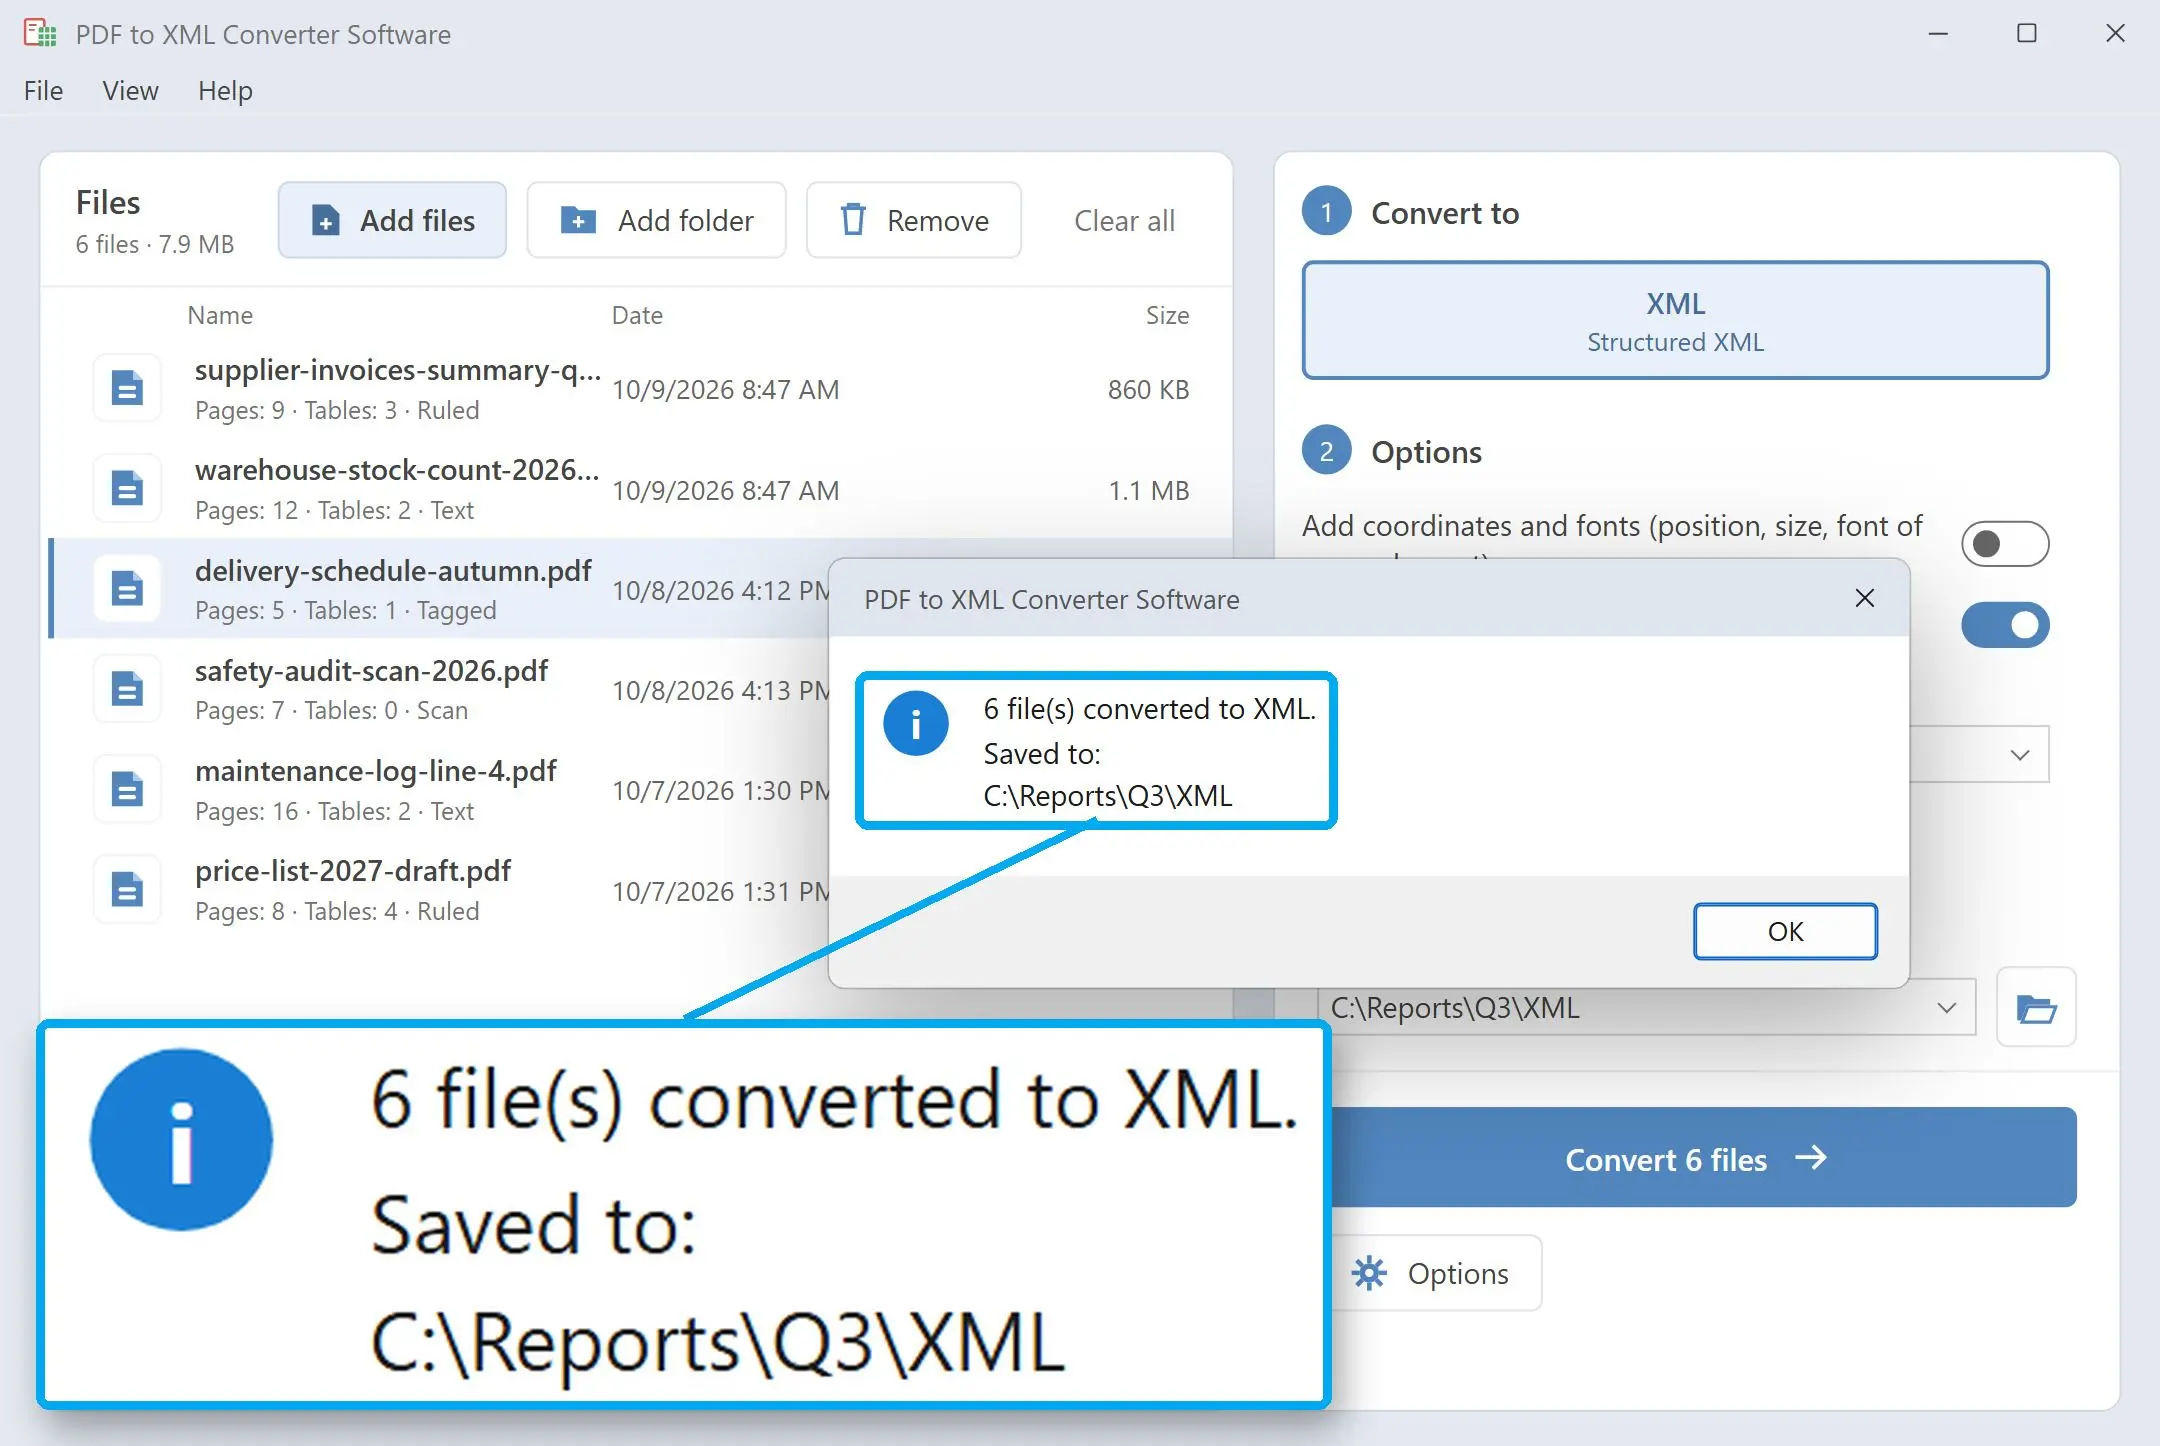
Dodaj pojedyncze pliki lub cały folder. Każdy PDF dostaje własny plik XML nazwany od źródła, a program pyta raz na wsad, zanim zastąpi starsze wyniki.
Wybierz wynik lekki lub szczegółowy
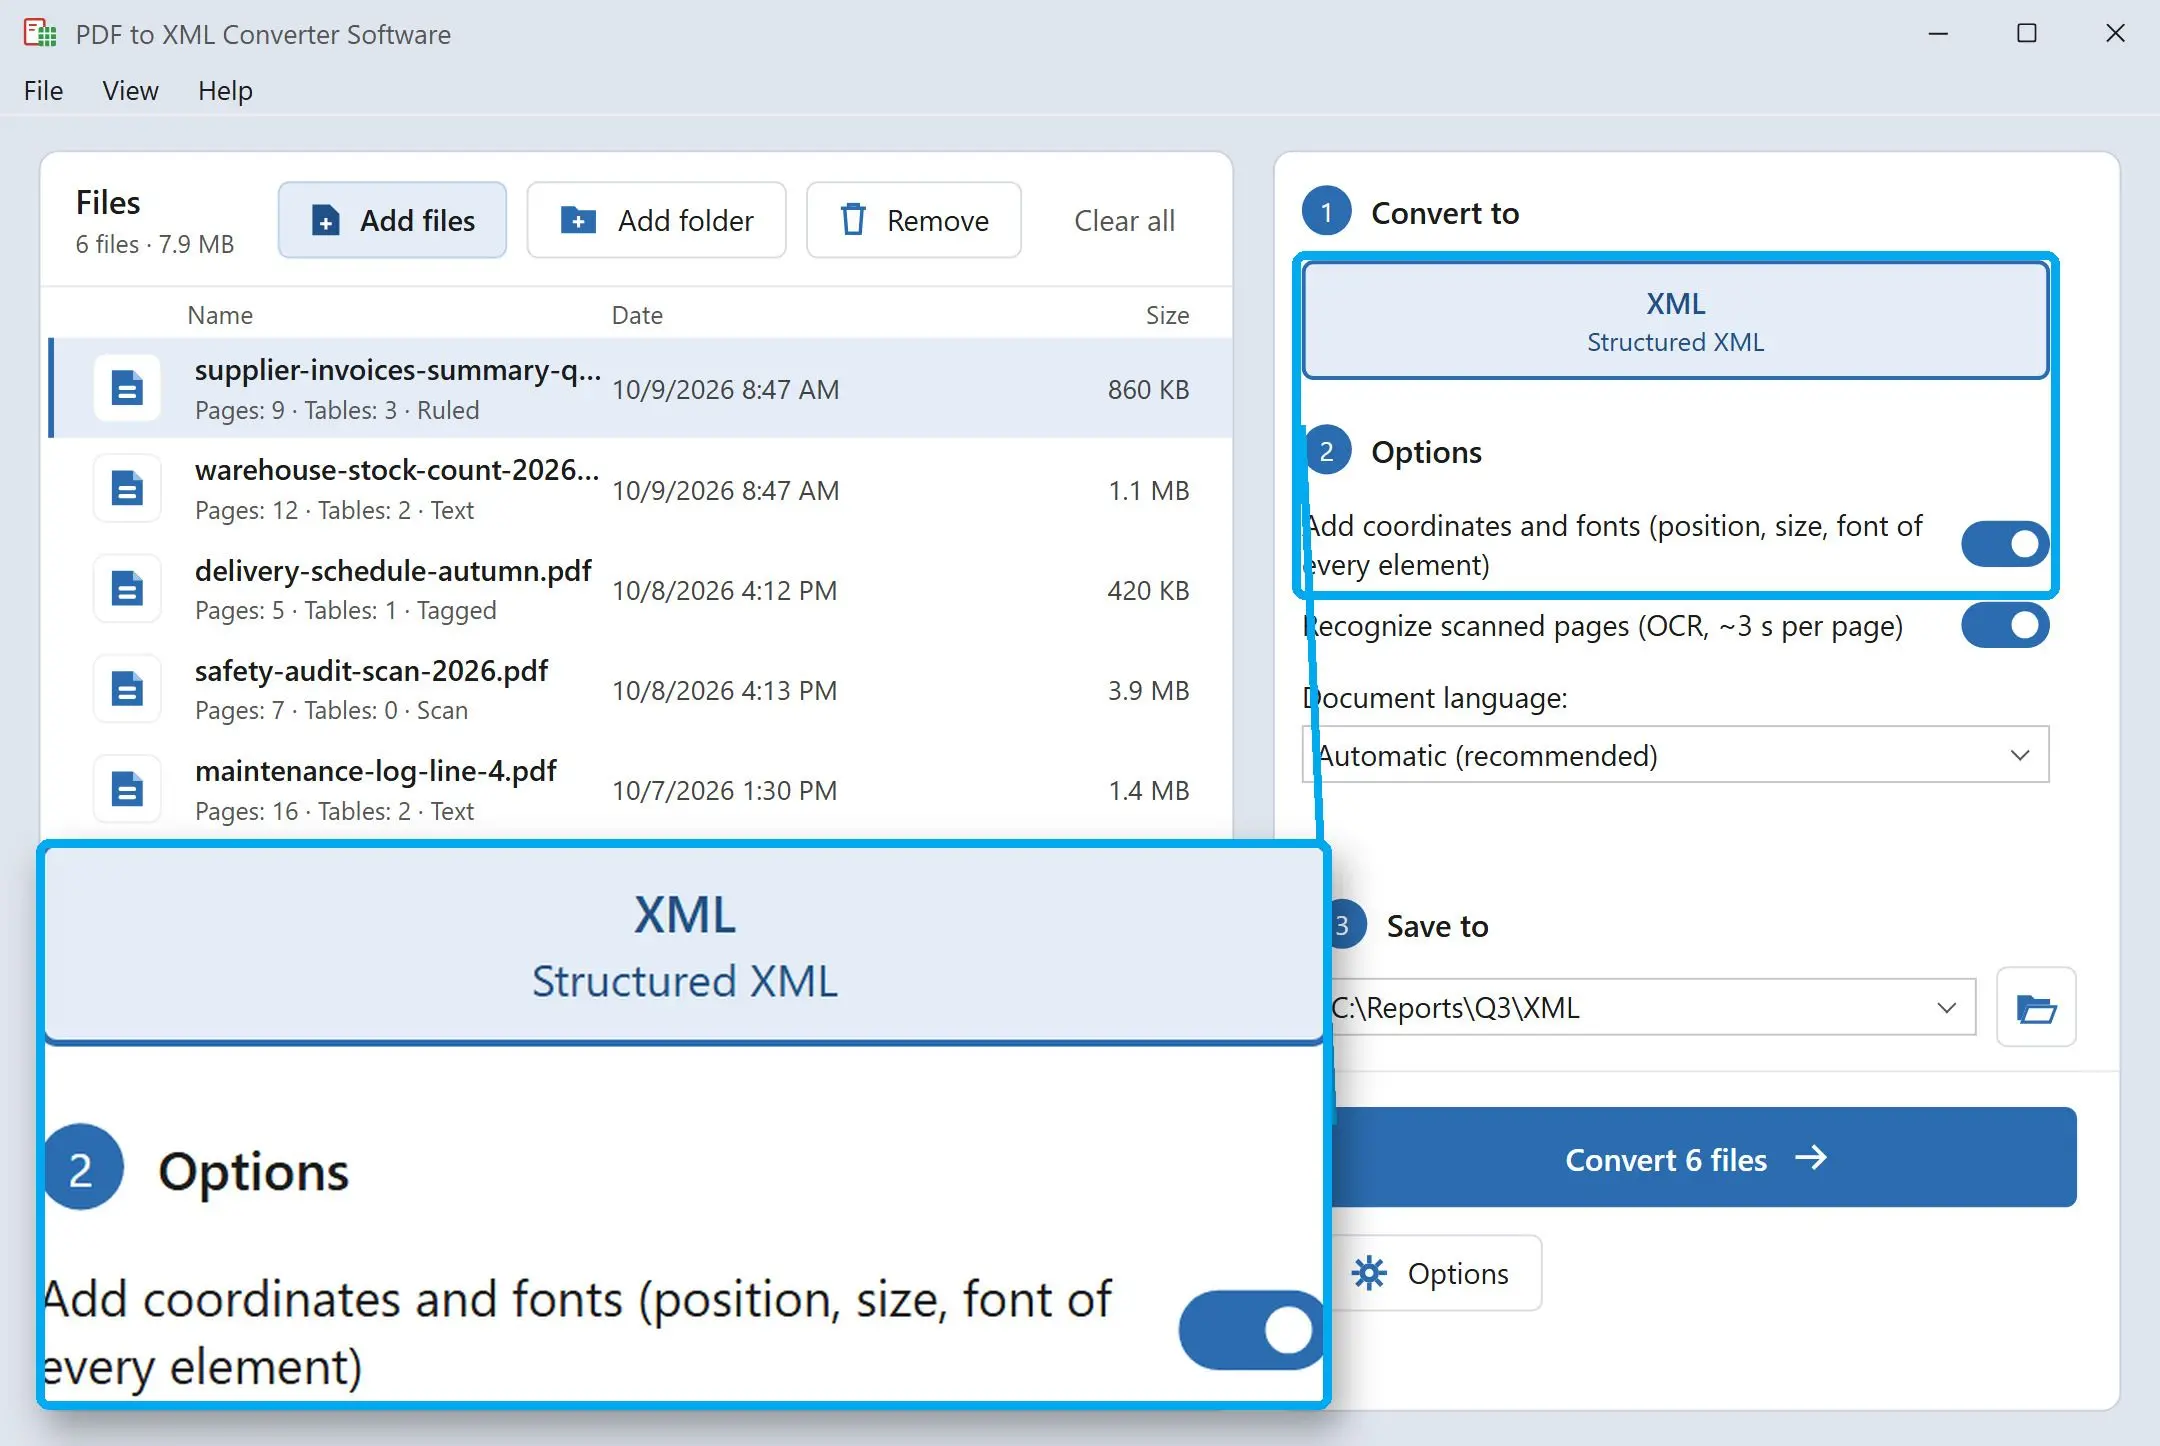
Zostaw współrzędne wyłączone, aby dostać zwarty plik tylko ze strukturą i tekstem. Włącz je, a każdy blok dostanie x, y, w i h w punktach, odwołanie do wpisu czcionki oraz zagnieżdżone elementy wiersza i tekstu - poziom szczegółowości, jakiego oczekujesz po pdftohtml -xml.
Przekaż pliki swojemu kodowi
Każdy plik jest poprawnym UTF-8 bez znacznika kolejności bajtów. Czytaj go przez ElementTree, lxml, XSLT lub moduł ładowania XML w swojej bazie danych; nazwy elementów nie zmieniają się między kolejnymi raportami.
Benefits
Tabele przychodzą jako siatka, a nie luźne ciągi
Każda tabela niesie liczbę wierszy i kolumn, wiersz nagłówka oznaczony header="1" oraz colspan lub rowspan w scalonych komórkach. Twój loader może wziąć nazwy kolumn z nagłówka i zamienić każdy pozostały wiersz w rekord. Tabela rozciągająca się na kilka stron jest zapisywana jako jedna tabela na stronę.
Jeden schemat dla każdego pliku
document, page, heading, paragraph, table, row, cell - te same nazwy i atrybuty w każdym wyniku, niezależnie od tego, czy PDF pochodzi z działu finansów, od dostawcy czy ze skanera. Gdy przyjdzie raport z następnego kwartału, import napisany dla tego odczyta i ten.
Działa na Twoim komputerze
Raporty, umowy i cenniki są czytane i zapisywane lokalnie, bez wgrywania i bez konta. Poufne dokumenty nie trafiają do usług firm trzecich, a zadanie działa nawet na maszynie bez dostępu do internetu.
Dlaczego ludzie go używają
Poziomy nagłówków, na których można polegać
Poziomy od 1 do 6 są ustalane na podstawie rozmiaru czcionki w porównaniu z tekstem podstawowym całego dokumentu, a nie strona po stronie. Tytuł rozdziału na stronie 40 dostaje ten sam poziom co tytuł na stronie 2, więc indeks wyszukiwania lub spis treści mogą mu zaufać.
Zeskanowane strony są oznaczane, nie ukrywane
Strona bez warstwy tekstowej jest oznaczana scanned="1". Gdy jej tekst pochodzi z rozpoznawania (pisma łacińskie i cyrylica), strona dostaje ocr="1" i wartość pewności, a wynik zawiera wyłącznie akapity - na rozpoznanych stronach tabele nie są wykrywane. Twój potok może kierować takie strony do ręcznej kontroli.
Proza nie jest brana za tabelę
Szerokie odstępy między wyrazami oszukują wiele wykrywaczy tabel i zamieniają dwukolumnowy artykuł w fałszywą siatkę. Takie kandydatury są odrzucane, a każda prawdziwa tabela zapisuje w atrybucie source, jak została znaleziona - ze znaczników PDF, z linii tabeli lub z wyrównania tekstu.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note