PDF to Structured XML Exporter
Le contenu des PDF en XML qu'un programme sait lire
Convertissez des fichiers PDF en XML structuré par lots, hors ligne : pages, titres, paragraphes et tableaux en lignes et cellules. Coordonnées et polices en option pour chaque bloc. Essai gratuit.
Full seller details: Legal information.
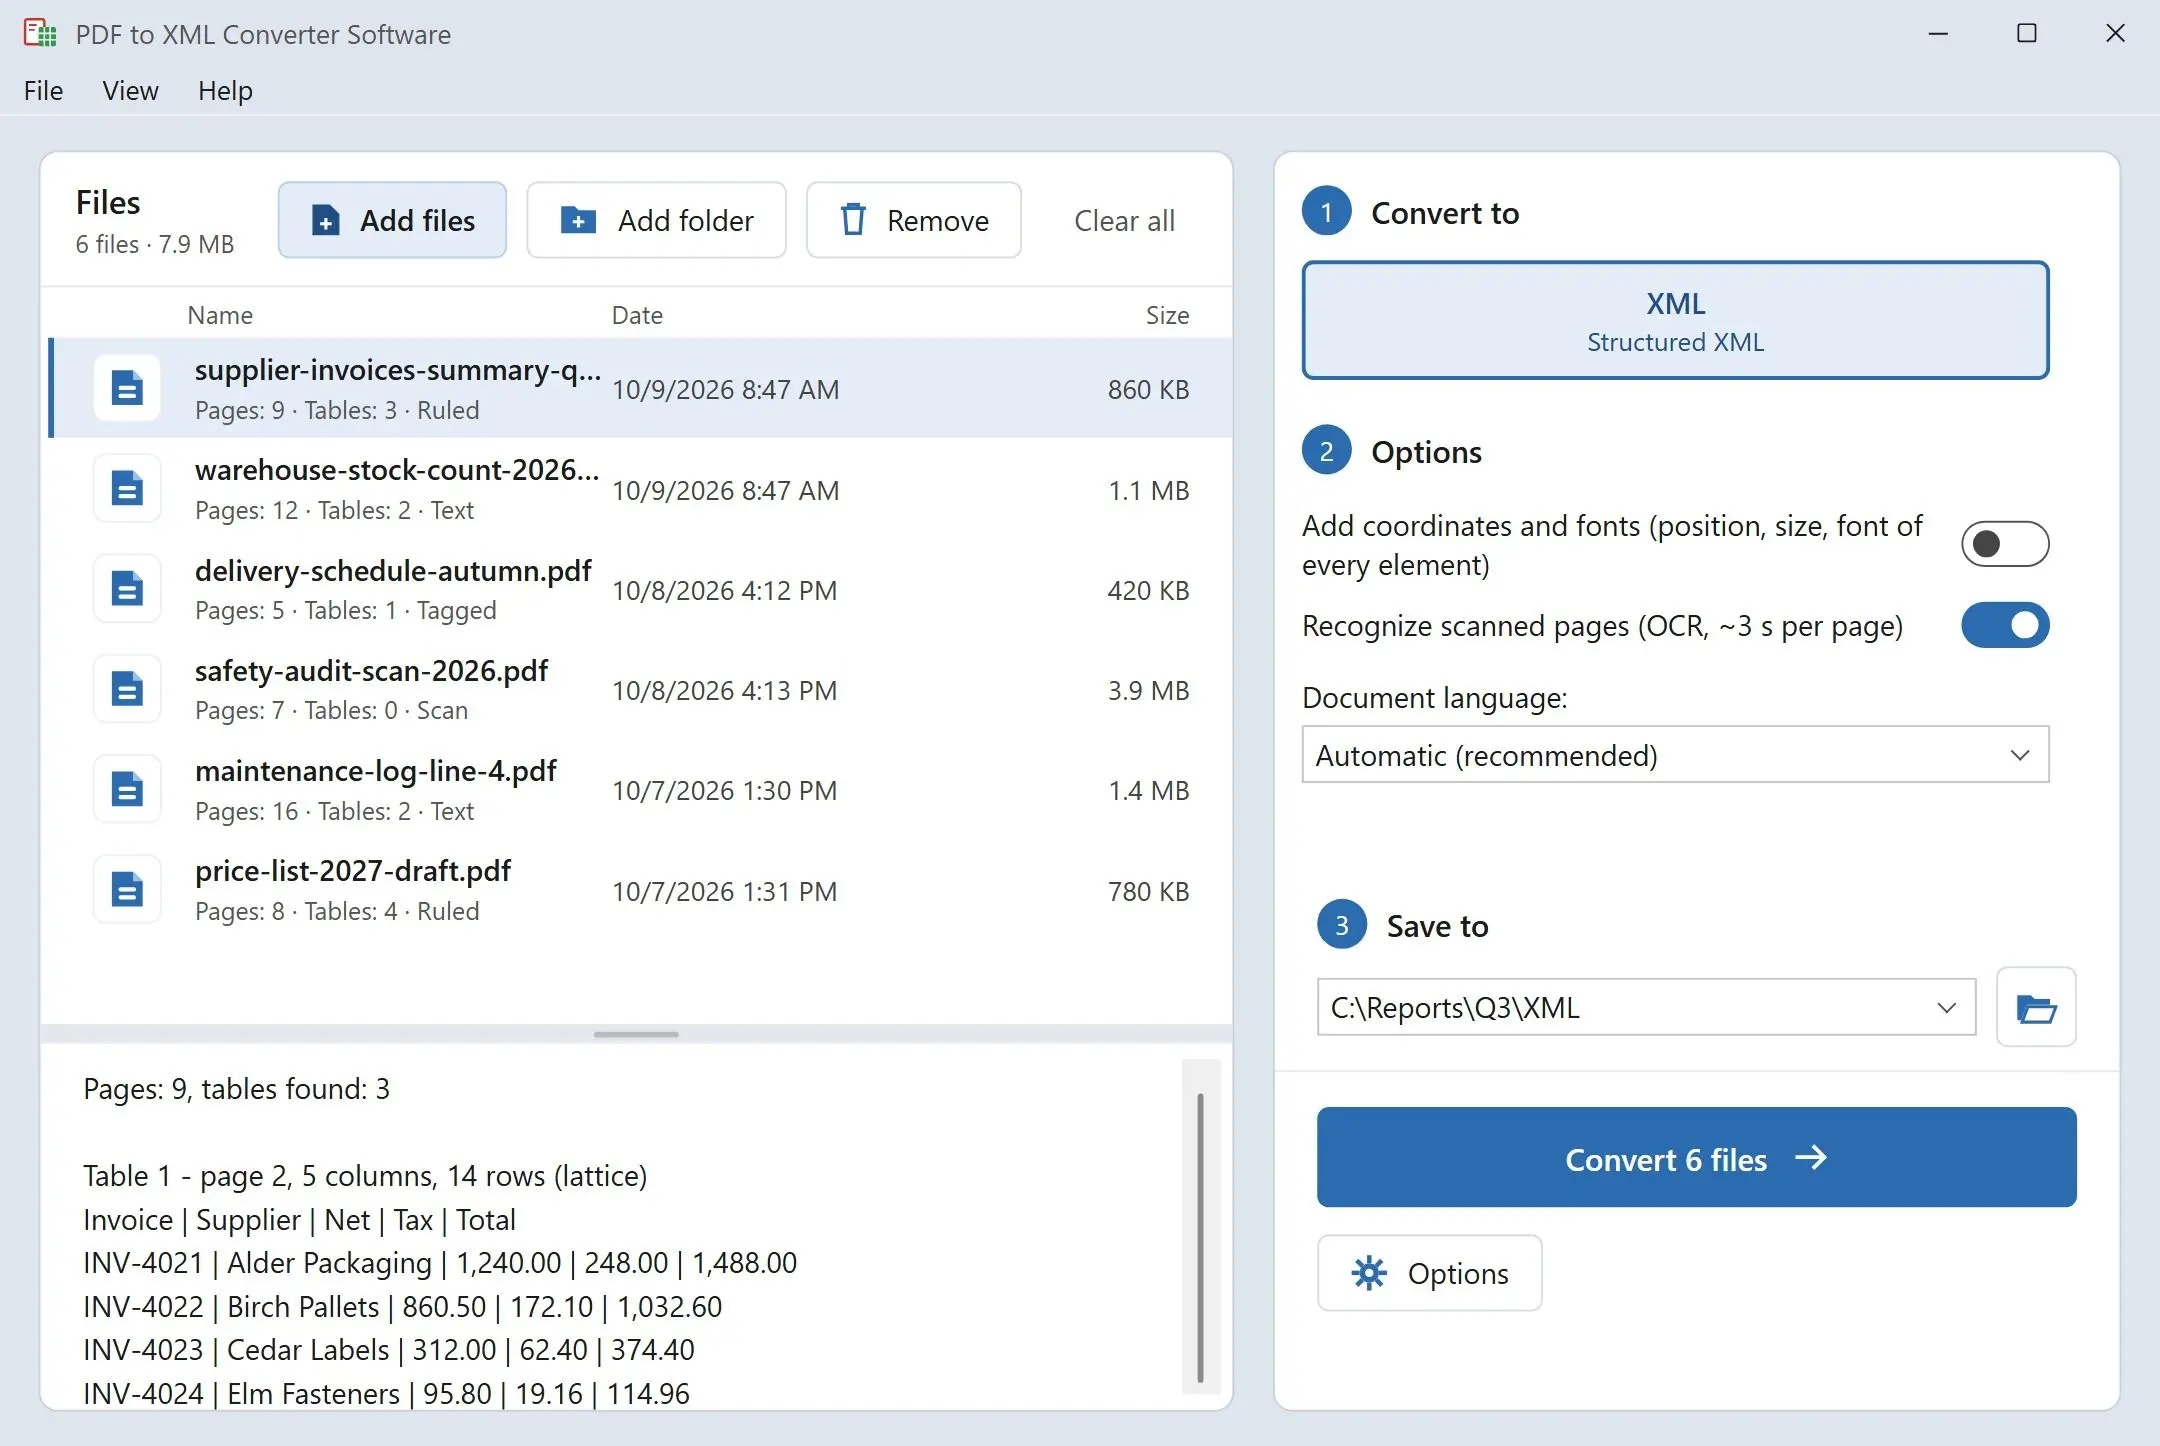
Donnez-lui un dossier de rapports et obtenez un fichier XML par PDF : un élément page pour chaque page, des titres avec leur niveau, des paragraphes, et des tableaux découpés en lignes et cellules. Il s'exécute sur votre PC Windows, rien n'est donc téléversé.
Un PDF sait où va l'encre, pas ce qu'elle signifie
Dans un PDF, il n'y a ni paragraphe, ni titre, ni tableau - seulement des morceaux de texte placés à des coordonnées sur une page. C'est très bien pour imprimer et inutile pour un script d'import. L'export XML des éditeurs PDF décrit surtout cette mise en page, et les sites de téléversement disent rarement comment leur sortie est construite. Ce programme reconstruit la structure à la place : il regroupe les lignes en paragraphes, hiérarchise les titres selon la taille de police, repère les grilles de tableaux et écrit le tout dans le même schéma à chaque fois, de sorte que le code qui le lit n'a pas à deviner.
How to use it
Charger les PDF
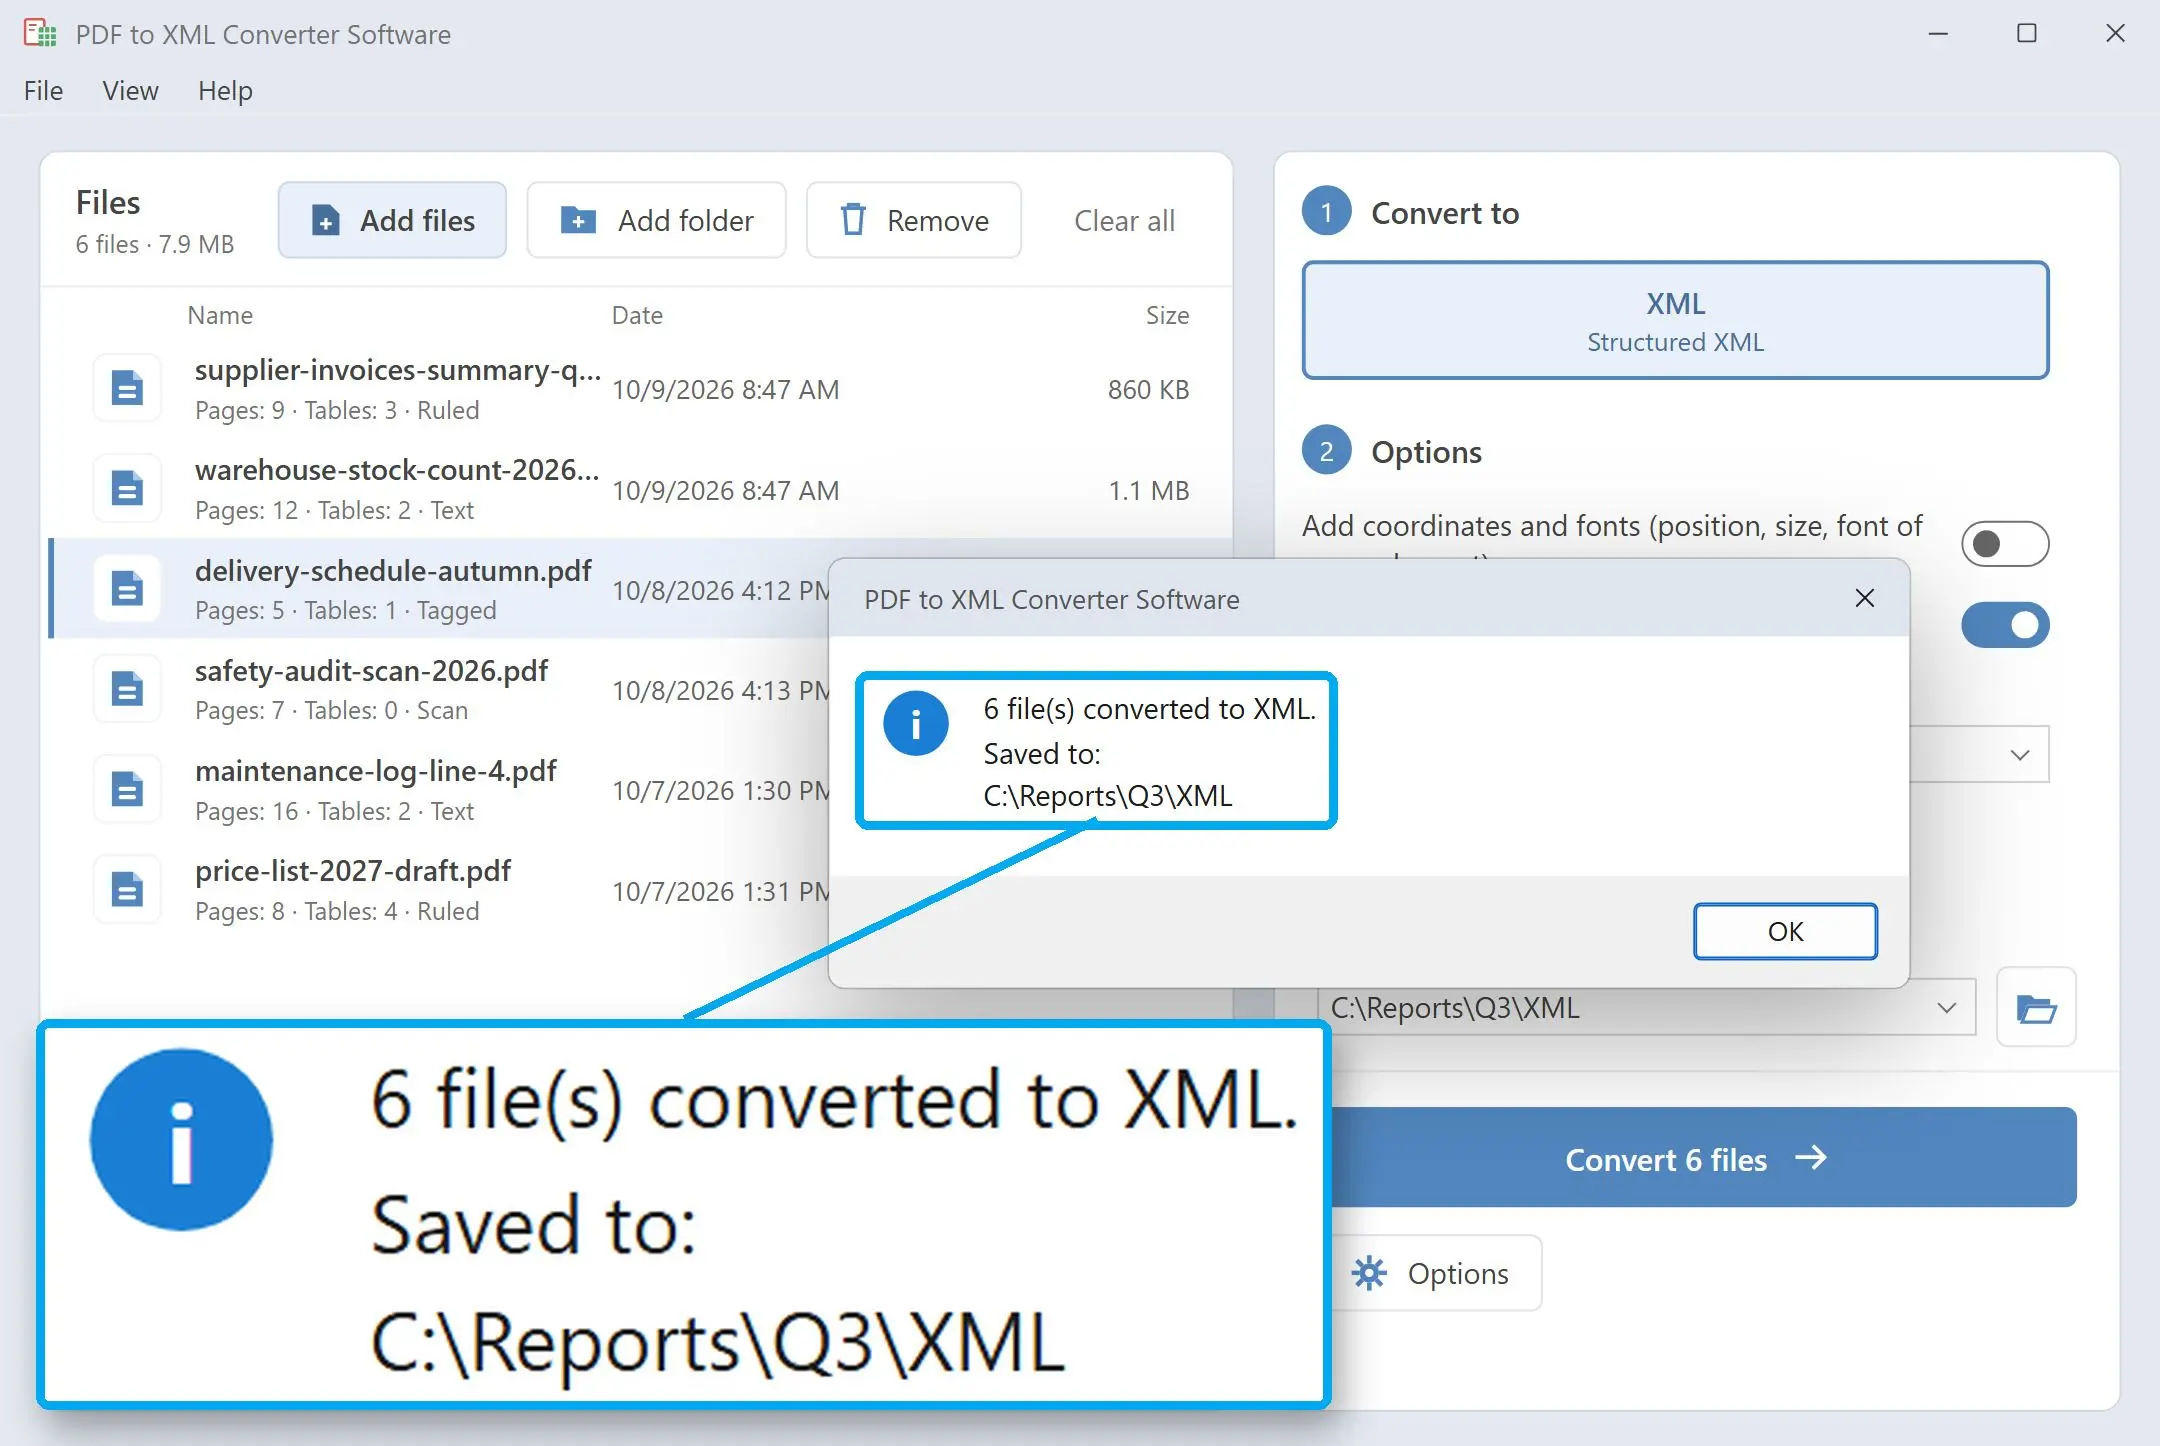
Ajoutez des fichiers isolés ou un dossier entier. Chaque PDF obtient son propre fichier XML nommé d'après la source, et le programme demande une fois par lot avant de remplacer d'anciennes sorties.
Choisir une sortie légère ou détaillée
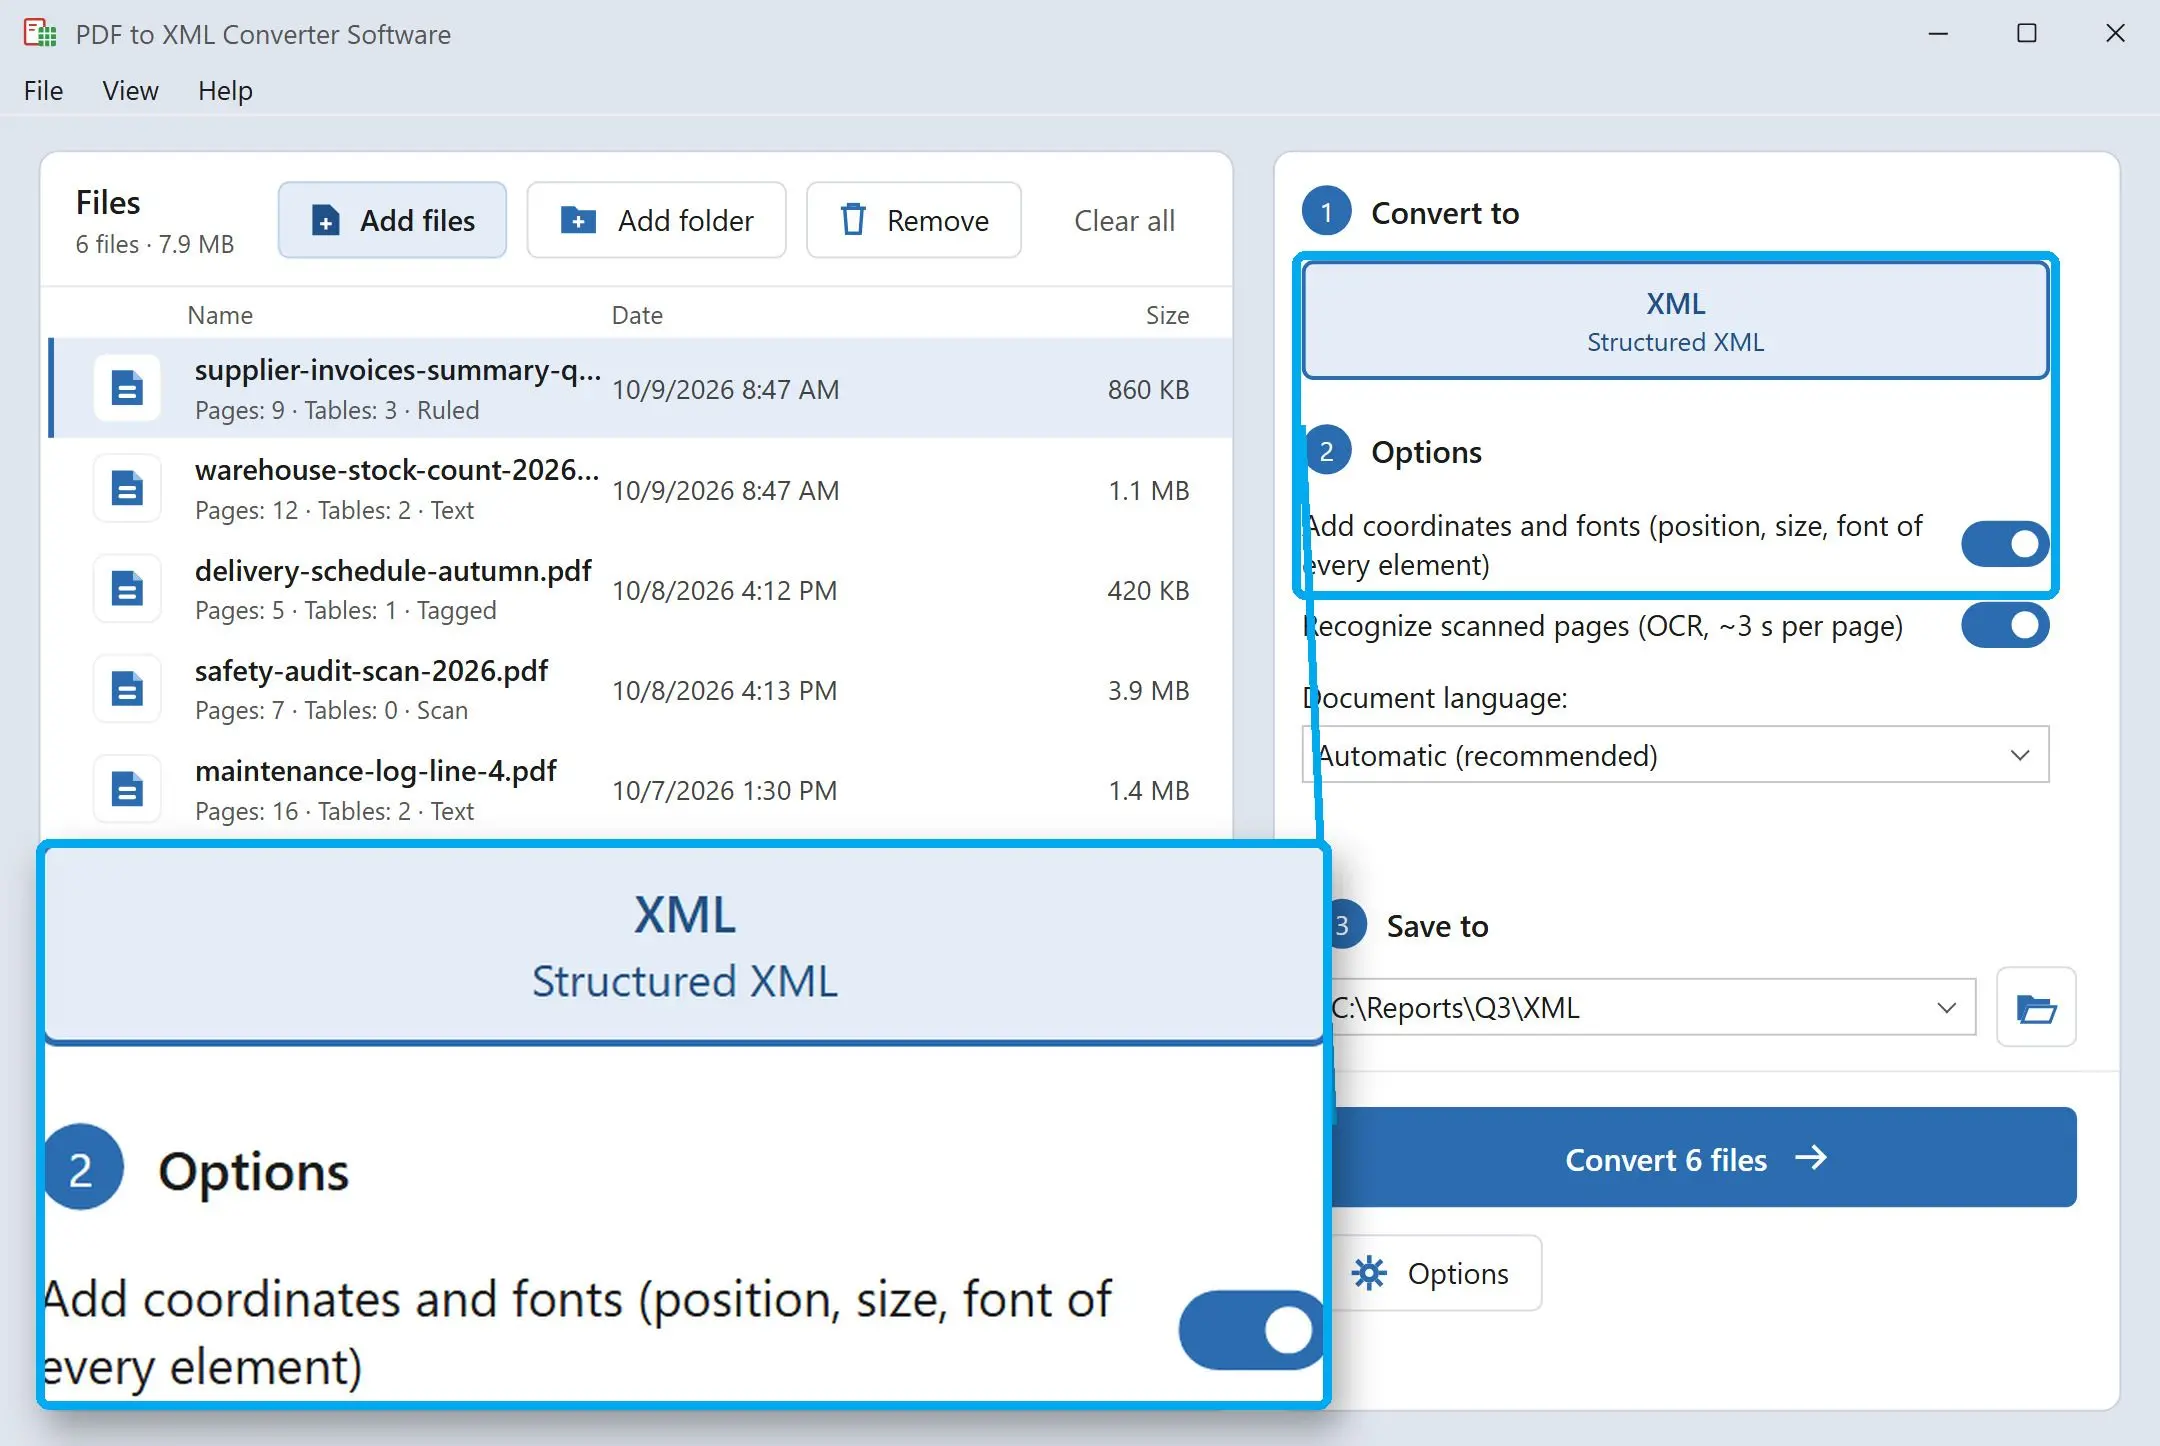
Laissez les coordonnées désactivées pour un fichier compact avec seulement la structure et le texte. Activez-les et chaque bloc reçoit x, y, w et h en points, une référence à une entrée de police, et des éléments ligne et texte imbriqués - le niveau de détail que l'on attend de pdftohtml -xml.
Confier les fichiers à votre code
Chaque fichier est du UTF-8 bien formé sans marque d'ordre des octets. Lisez-le avec ElementTree, lxml, XSLT ou le chargeur XML de votre base de données ; les noms d'éléments ne changent pas d'un rapport à l'autre.
Benefits
Les tableaux arrivent en grille, pas en chaînes éparses
Chaque tableau porte son nombre de lignes et de colonnes, une ligne d'en-tête marquée header="1", et colspan ou rowspan sur les cellules fusionnées. Votre chargeur peut prendre les noms de colonnes dans l'en-tête et transformer chaque autre ligne en enregistrement. Un tableau qui s'étend sur plusieurs pages est écrit comme un tableau par page.
Un seul schéma pour chaque fichier
document, page, heading, paragraph, table, row, cell - les mêmes noms et attributs dans chaque sortie, que le PDF vienne de la comptabilité, d'un fournisseur ou d'un scanner. Quand le rapport du trimestre suivant arrive, l'import que vous avez écrit pour celui-ci le lit aussi.
S'exécute sur votre propre PC
Rapports, contrats et tarifs sont lus et écrits en local, sans téléversement ni compte. Les documents confidentiels restent hors des services tiers, et la tâche tourne même sur une machine sans aucun accès à Internet.
Pourquoi les gens l'utilisent
Des niveaux de titre fiables
Les niveaux 1 à 6 sont fixés d'après la taille de police comparée au corps de texte de l'ensemble du document, et non page par page. Un titre de chapitre à la page 40 reçoit le même niveau que celui de la page 2, un index de recherche ou une table des matières peut donc s'y fier.
Les pages numérisées sont signalées, pas cachées
Une page sans couche de texte est marquée scanned="1". Quand son texte provient de la reconnaissance (écritures latine et cyrillique), la page porte ocr="1" et une valeur de confiance, et vous n'obtenez que des paragraphes - les tableaux ne sont pas détectés sur les pages reconnues. Votre chaîne de traitement peut aiguiller ces pages vers une vérification manuelle.
La prose n'est pas prise pour un tableau
De larges espaces entre les mots trompent de nombreux détecteurs de tableaux, qui transforment un article sur deux colonnes en fausse grille. De tels candidats sont rejetés, et chaque vrai tableau consigne dans son attribut source comment il a été trouvé - d'après les balises PDF, les filets ou l'alignement du texte.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note