PDF to Structured XML Exporter
Содержимое PDF в виде XML, который читает программа
Преобразуйте файлы PDF в структурированный XML пакетом, офлайн: страницы, заголовки, абзацы и таблицы со строками и ячейками. По желанию координаты и шрифты для каждого блока. Бесплатная пробная версия.
Full seller details: Legal information.
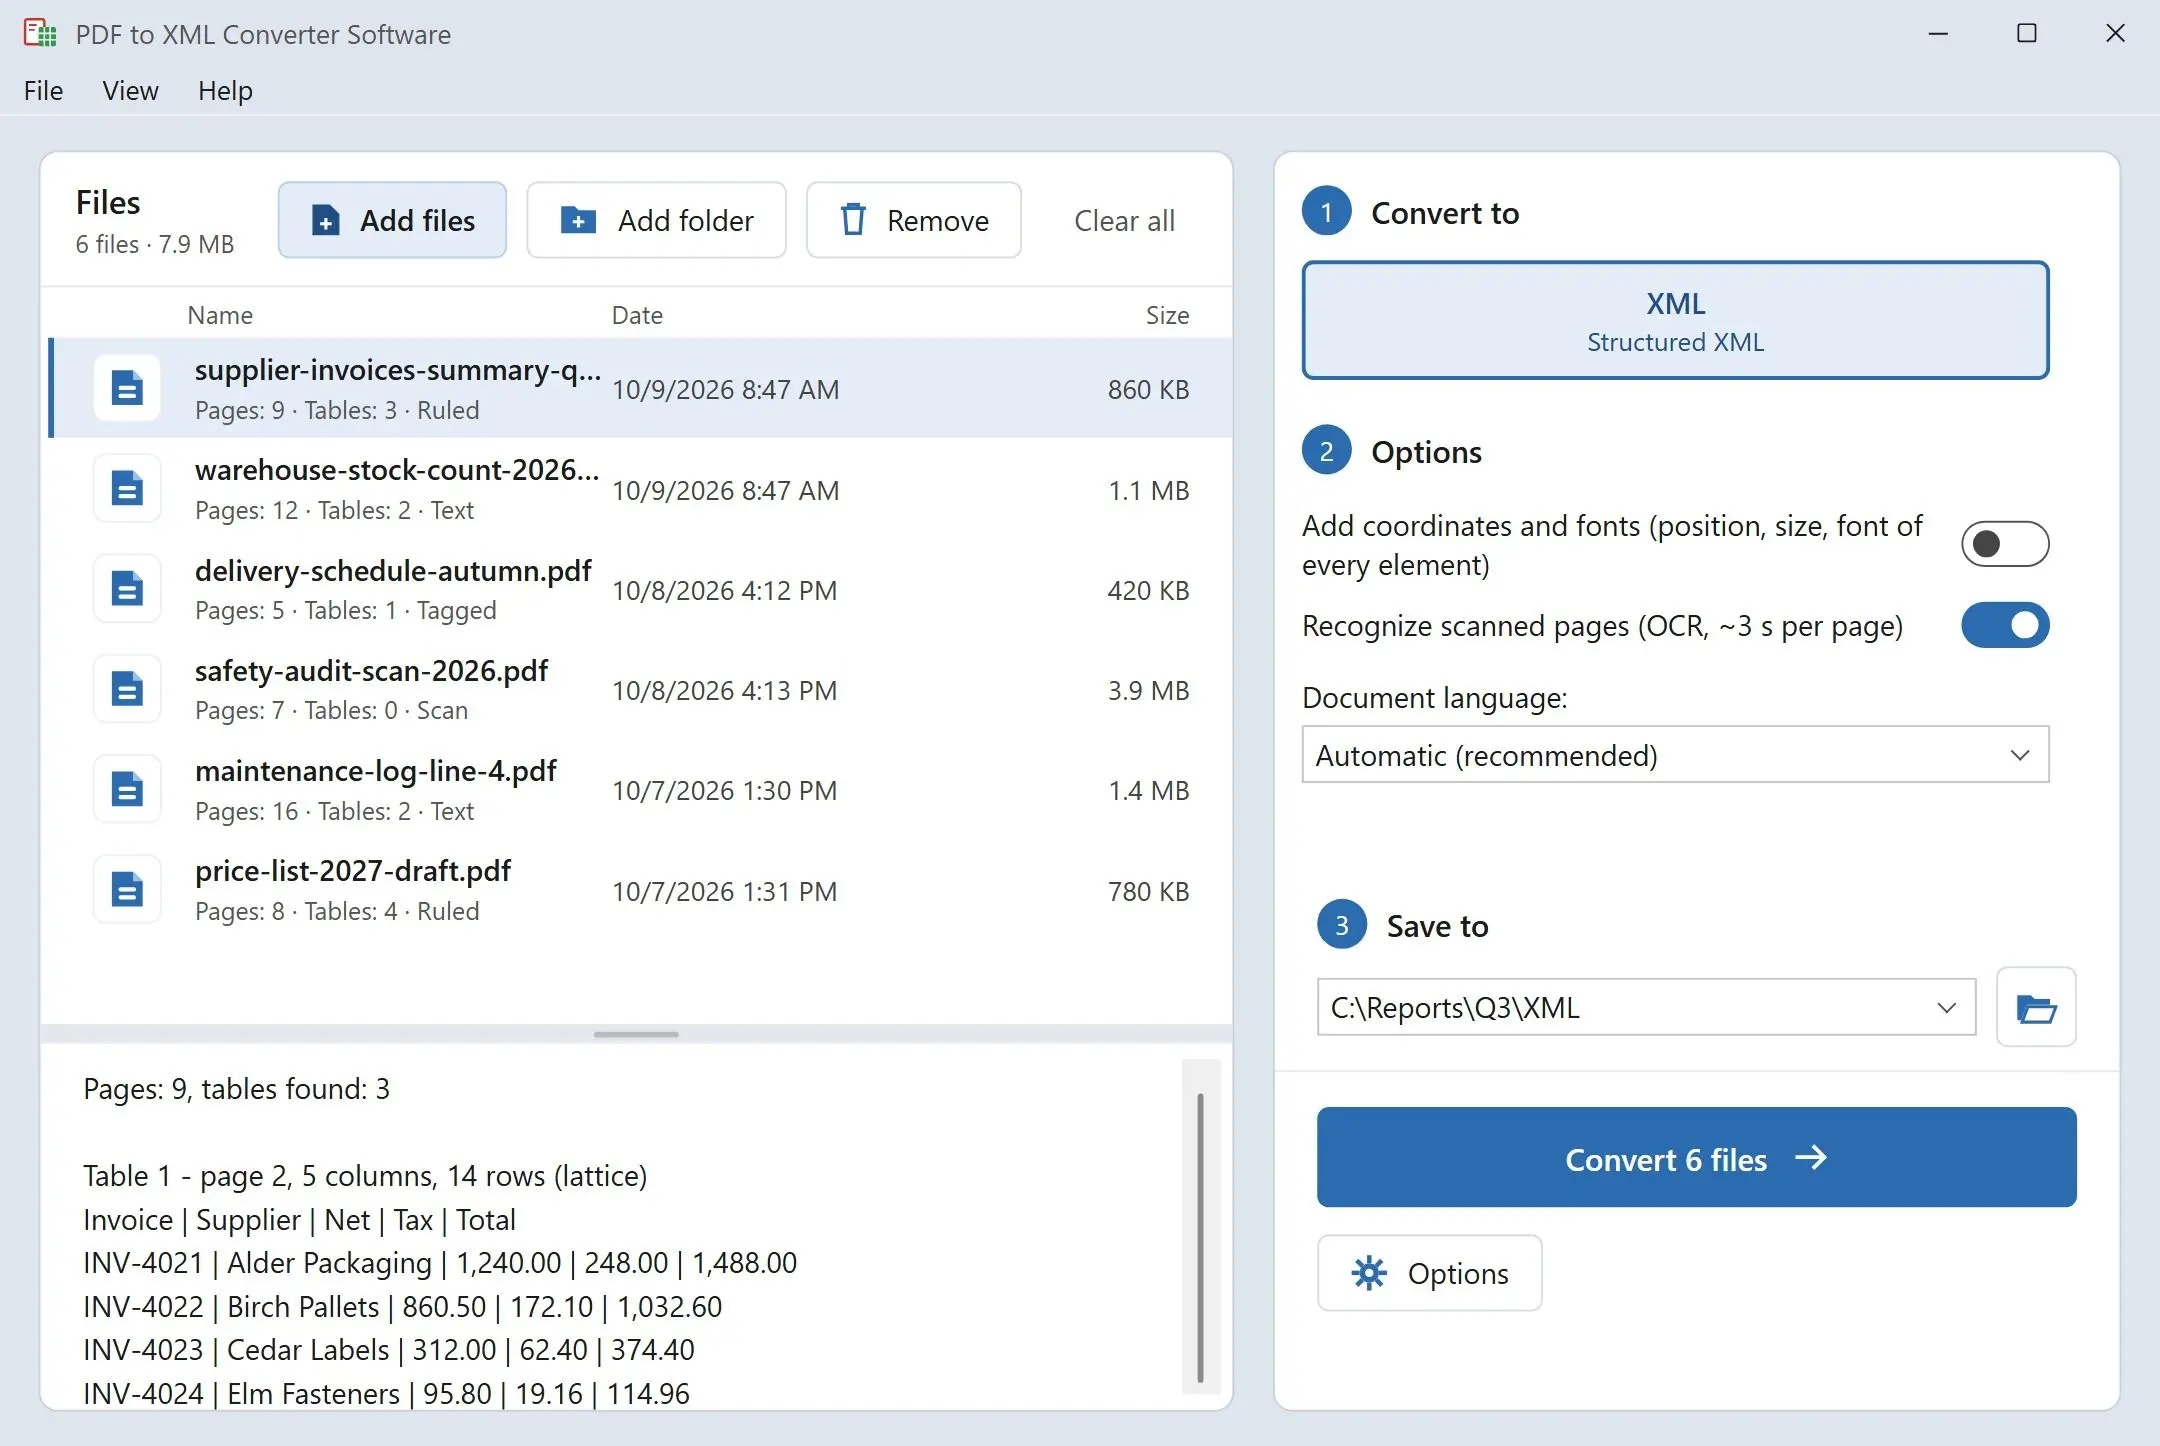
Передайте папку с отчётами и получите по одному файлу XML на каждый PDF: элемент page для каждой страницы, заголовки с их уровнем, абзацы и таблицы, разобранные на строки и ячейки. Программа работает на вашем компьютере с Windows, поэтому ничего не загружается.
PDF знает, где лежит чернила, но не знает, что это значит
Внутри PDF нет ни абзаца, ни заголовка, ни таблицы - только фрагменты текста, расставленные по координатам на странице. Для печати этого достаточно, а для скрипта импорта бесполезно. Экспорт в XML в редакторах PDF в основном описывает именно эту раскладку, а сайты для загрузки редко говорят, как строится их результат. Эта программа вместо этого восстанавливает структуру: группирует строки в абзацы, ранжирует заголовки по размеру шрифта, находит сетки таблиц и каждый раз записывает всё по одной и той же схеме, так что коду, который это читает, не приходится гадать.
How to use it
Загрузите PDF
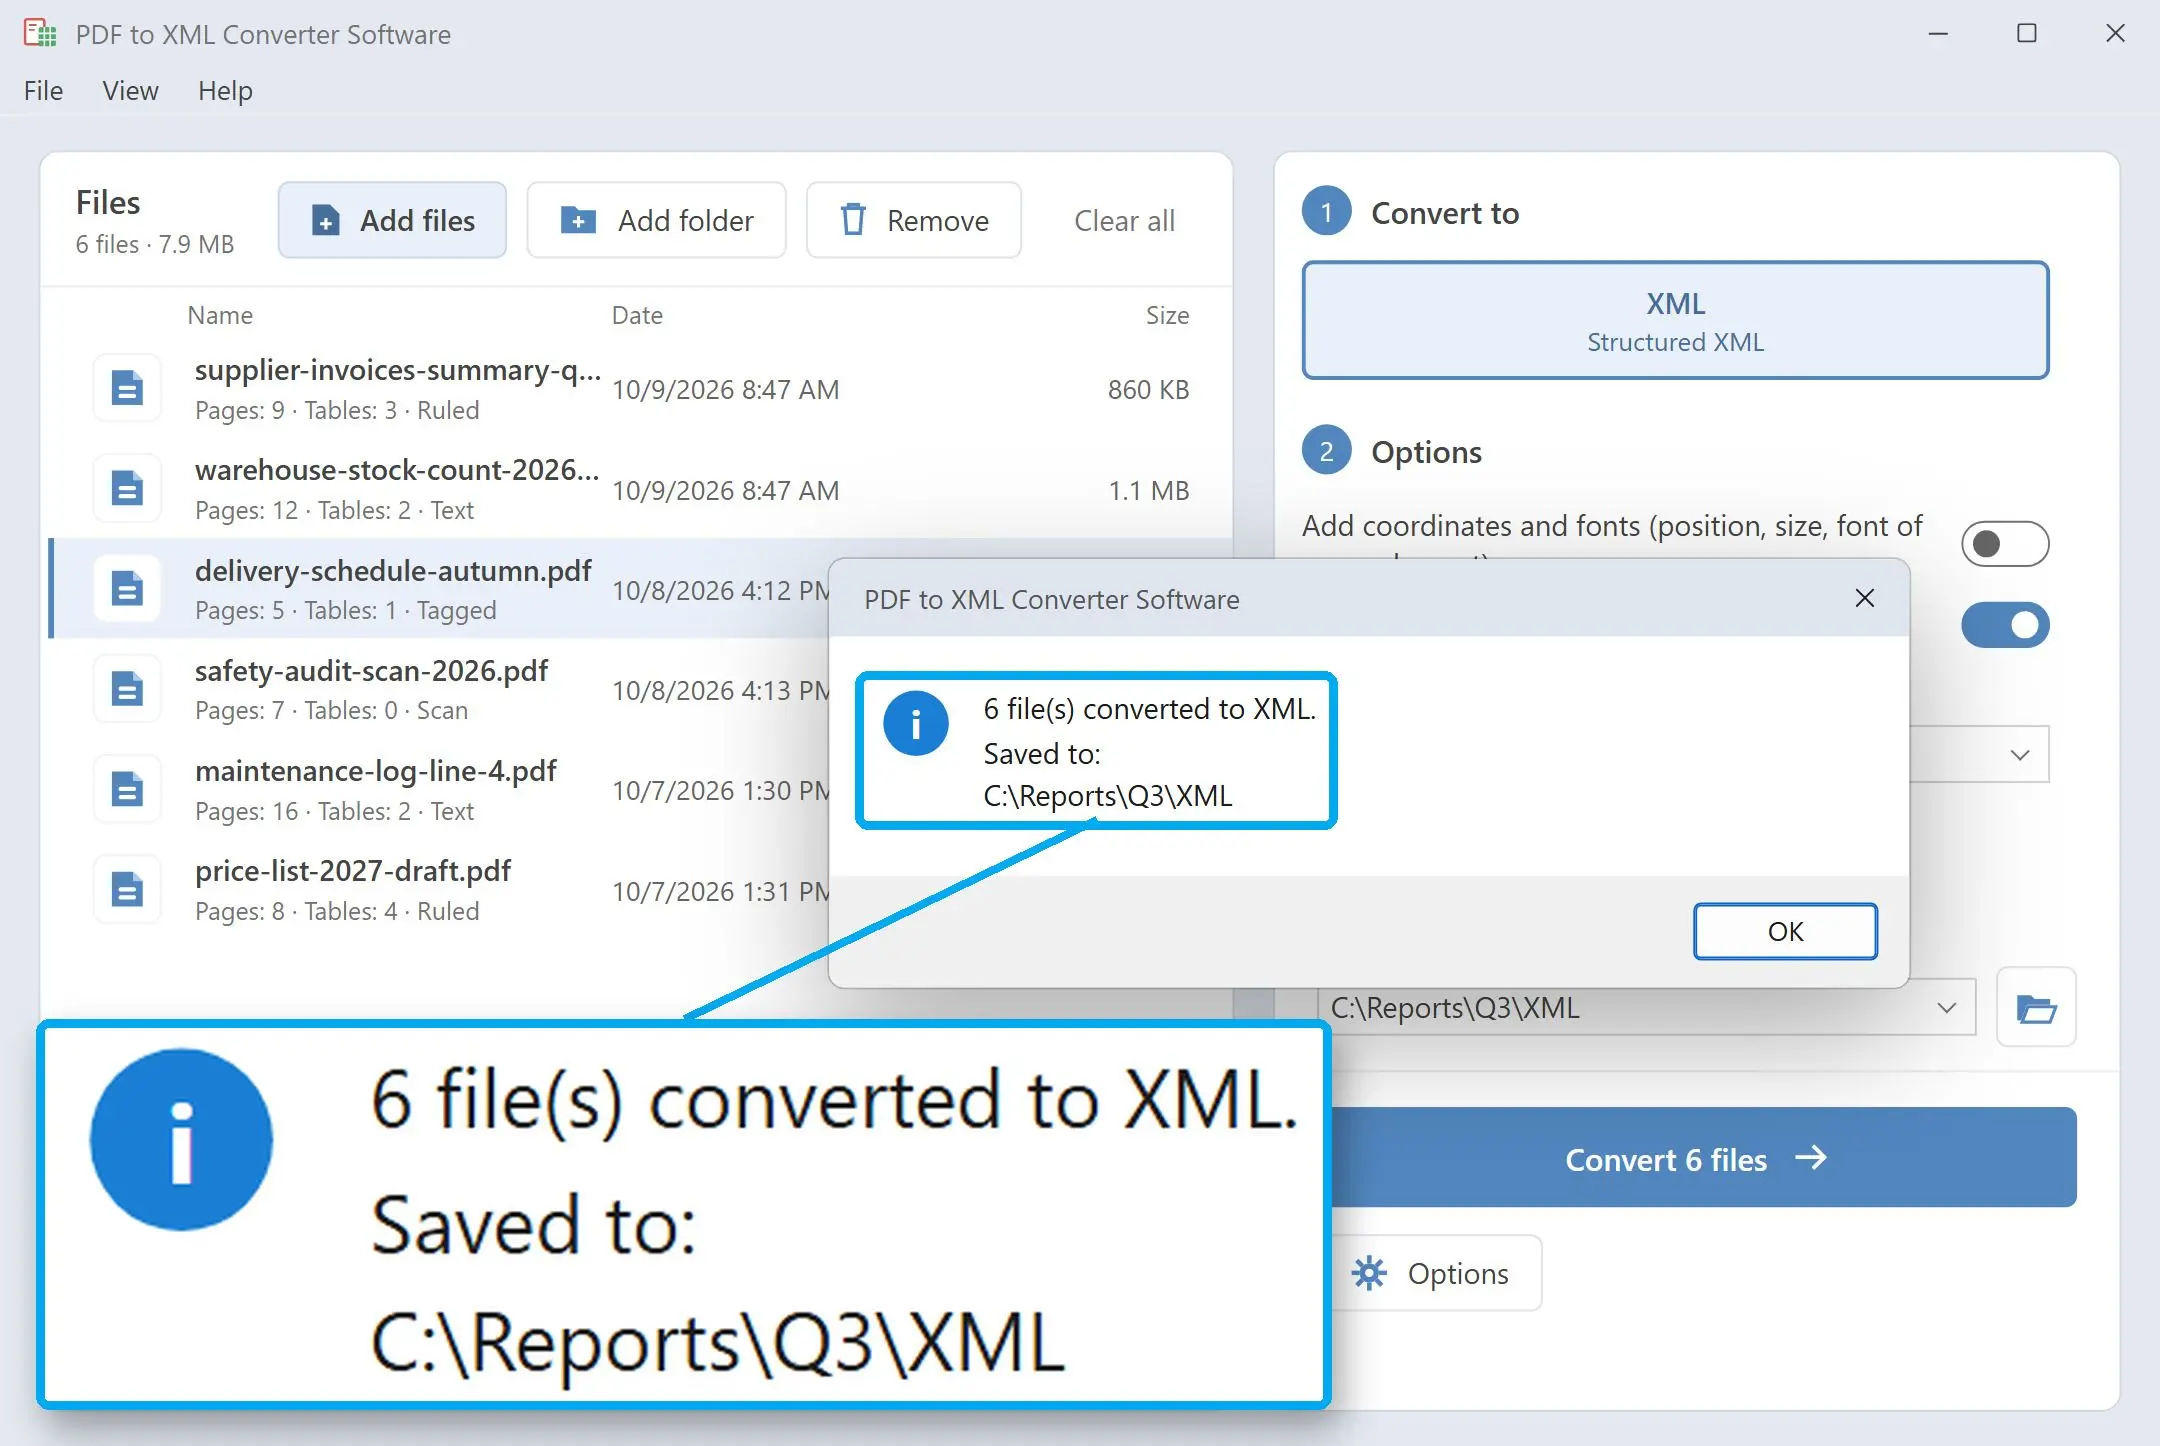
Добавьте отдельные файлы или целую папку. Каждый PDF получает свой файл XML с именем исходного, а перед заменой старых результатов программа спрашивает один раз на пакет.
Выберите лёгкий или подробный вывод
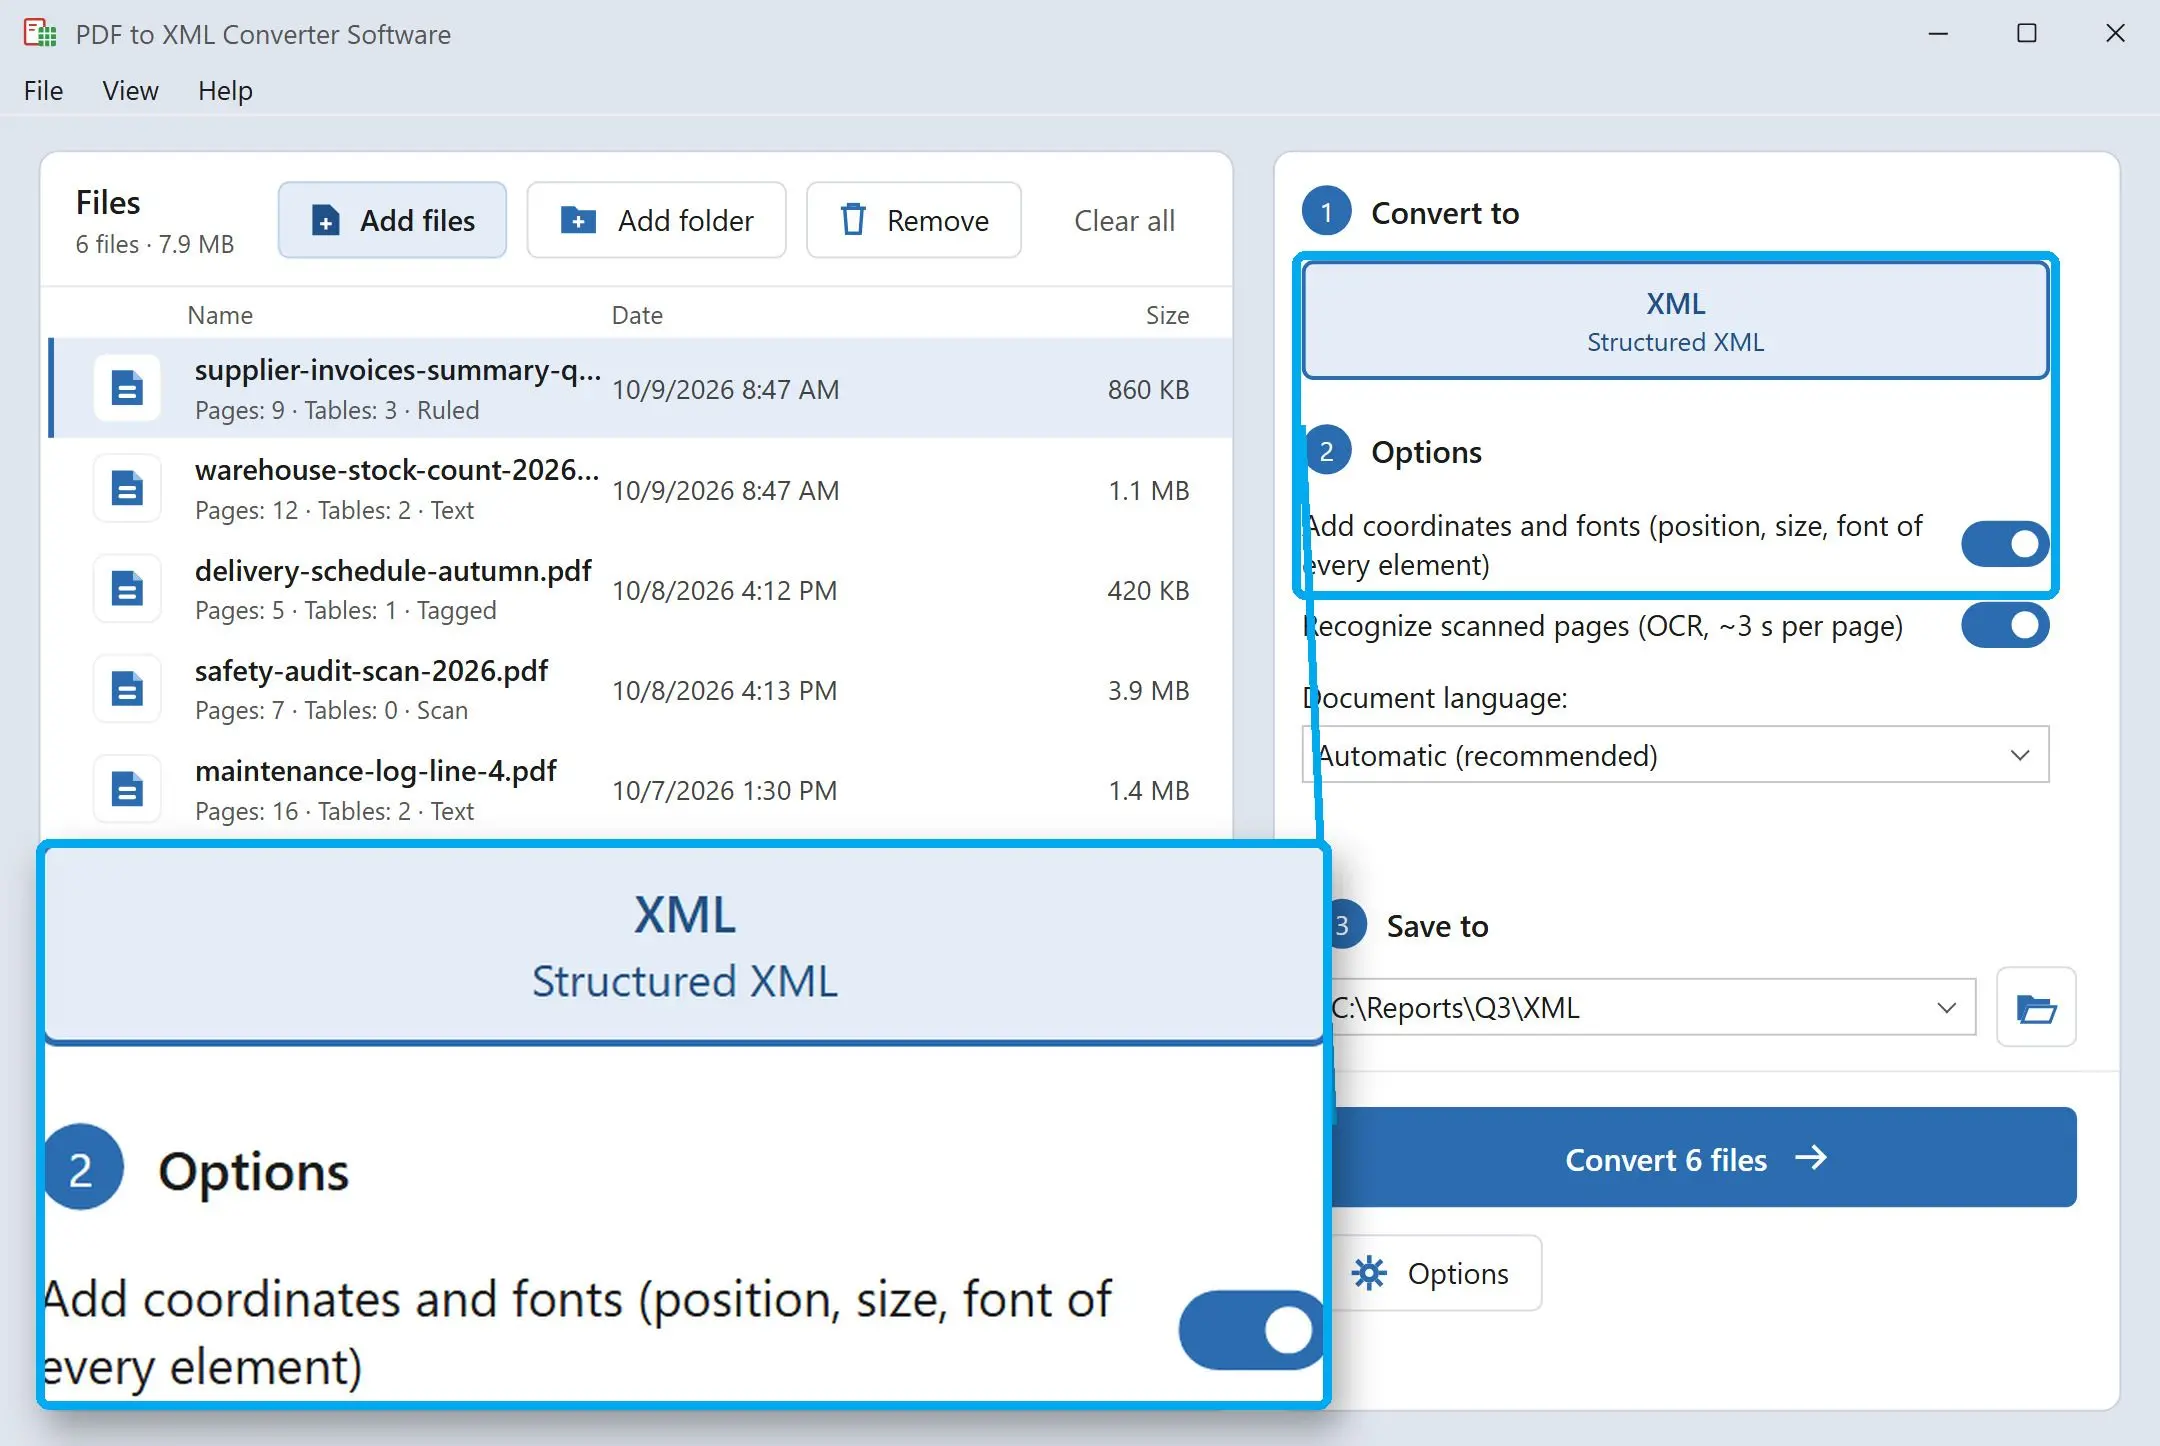
Оставьте координаты выключенными, чтобы получить компактный файл только со структурой и текстом. Включите их, и каждый блок получит x, y, w и h в пунктах, ссылку на запись шрифта и вложенные элементы строк и текста - уровень детализации, как у pdftohtml -xml.
Передайте файлы своему коду
Каждый файл - корректный UTF-8 без метки порядка байтов. Читайте его через ElementTree, lxml, XSLT или загрузчик XML вашей базы данных; имена элементов не меняются от отчёта к отчёту.
Benefits
Таблицы приходят сеткой, а не россыпью строк
Каждая таблица несёт число строк и столбцов, строку заголовка с пометкой header="1" и colspan или rowspan для объединённых ячеек. Ваш загрузчик может взять имена столбцов из заголовка и превратить каждую остальную строку в запись. Таблица, идущая через несколько страниц, записывается как одна таблица на страницу.
Одна схема для каждого файла
document, page, heading, paragraph, table, row, cell - одни и те же имена и атрибуты в каждом результате, пришёл ли PDF из бухгалтерии, от поставщика или со сканера. Когда придёт отчёт за следующий квартал, импорт, написанный для этого, прочитает и его.
Работает на вашем компьютере
Отчёты, договоры и прайс-листы читаются и записываются локально, без загрузки и без учётной записи. Конфиденциальные документы остаются вне сторонних сервисов, а задача выполняется даже на компьютере без доступа в интернет.
Почему люди это используют
Уровни заголовков, на которые можно положиться
Уровни от 1 до 6 назначаются по размеру шрифта относительно основного текста всего документа, а не страница за страницей. Название главы на странице 40 получает тот же уровень, что и на странице 2, так что поисковый индекс или оглавление могут ему доверять.
Сканированные страницы помечаются, а не прячутся
Страница без текстового слоя помечается scanned="1". Если её текст получен распознаванием (латиница и кириллица), у страницы есть ocr="1" и значение достоверности, а вы получаете только абзацы - таблицы на распознанных страницах не определяются. Ваш конвейер может направлять такие страницы на ручную проверку.
Прозу не принимают за таблицу
Широкие промежутки между словами сбивают многие средства поиска таблиц, и двухколонная статья превращается в ложную сетку. Такие кандидаты отвергаются, а каждая настоящая таблица записывает в атрибуте source, как она найдена: по тегам PDF, по линиям или по выравниванию текста.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note