PDF to Structured XML Exporter
PDF-indhold som XML, et program kan læse
Konverter PDF-filer til struktureret XML i bulk, offline: sider, overskrifter, afsnit og tabeller som rækker og celler. Valgfrie koordinater og skrifttyper for hver blok. Gratis prøveperiode.
Full seller details: Legal information.
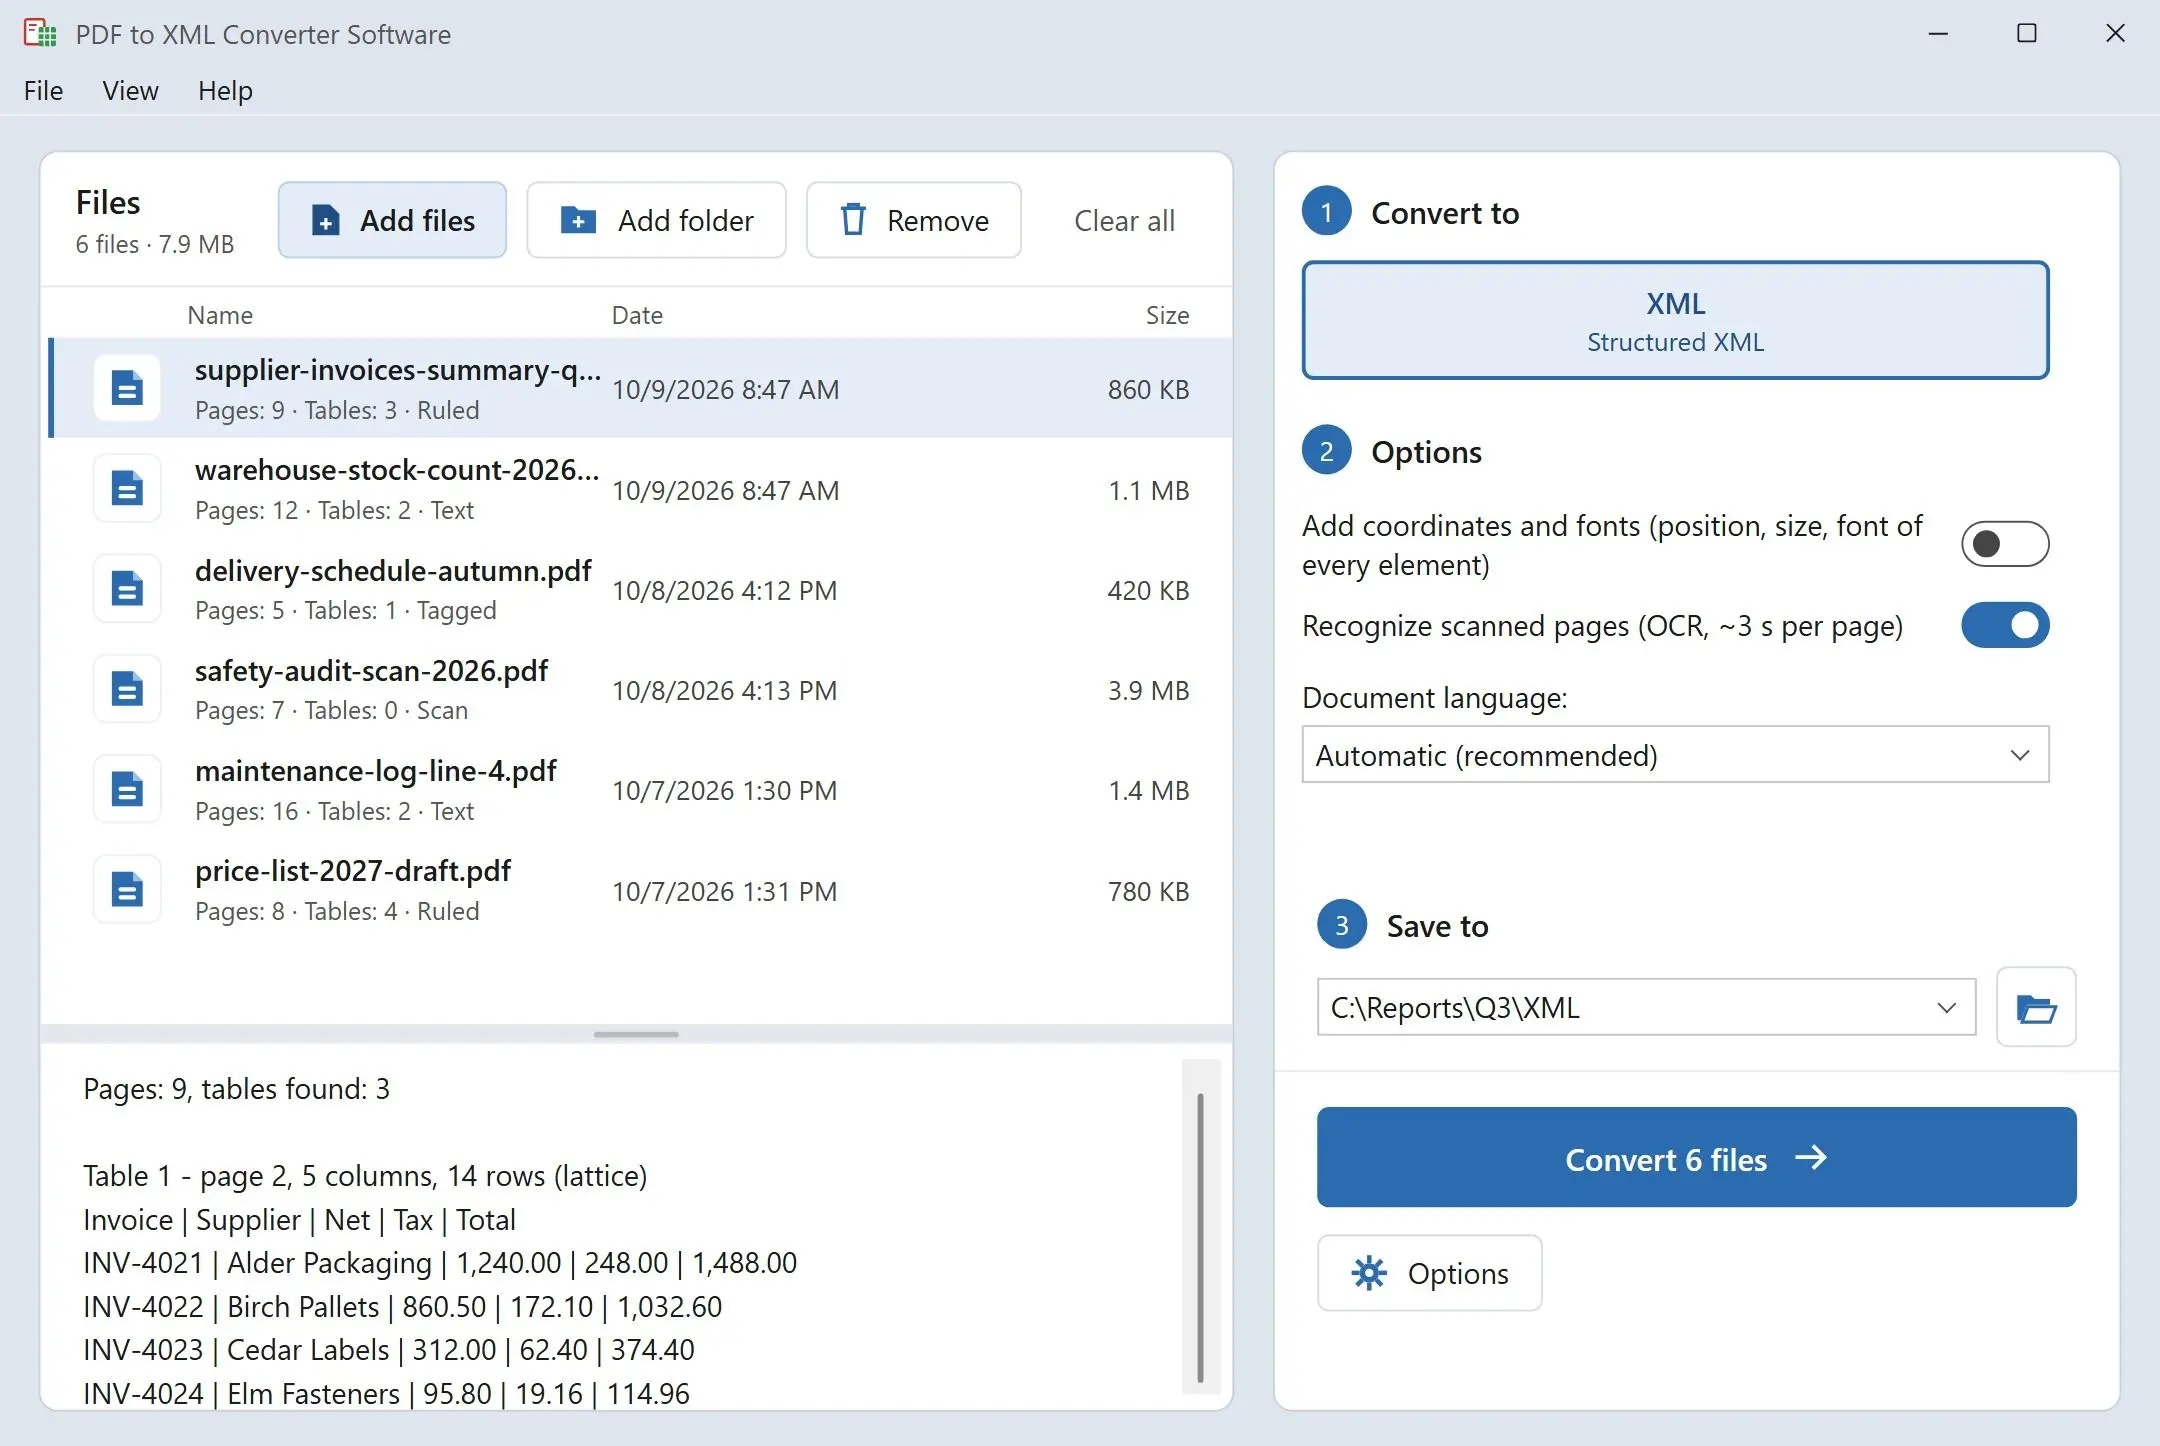
Giv den en mappe med rapporter og få én XML-fil pr. PDF: et sideelement for hver side, overskrifter med deres niveau, afsnit og tabeller opdelt i rækker og celler. Det kører på din Windows-pc, så intet uploades.
En PDF ved, hvor blækket skal hen, ikke hvad det betyder
Inde i en PDF findes der intet afsnit, ingen overskrift og ingen tabel - kun stykker af tekst placeret ved koordinater på en side. Det er fint til udskrivning og ubrugeligt til et importscript. XML-eksporten i PDF-editorer beskriver mest det layout, og uploadsider fortæller sjældent, hvordan deres output er bygget op. Dette program genopbygger i stedet strukturen: det grupperer linjer til afsnit, rangerer overskrifter efter skriftstørrelse, finder tabelgitre og skriver det hele efter det samme skema hver gang, så den kode, der læser det, ikke behøver at gætte.
How to use it
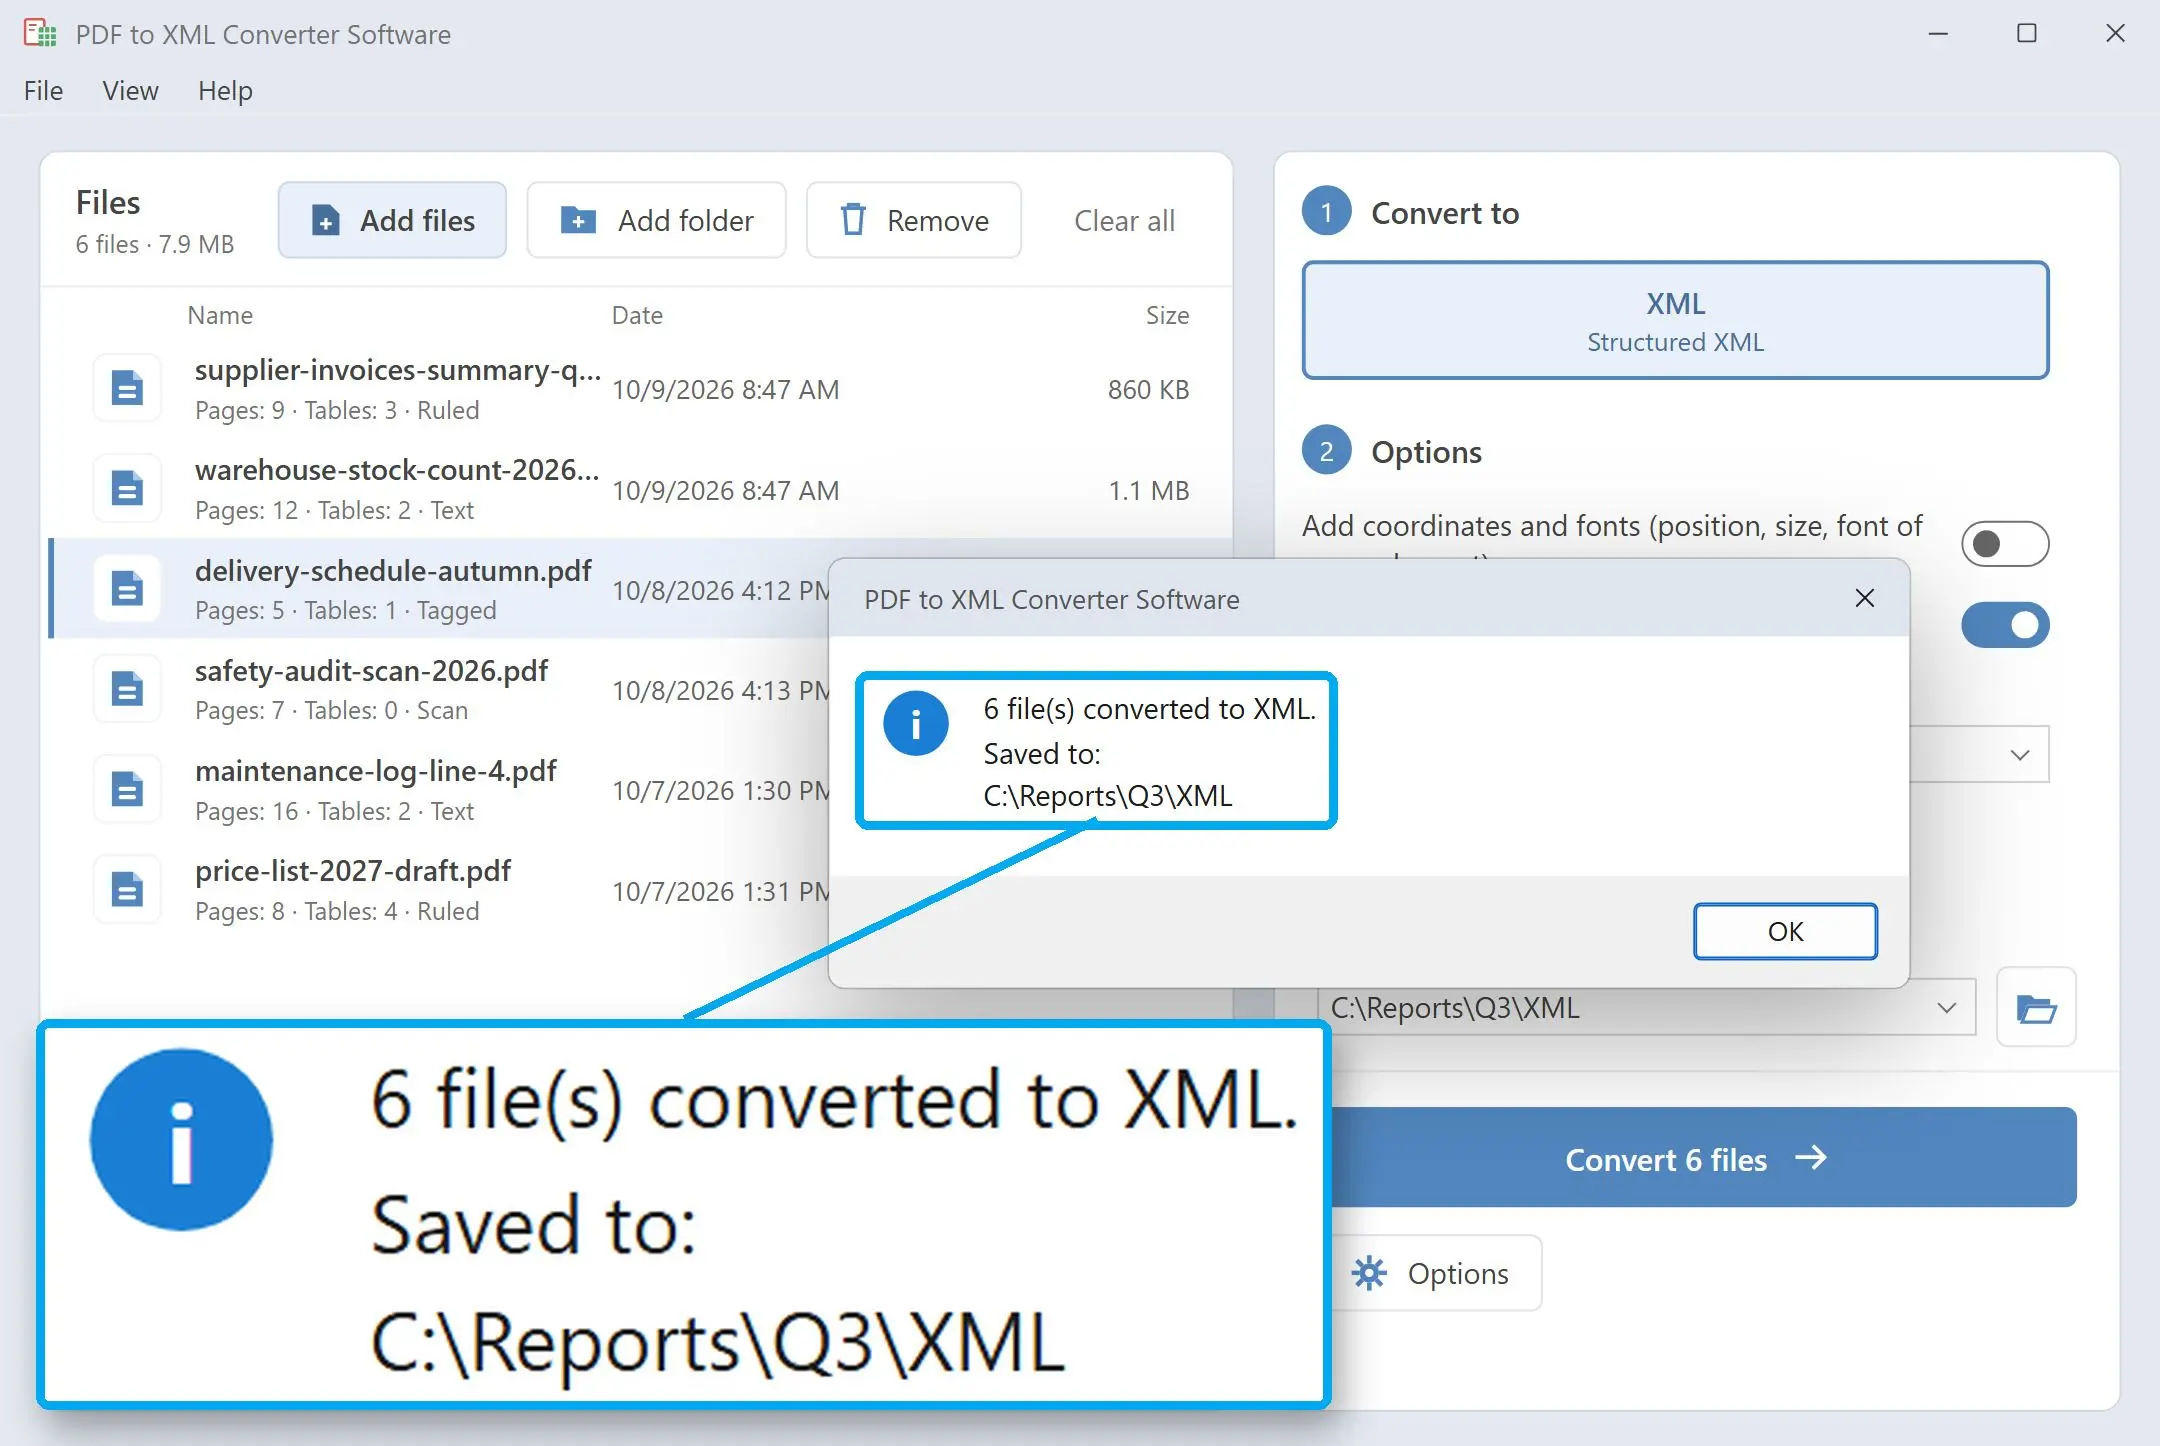
Indlæs PDF-filerne
Tilføj enkelte filer eller en hel mappe. Hver PDF får sin egen XML-fil opkaldt efter kilden, og programmet spørger én gang pr. bulkkørsel, før det erstatter ældre output.
Vælg let eller detaljeret output
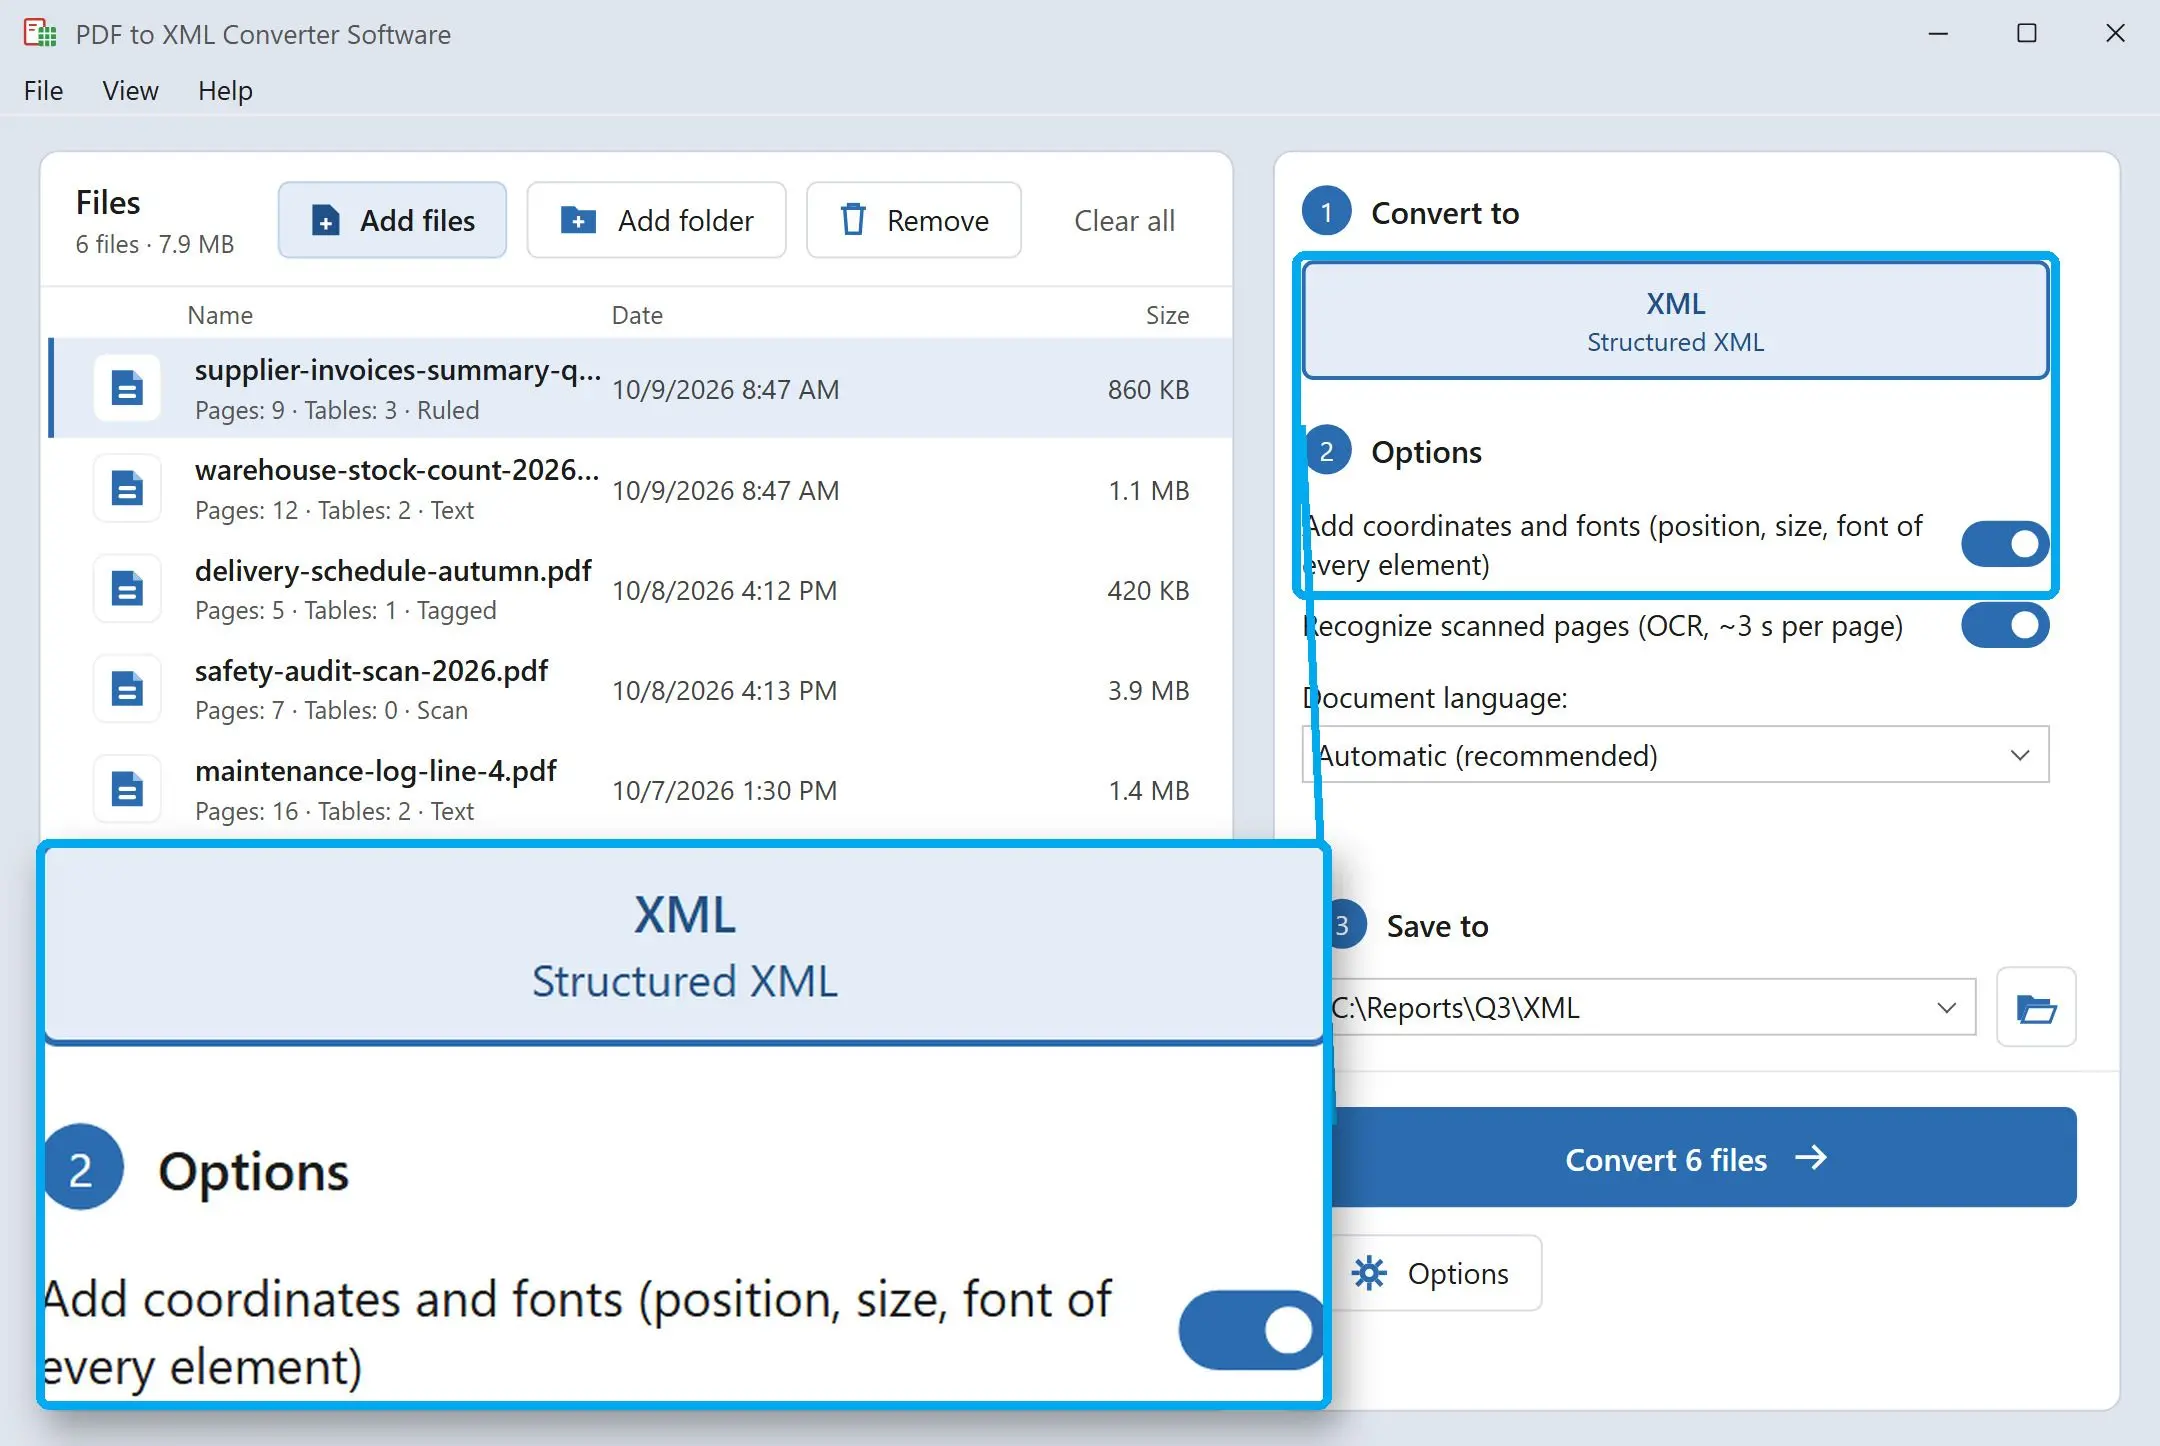
Lad koordinaterne stå slået fra for en kompakt fil med kun struktur og tekst. Slå dem til, og hver blok får x, y, w og h i punkter, en reference til en skrifttypepost og indlejrede linje- og tekstelementer - det detaljeniveau, du ville forvente af pdftohtml -xml.
Giv filerne videre til din kode
Hver fil er veldannet UTF-8 uden byte order mark. Læs den med ElementTree, lxml, XSLT eller din databases XML-indlæser; elementnavnene ændrer sig ikke fra en rapport til den næste.
Benefits
Tabeller ankommer som et gitter, ikke løse strenge
Hver tabel har sit antal rækker og kolonner, en overskriftsrække markeret header="1" og colspan eller rowspan på sammenlagte celler. Din indlæser kan tage kolonnenavne fra overskriften og gøre hver anden række til en post. En tabel, der løber over flere sider, skrives som én tabel pr. side.
Ét skema til hver fil
document, page, heading, paragraph, table, row, cell - de samme navne og attributter i hvert output, uanset om PDF-filen kom fra økonomi, en leverandør eller en scanner. Når næste kvartals rapport kommer, læser den import, du skrev til denne, også den.
Kører på din egen pc
Rapporter, kontrakter og prislister læses og skrives lokalt, uden upload og uden konto. Fortrolige dokumenter holdes ude af tredjepartstjenester, og jobbet kan køre på en maskine helt uden internetadgang.
Hvorfor folk bruger det
Overskriftsniveauer, du kan stole på
Niveau 1 til 6 fastsættes ud fra skriftstørrelse i forhold til brødteksten i hele dokumentet, ikke side for side. En kapiteloverskrift på side 40 får samme niveau som den på side 2, så et søgeindeks eller en indholdsfortegnelse kan stole på det.
Scannede sider flages, de skjules ikke
En side uden tekstlag markeres scanned="1". Når dens tekst kommer fra genkendelse (latinske og kyrilliske skriftsystemer), får siden ocr="1" og en konfidensværdi, og du får kun afsnit - tabeller registreres ikke på genkendte sider. Din pipeline kan sende de sider til manuel kontrol.
Løbende tekst forveksles ikke med en tabel
Brede mellemrum mellem ord narrer mange tabeldetektorer til at gøre en artikel i to kolonner til et falsk gitter. Den slags kandidater forkastes, og hver rigtig tabel registrerer, hvordan den blev fundet - fra PDF-tags, fra stregen mellem celler eller fra tekstjustering - i sin source-attribut.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note