PDF to Structured XML Exporter
O conteúdo do PDF como XML que um programa consegue ler
Converta ficheiros PDF em XML estruturado em lote, sem ligação: páginas, títulos, parágrafos e tabelas como linhas e células. Coordenadas e tipos de letra opcionais para cada bloco. Avaliação gratuita.
Full seller details: Legal information.
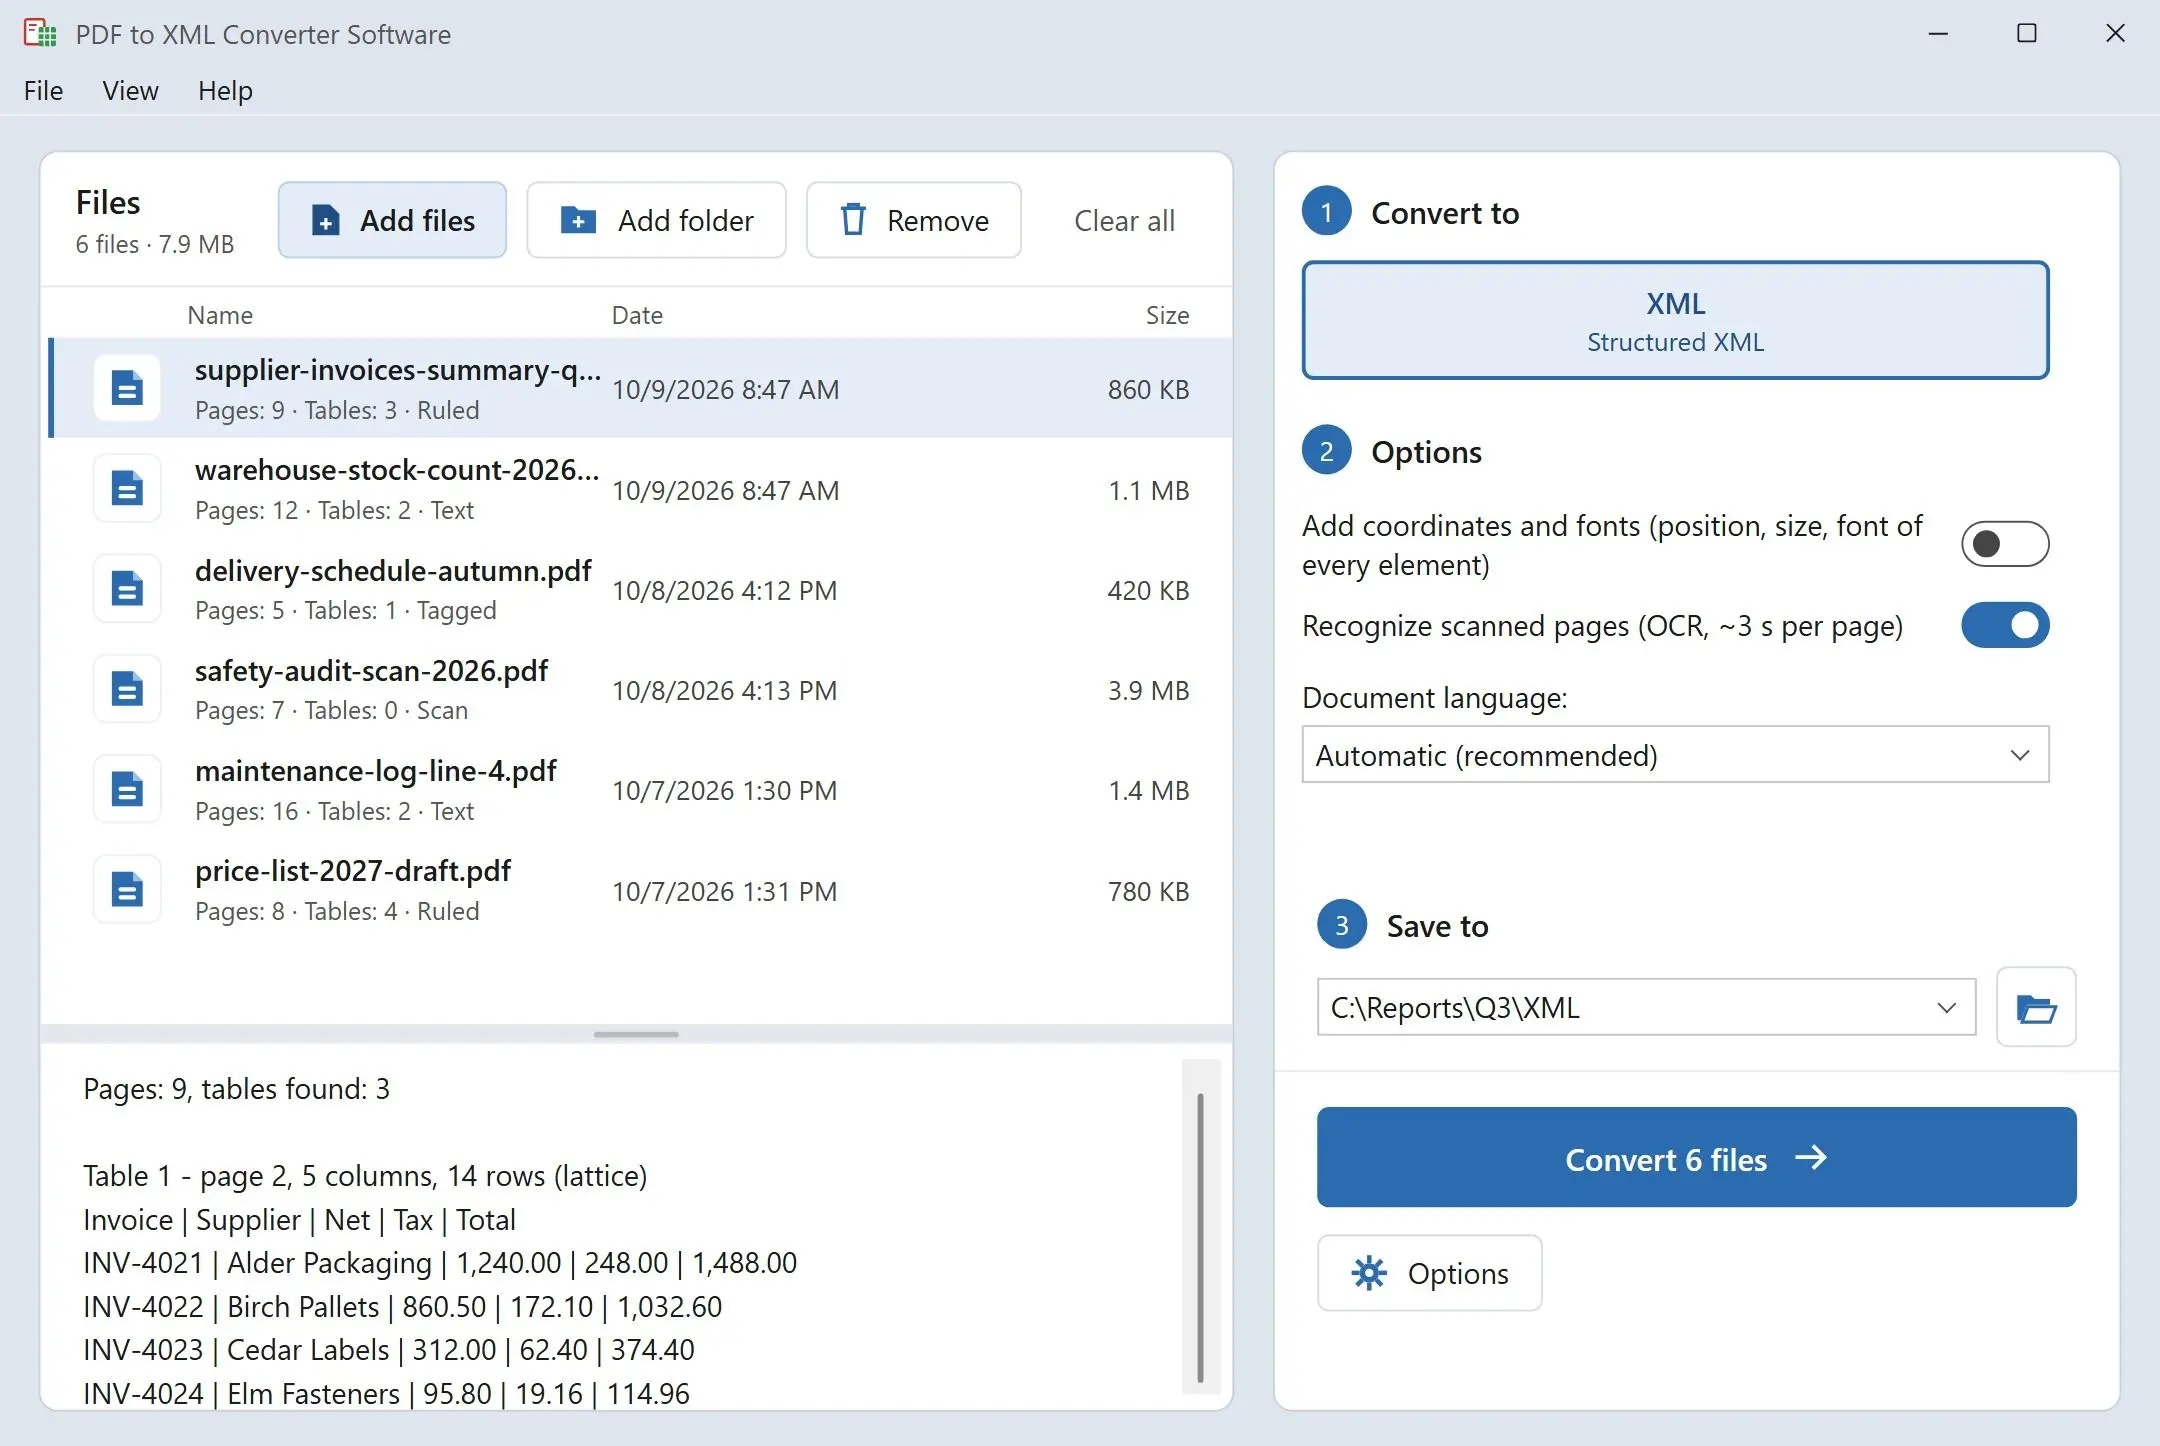
Dê-lhe uma pasta de relatórios e obtenha um ficheiro XML por PDF: um elemento de página para cada página, títulos com o respetivo nível, parágrafos e tabelas decompostas em linhas e células. Corre no seu PC com Windows, por isso nada é carregado.
Um PDF sabe onde vai a tinta, não o que significa
Dentro de um PDF não há parágrafo, título nem tabela - apenas pedaços de texto colocados em coordenadas numa página. Isso serve para imprimir e é inútil para um script de importação. A exportação XML dos editores de PDF descreve sobretudo essa disposição, e os sites de carregamento raramente dizem como é construída a sua saída. Este programa reconstrói a estrutura: agrupa linhas em parágrafos, classifica títulos pelo tamanho do tipo de letra, encontra grelhas de tabelas e escreve tudo sempre no mesmo esquema, para que o código que o lê não tenha de adivinhar.
How to use it
Carregue os PDF
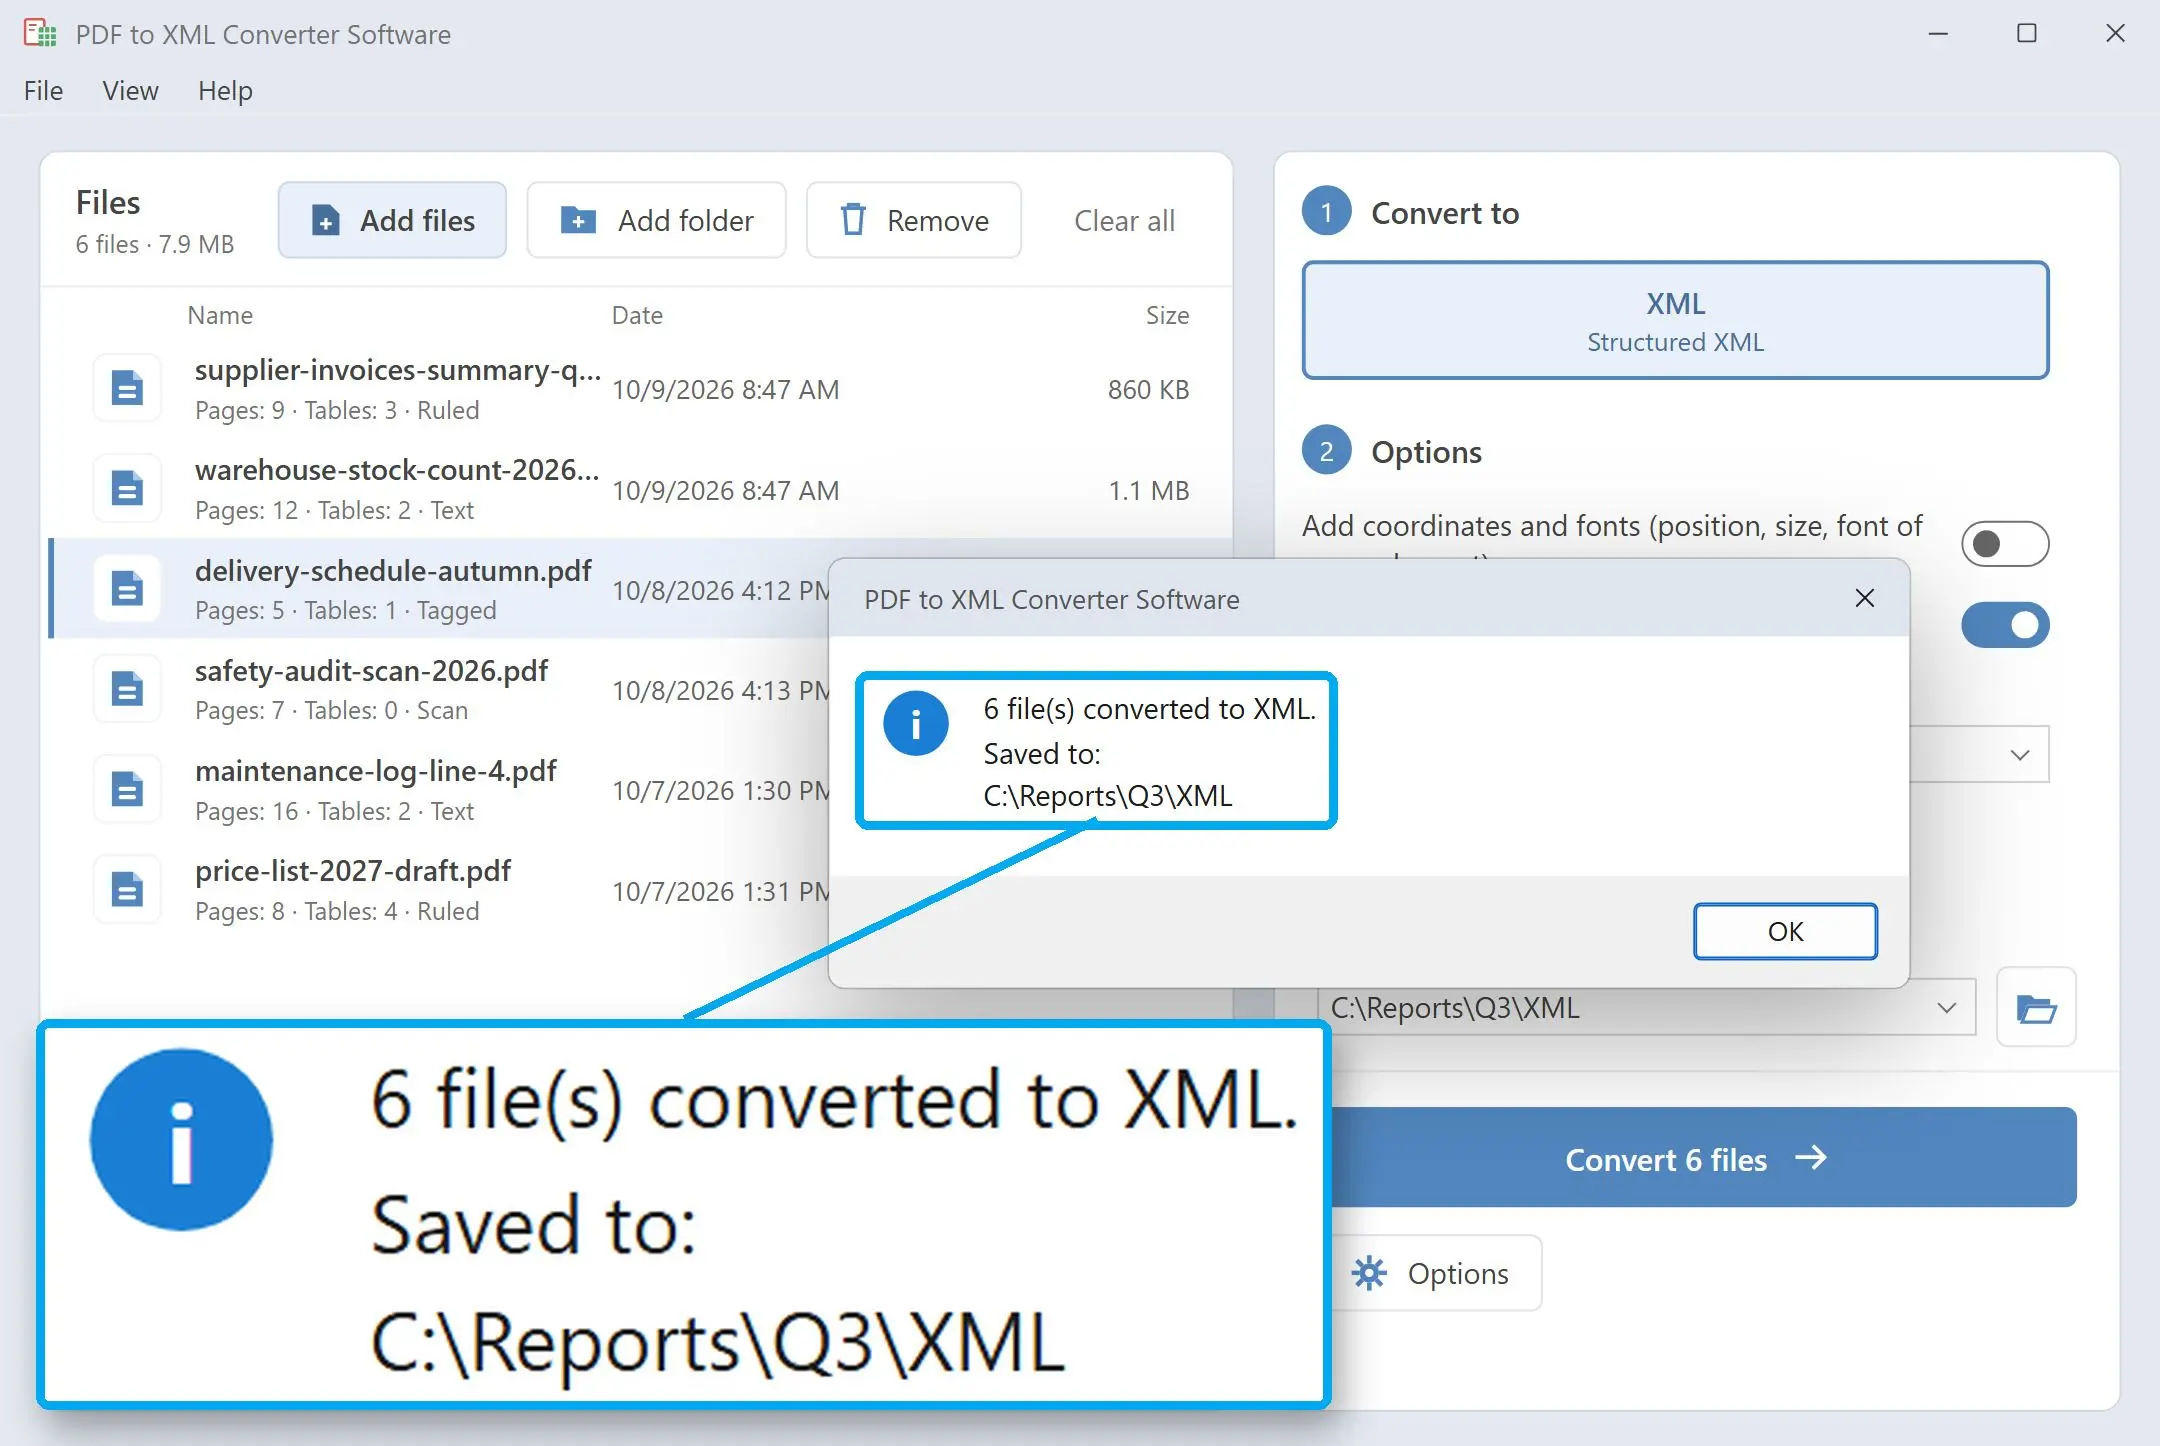
Adicione ficheiros individuais ou uma pasta inteira. Cada PDF recebe o seu próprio ficheiro XML com o nome da origem, e o programa pergunta uma vez por lote antes de substituir saídas mais antigas.
Escolha saída leve ou detalhada
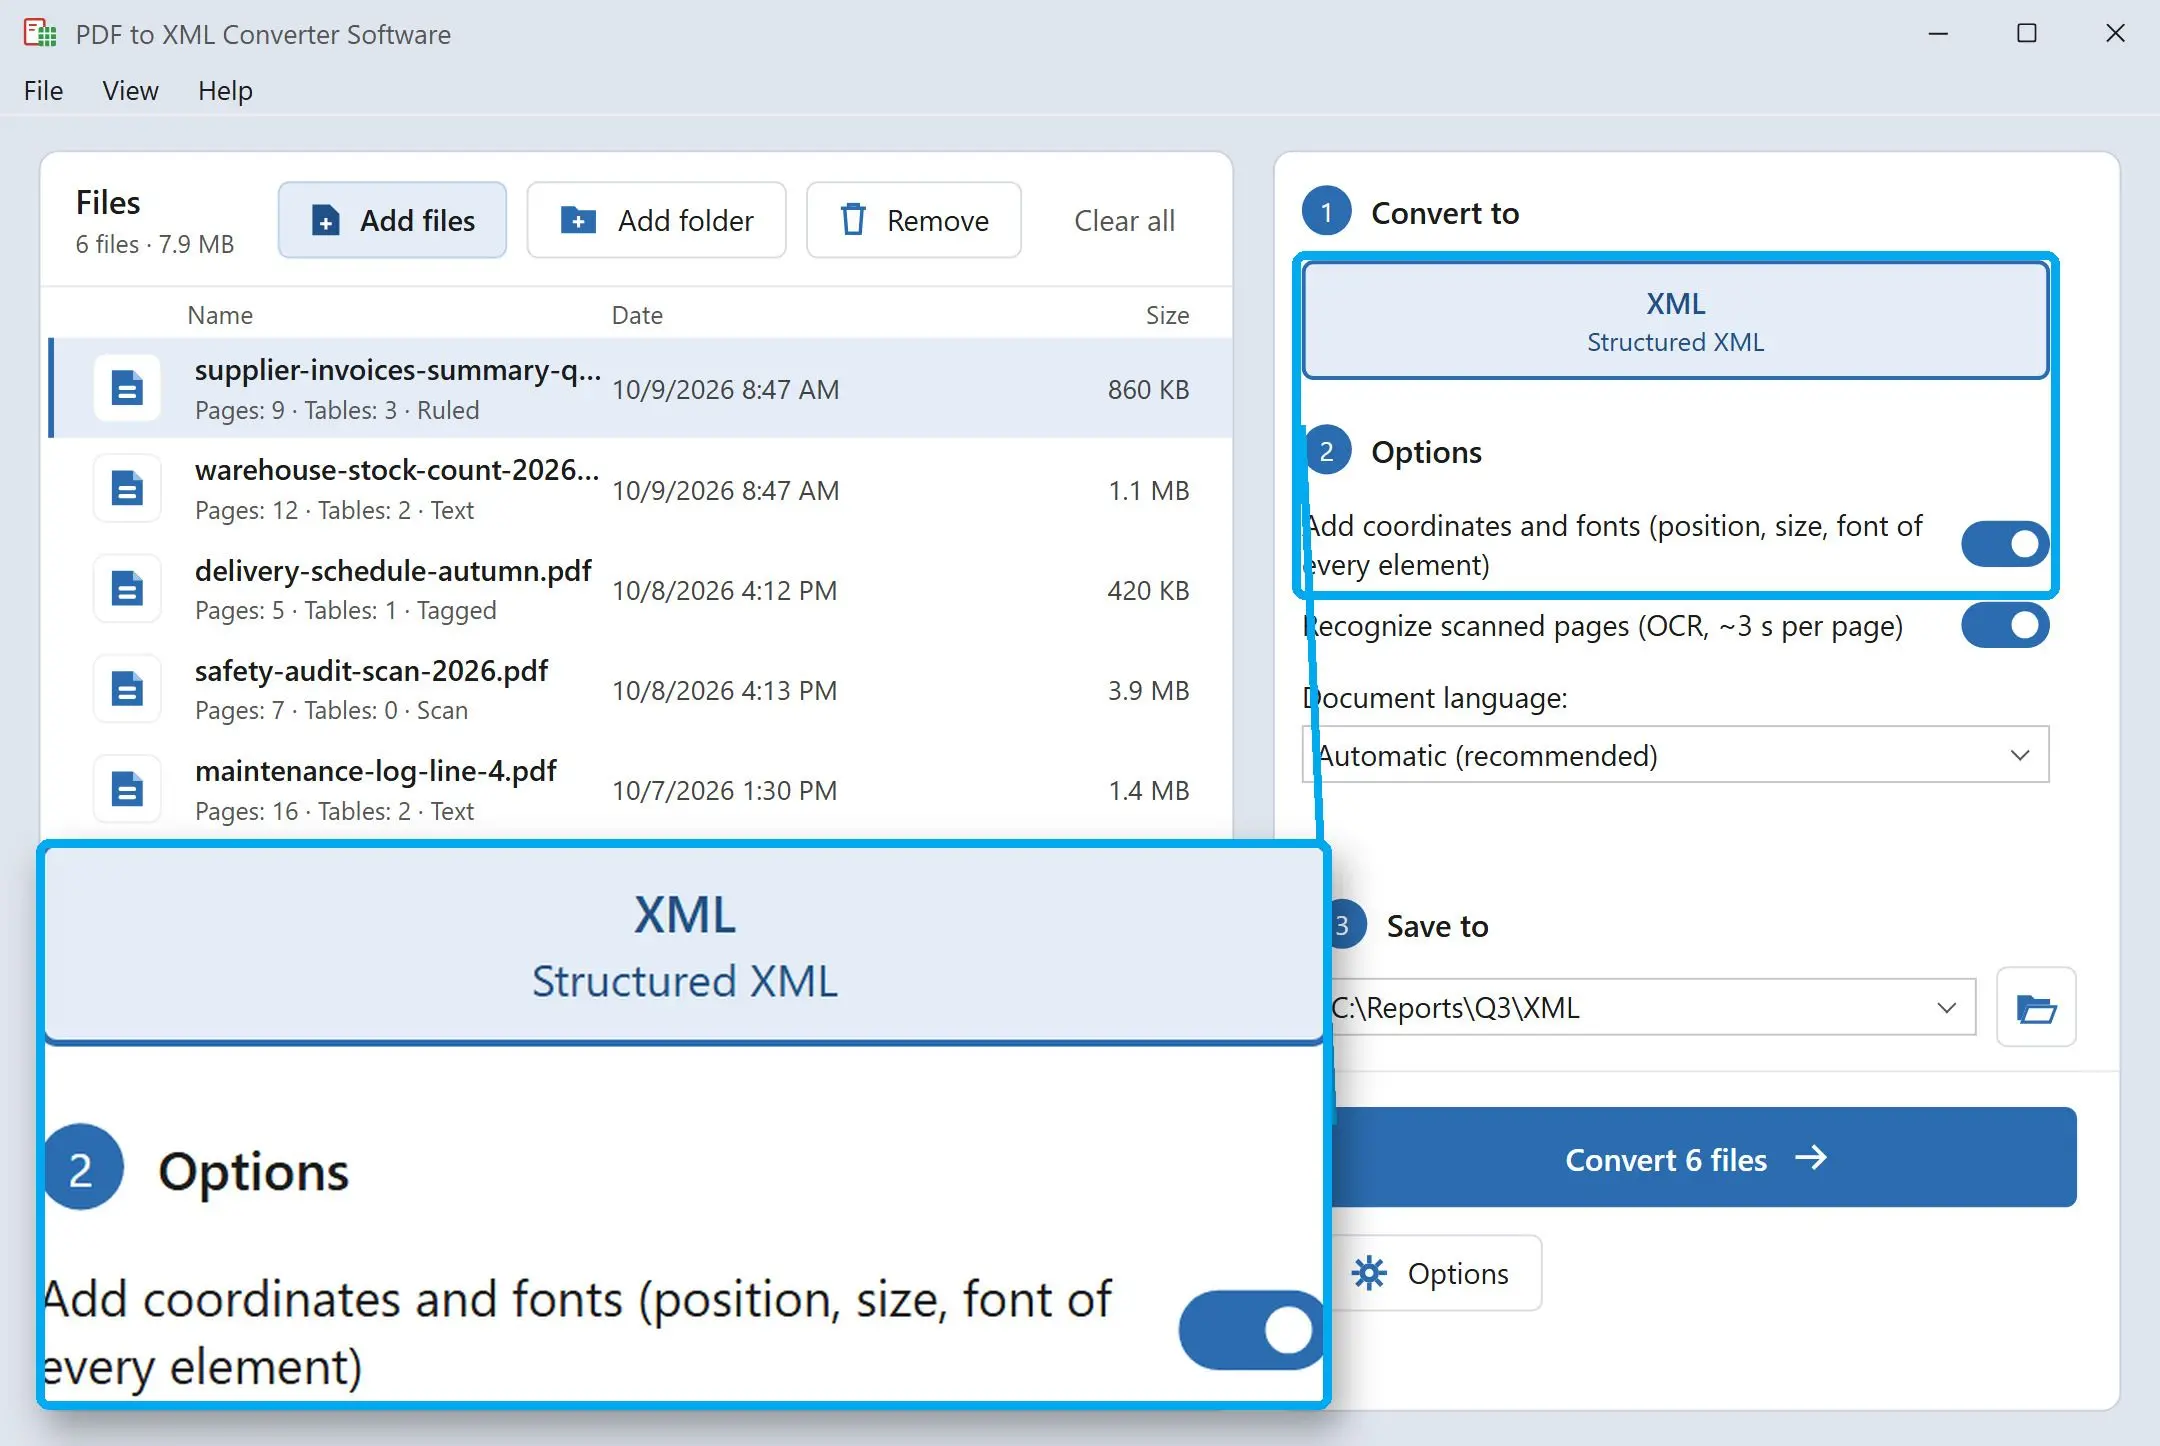
Deixe as coordenadas desativadas para um ficheiro compacto só com estrutura e texto. Ative-as e cada bloco recebe x, y, w e h em pontos, uma referência a uma entrada de tipo de letra e elementos de linha e de texto aninhados - o nível de detalhe que esperaria de pdftohtml -xml.
Entregue os ficheiros ao seu código
Cada ficheiro é UTF-8 bem formado, sem marca de ordem de bytes. Leia-o com ElementTree, lxml, XSLT ou o carregador XML da sua base de dados; os nomes dos elementos não mudam de um relatório para o seguinte.
Benefits
As tabelas chegam como grelha, não como cadeias soltas
Cada tabela traz o número de linhas e de colunas, uma linha de cabeçalho marcada header="1", e colspan ou rowspan nas células unidas. O seu carregador pode tirar os nomes das colunas do cabeçalho e transformar cada outra linha num registo. Uma tabela que se estende por várias páginas é escrita como uma tabela por página.
Um esquema para todos os ficheiros
document, page, heading, paragraph, table, row, cell - os mesmos nomes e atributos em todas as saídas, quer o PDF venha das finanças, de um fornecedor ou de um digitalizador. Quando chegar o relatório do trimestre seguinte, a importação que escreveu para este também o lê.
Corre no seu próprio PC
Relatórios, contratos e listas de preços são lidos e escritos localmente, sem carregamento nem conta. Os documentos confidenciais ficam fora de serviços de terceiros, e a tarefa corre numa máquina sem qualquer acesso à internet.
Por que as pessoas o usam
Níveis de título em que pode confiar
Os níveis de 1 a 6 são definidos pelo tamanho do tipo de letra em comparação com o corpo de texto de todo o documento, não página a página. Um título de capítulo na página 40 recebe o mesmo nível que o da página 2, por isso um índice de pesquisa ou um índice remissivo pode confiar nele.
As páginas digitalizadas são sinalizadas, não escondidas
Uma página sem camada de texto é marcada scanned="1". Quando o seu texto vem de reconhecimento (alfabetos latino e cirílico), a página leva ocr="1" e um valor de confiança, e obtém apenas parágrafos - as tabelas não são detetadas em páginas reconhecidas. O seu fluxo de trabalho pode encaminhar essas páginas para verificação manual.
A prosa não é confundida com uma tabela
Grandes espaços entre palavras enganam muitos detetores de tabelas, que transformam um artigo a duas colunas numa grelha falsa. Candidatas assim são rejeitadas, e cada tabela verdadeira regista como foi encontrada - pelas etiquetas do PDF, por linhas de grelha ou por alinhamento do texto - no seu atributo source.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note