PDF to Structured XML Exporter
El contenido del PDF como XML que un programa puede leer
Convierte archivos PDF a XML estructurado por lotes y sin conexión: páginas, encabezados, párrafos y tablas como filas y celdas. Coordenadas y fuentes opcionales para cada bloque. Prueba gratuita.
Full seller details: Legal information.
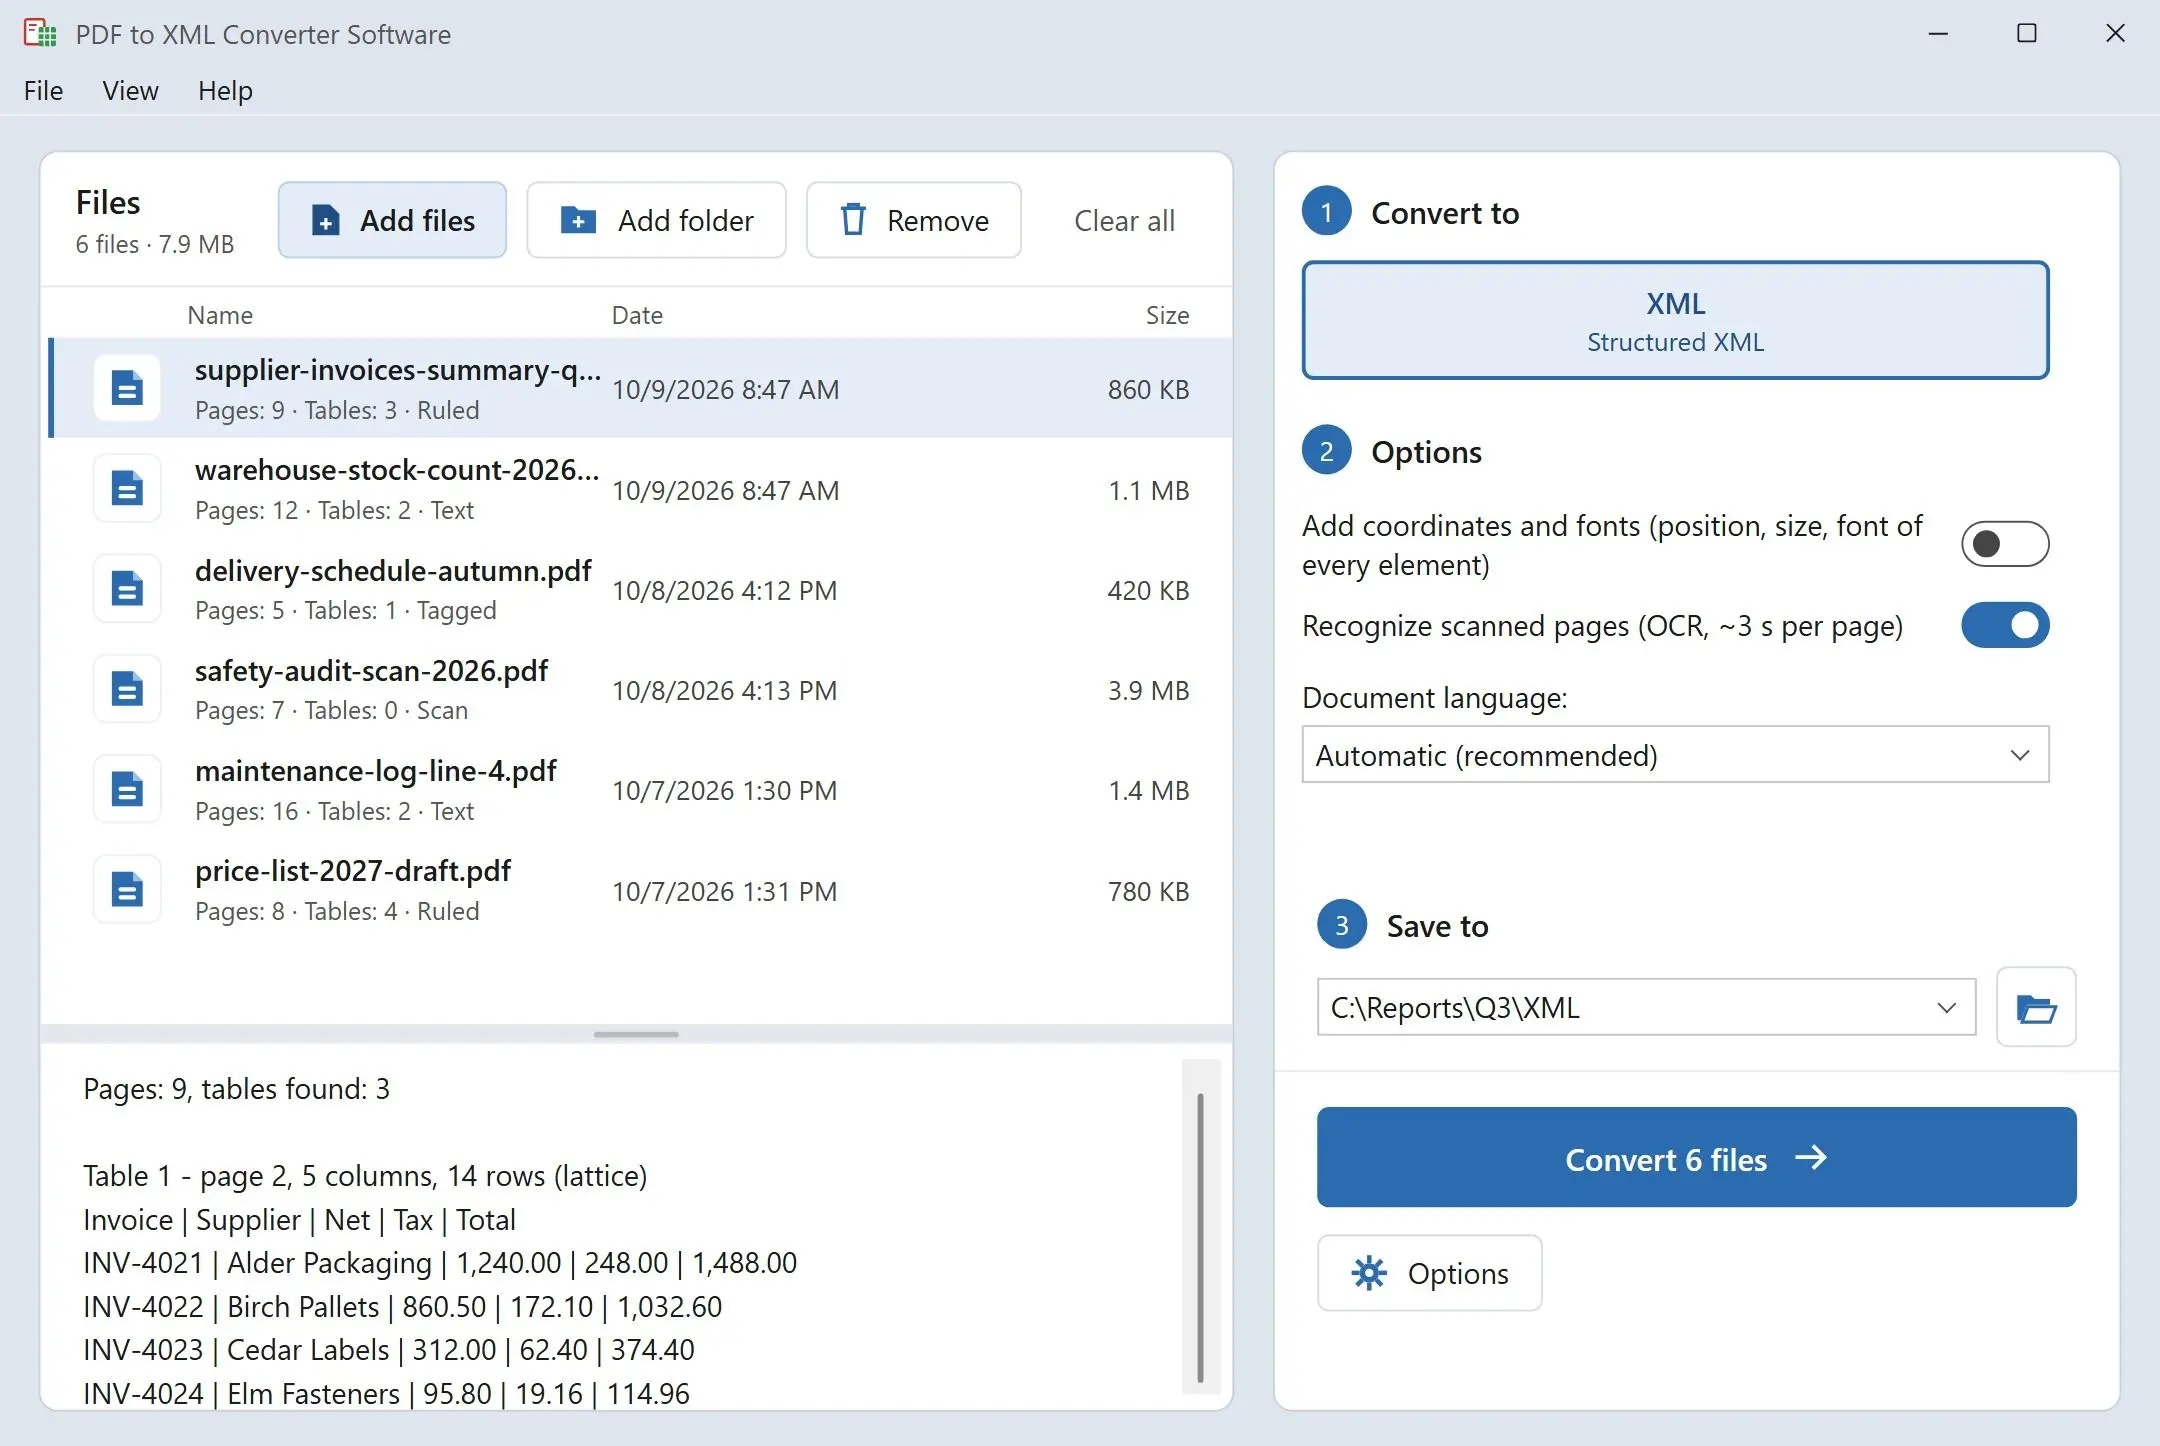
Dale una carpeta de informes y obtén un archivo XML por cada PDF: un elemento page por cada página, encabezados con su nivel, párrafos y tablas desglosadas en filas y celdas. Se ejecuta en tu PC con Windows, así que no se sube nada.
Un PDF sabe dónde va la tinta, no qué significa
Dentro de un PDF no hay párrafos, ni encabezados, ni tablas: solo trozos de texto colocados en coordenadas de una página. Eso va bien para imprimir y no sirve para un script de importación. La exportación a XML de los editores de PDF describe sobre todo esa maquetación, y los sitios de subida rara vez explican cómo se construye su salida. Este programa reconstruye la estructura: agrupa las líneas en párrafos, jerarquiza los encabezados por tamaño de fuente, encuentra las cuadrículas de las tablas y lo escribe todo siempre con el mismo esquema, para que el código que lo lee no tenga que adivinar.
How to use it
Carga los PDF
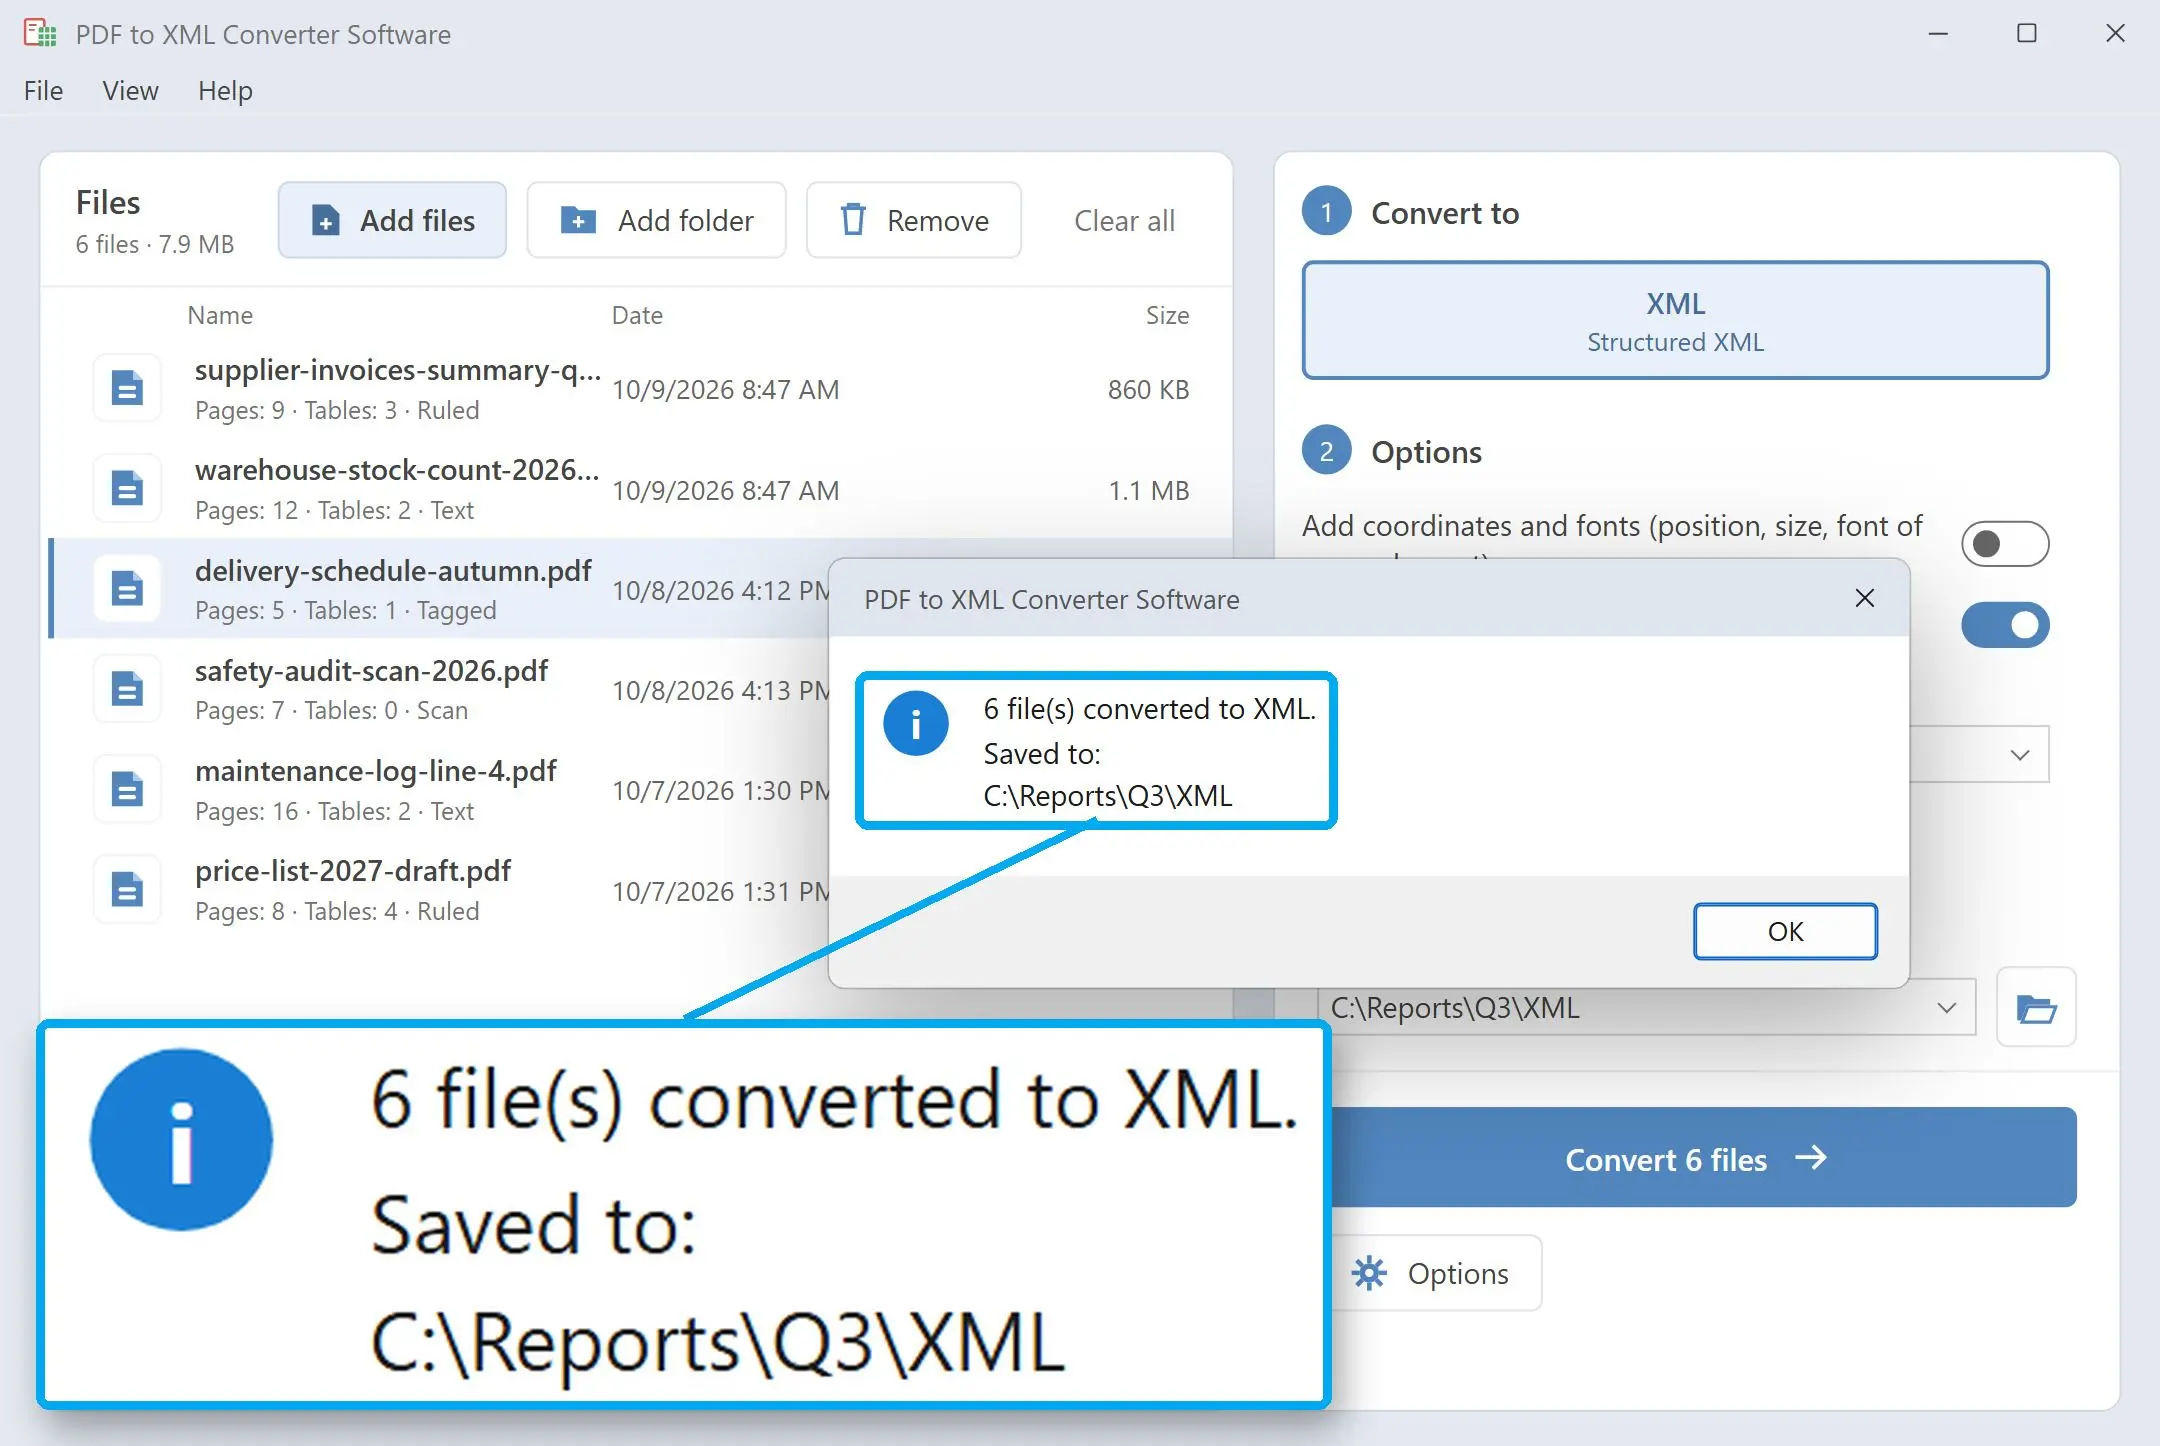
Añade archivos sueltos o una carpeta entera. Cada PDF recibe su propio archivo XML con el nombre del origen, y el programa pregunta una vez por lote antes de reemplazar una salida anterior.
Elige salida ligera o detallada
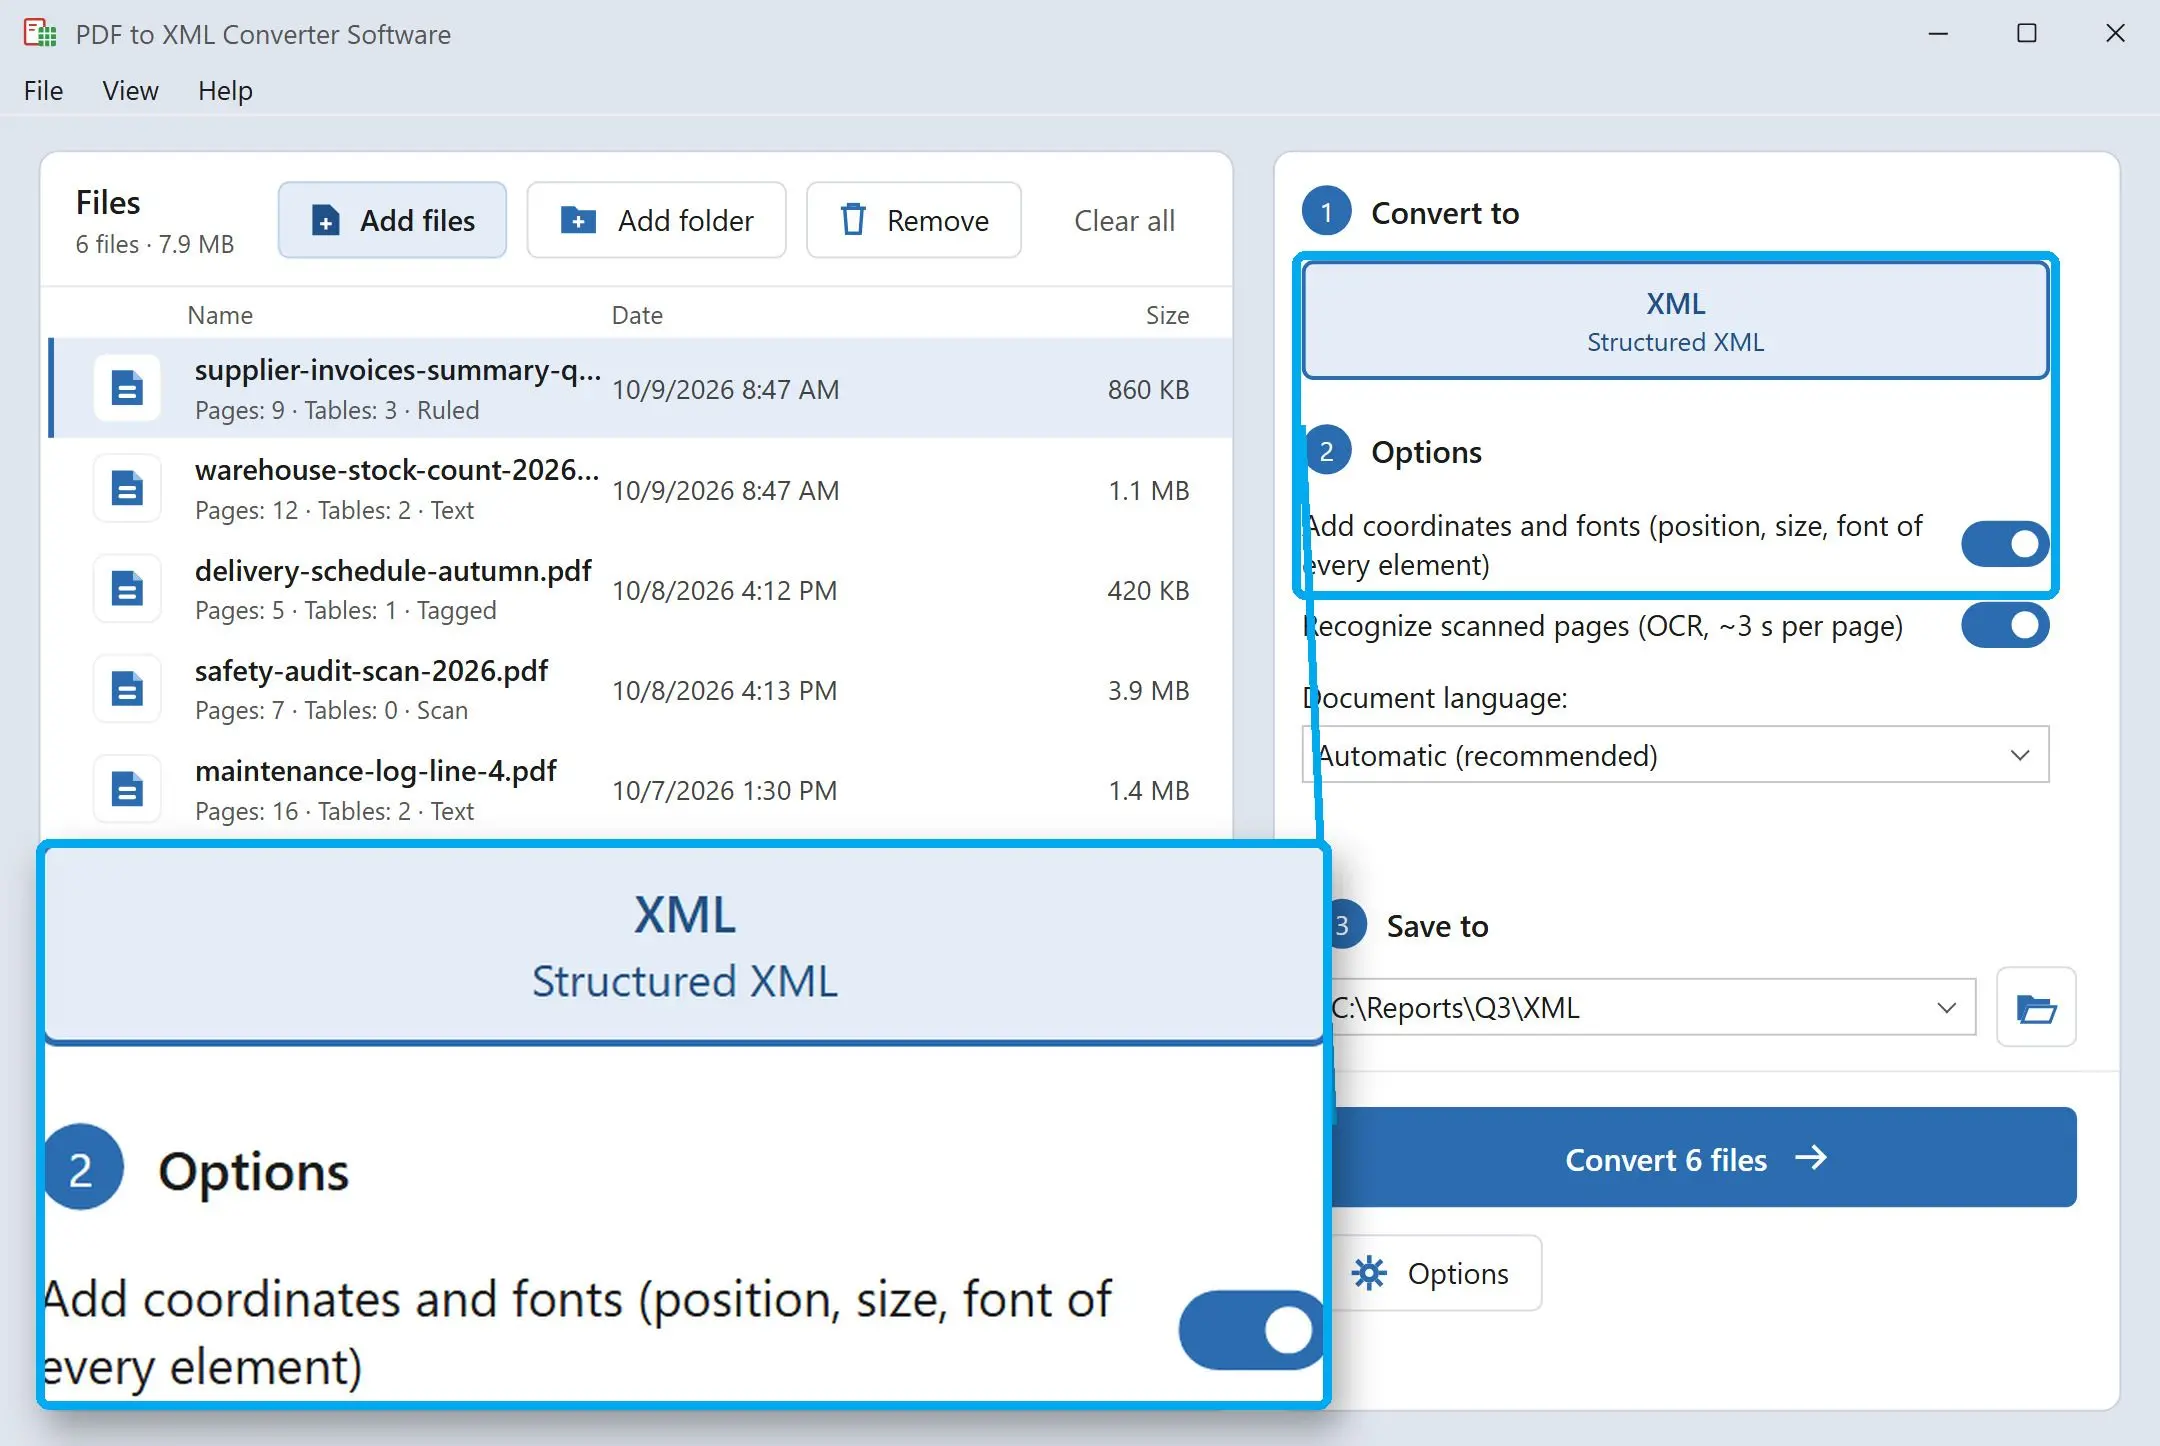
Deja las coordenadas desactivadas para un archivo compacto con solo estructura y texto. Actívalas y cada bloque recibe x, y, w y h en puntos, una referencia a una entrada de fuente y elementos anidados de línea y de texto: el nivel de detalle que esperarías de pdftohtml -xml.
Pasa los archivos a tu código
Cada archivo es UTF-8 bien formado sin marca de orden de bytes. Léelo con ElementTree, lxml, XSLT o el cargador XML de tu base de datos; los nombres de los elementos no cambian de un informe a otro.
Benefits
Las tablas llegan como cuadrícula, no como cadenas sueltas
Cada tabla lleva su número de filas y columnas, una fila de encabezado marcada con header="1", y colspan o rowspan en las celdas combinadas. Tu cargador puede tomar los nombres de columna del encabezado y convertir cada otra fila en un registro. Una tabla que ocupa varias páginas se escribe como una tabla por página.
Un esquema para todos los archivos
document, page, heading, paragraph, table, row, cell: los mismos nombres y atributos en cada salida, venga el PDF de finanzas, de un proveedor o de un escáner. Cuando llegue el informe del próximo trimestre, la importación que escribiste para este también lo leerá.
Se ejecuta en tu propio PC
Los informes, contratos y listas de precios se leen y se escriben en local, sin subidas ni cuentas. Los documentos confidenciales quedan fuera de servicios de terceros, y el trabajo se ejecuta en un equipo sin acceso a internet.
Por qué la gente lo usa
Niveles de encabezado en los que puedes confiar
Los niveles de 1 a 6 se asignan según el tamaño de fuente comparado con el texto de cuerpo de todo el documento, no página por página. Un título de capítulo de la página 40 recibe el mismo nivel que el de la página 2, así que un índice de búsqueda o una tabla de contenidos pueden fiarse de él.
Las páginas escaneadas se marcan, no se ocultan
Una página sin capa de texto se marca con scanned="1". Cuando su texto procede de reconocimiento (alfabetos latino y cirílico), la página lleva ocr="1" y un valor de confianza, y solo obtienes párrafos: en las páginas reconocidas no se detectan tablas. Tu flujo de trabajo puede enviar esas páginas a una revisión manual.
La prosa no se confunde con una tabla
Los grandes espacios entre palabras engañan a muchos detectores de tablas y convierten un artículo a dos columnas en una falsa cuadrícula. Los candidatos así se descartan, y cada tabla real registra cómo se encontró (por etiquetas del PDF, por líneas de separación o por alineación del texto) en su atributo source.
Preguntas frecuentes
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note