PDF to Structured XML Exporter
PDF-Inhalte als XML, das ein Programm lesen kann
Wandeln Sie PDF-Dateien stapelweise und offline in strukturiertes XML um: Seiten, Überschriften, Absätze und Tabellen als Zeilen und Zellen. Optional Koordinaten und Schriften für jeden Block. Kostenlos testen.
Full seller details: Legal information.
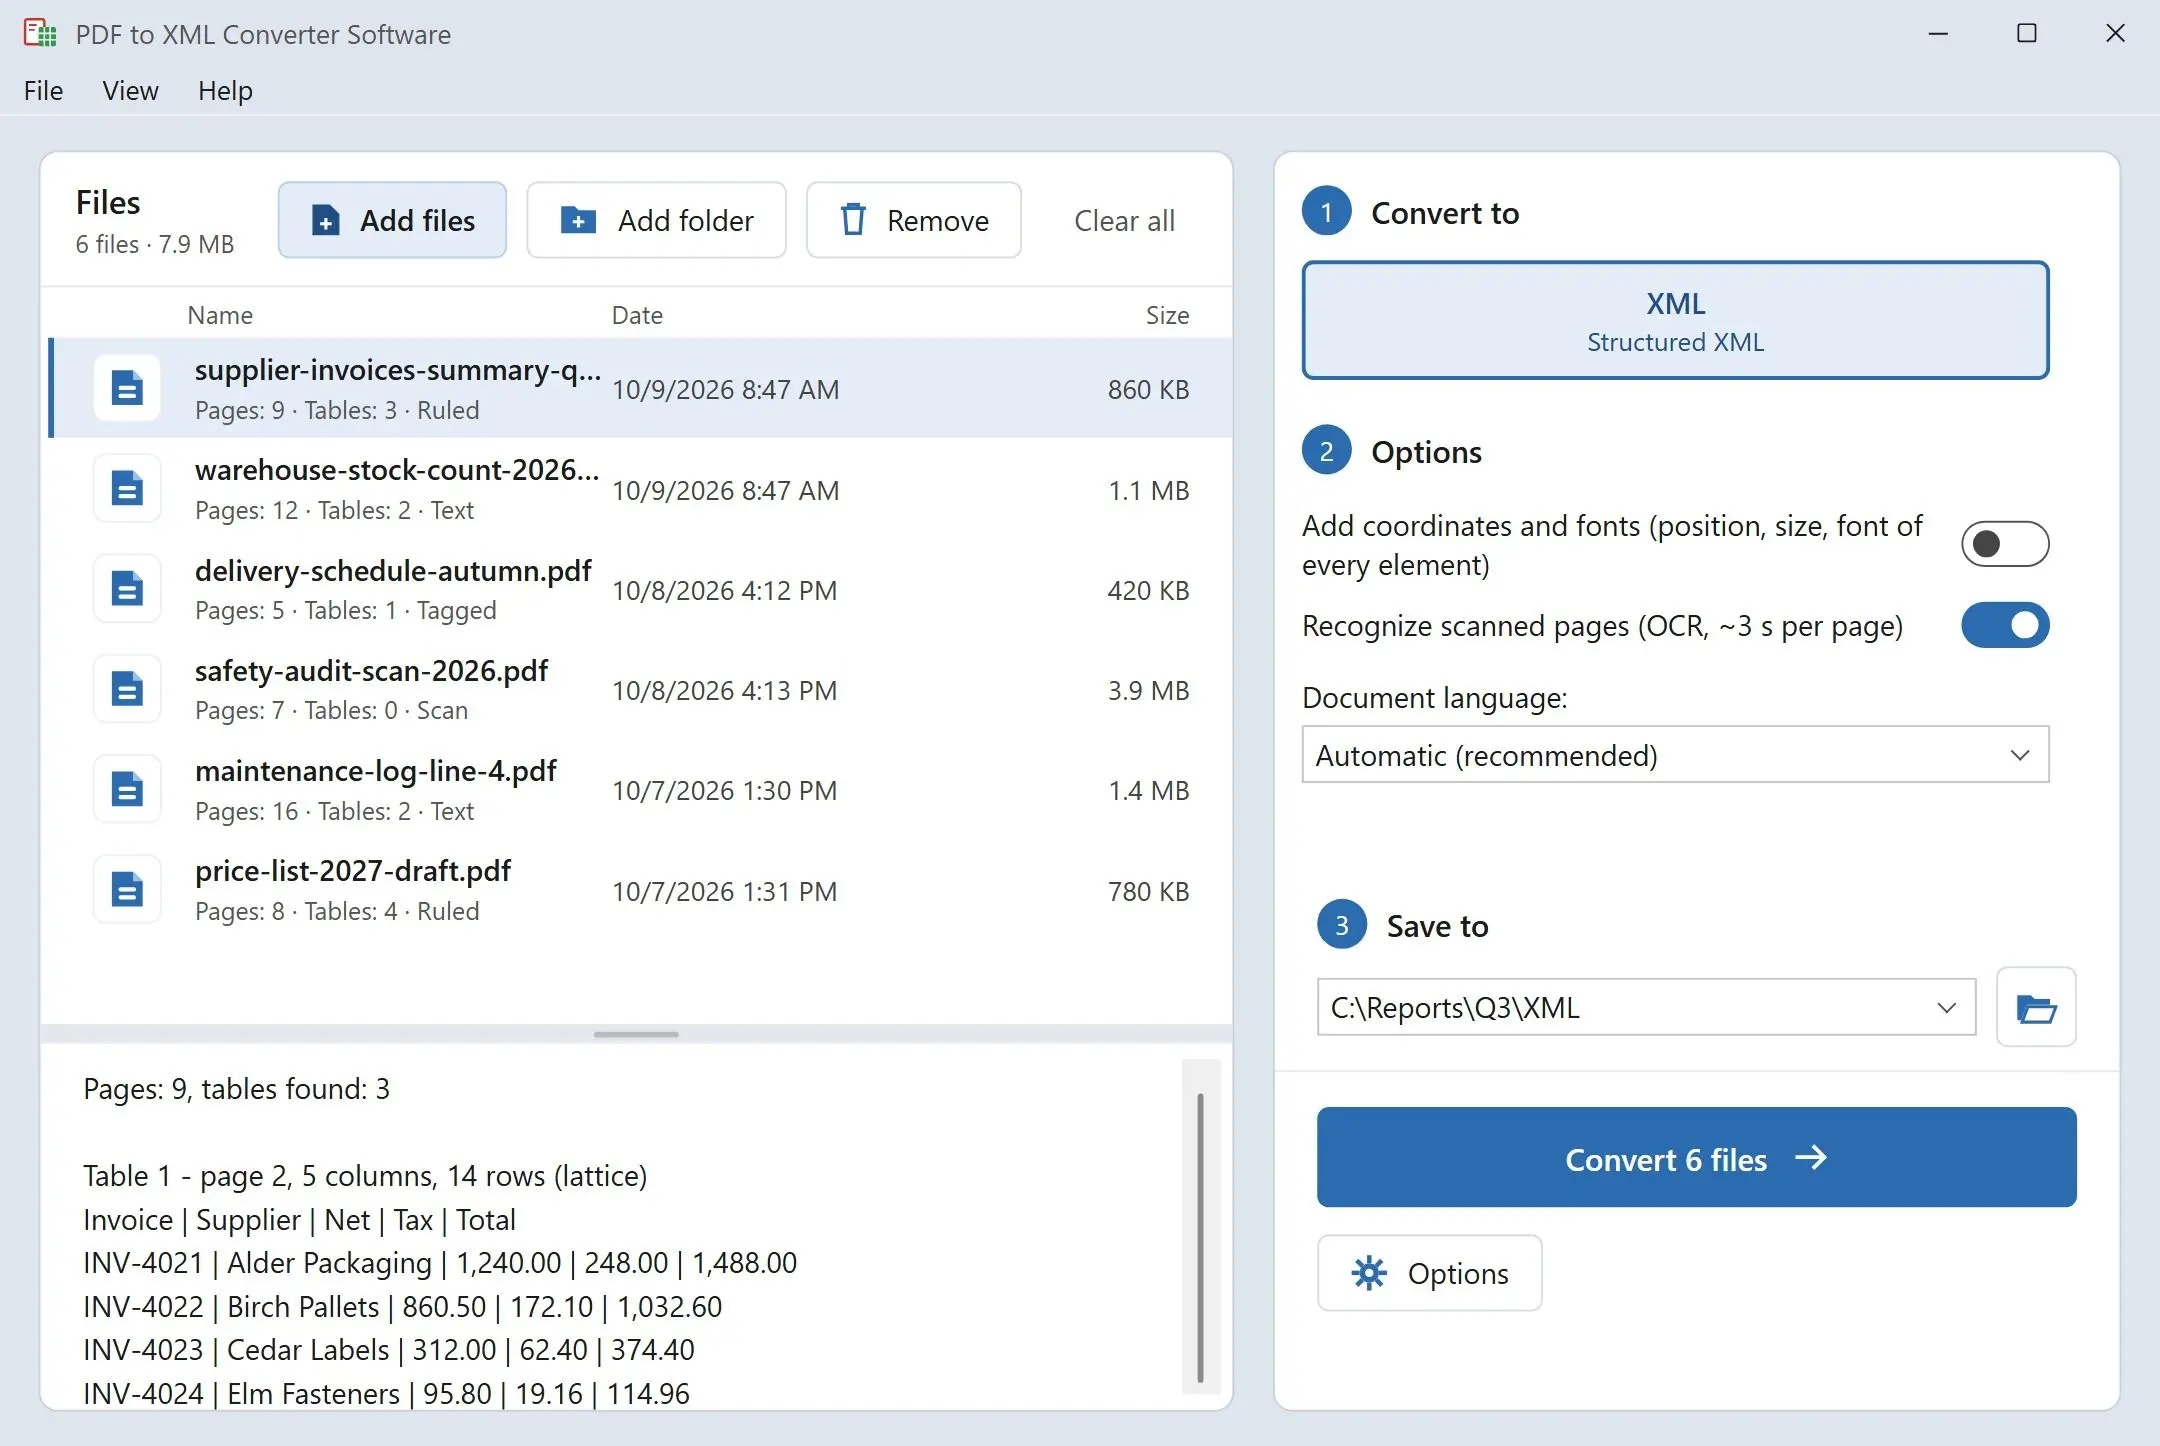
Geben Sie einen Ordner mit Berichten hinein und erhalten Sie pro PDF eine XML-Datei: ein Seitenelement für jede Seite, Überschriften mit ihrer Ebene, Absätze und Tabellen, aufgeteilt in Zeilen und Zellen. Es läuft auf Ihrem Windows-PC, es wird also nichts hochgeladen.
Eine PDF weiß, wo die Tinte hinkommt, nicht was sie bedeutet
In einer PDF gibt es keinen Absatz, keine Überschrift und keine Tabelle - nur Textstücke, die an Koordinaten auf einer Seite platziert sind. Für den Druck ist das in Ordnung, für ein Import-Skript nutzlos. Der XML-Export in PDF-Editoren beschreibt meist nur dieses Layout, und Upload-Seiten sagen selten, wie ihre Ausgabe aufgebaut ist. Dieses Programm baut stattdessen die Struktur nach: Es gruppiert Zeilen zu Absätzen, stuft Überschriften nach Schriftgröße ein, findet Tabellenraster und schreibt alles jedes Mal im selben Schema, sodass der Code, der es liest, nicht raten muss.
How to use it
PDFs laden
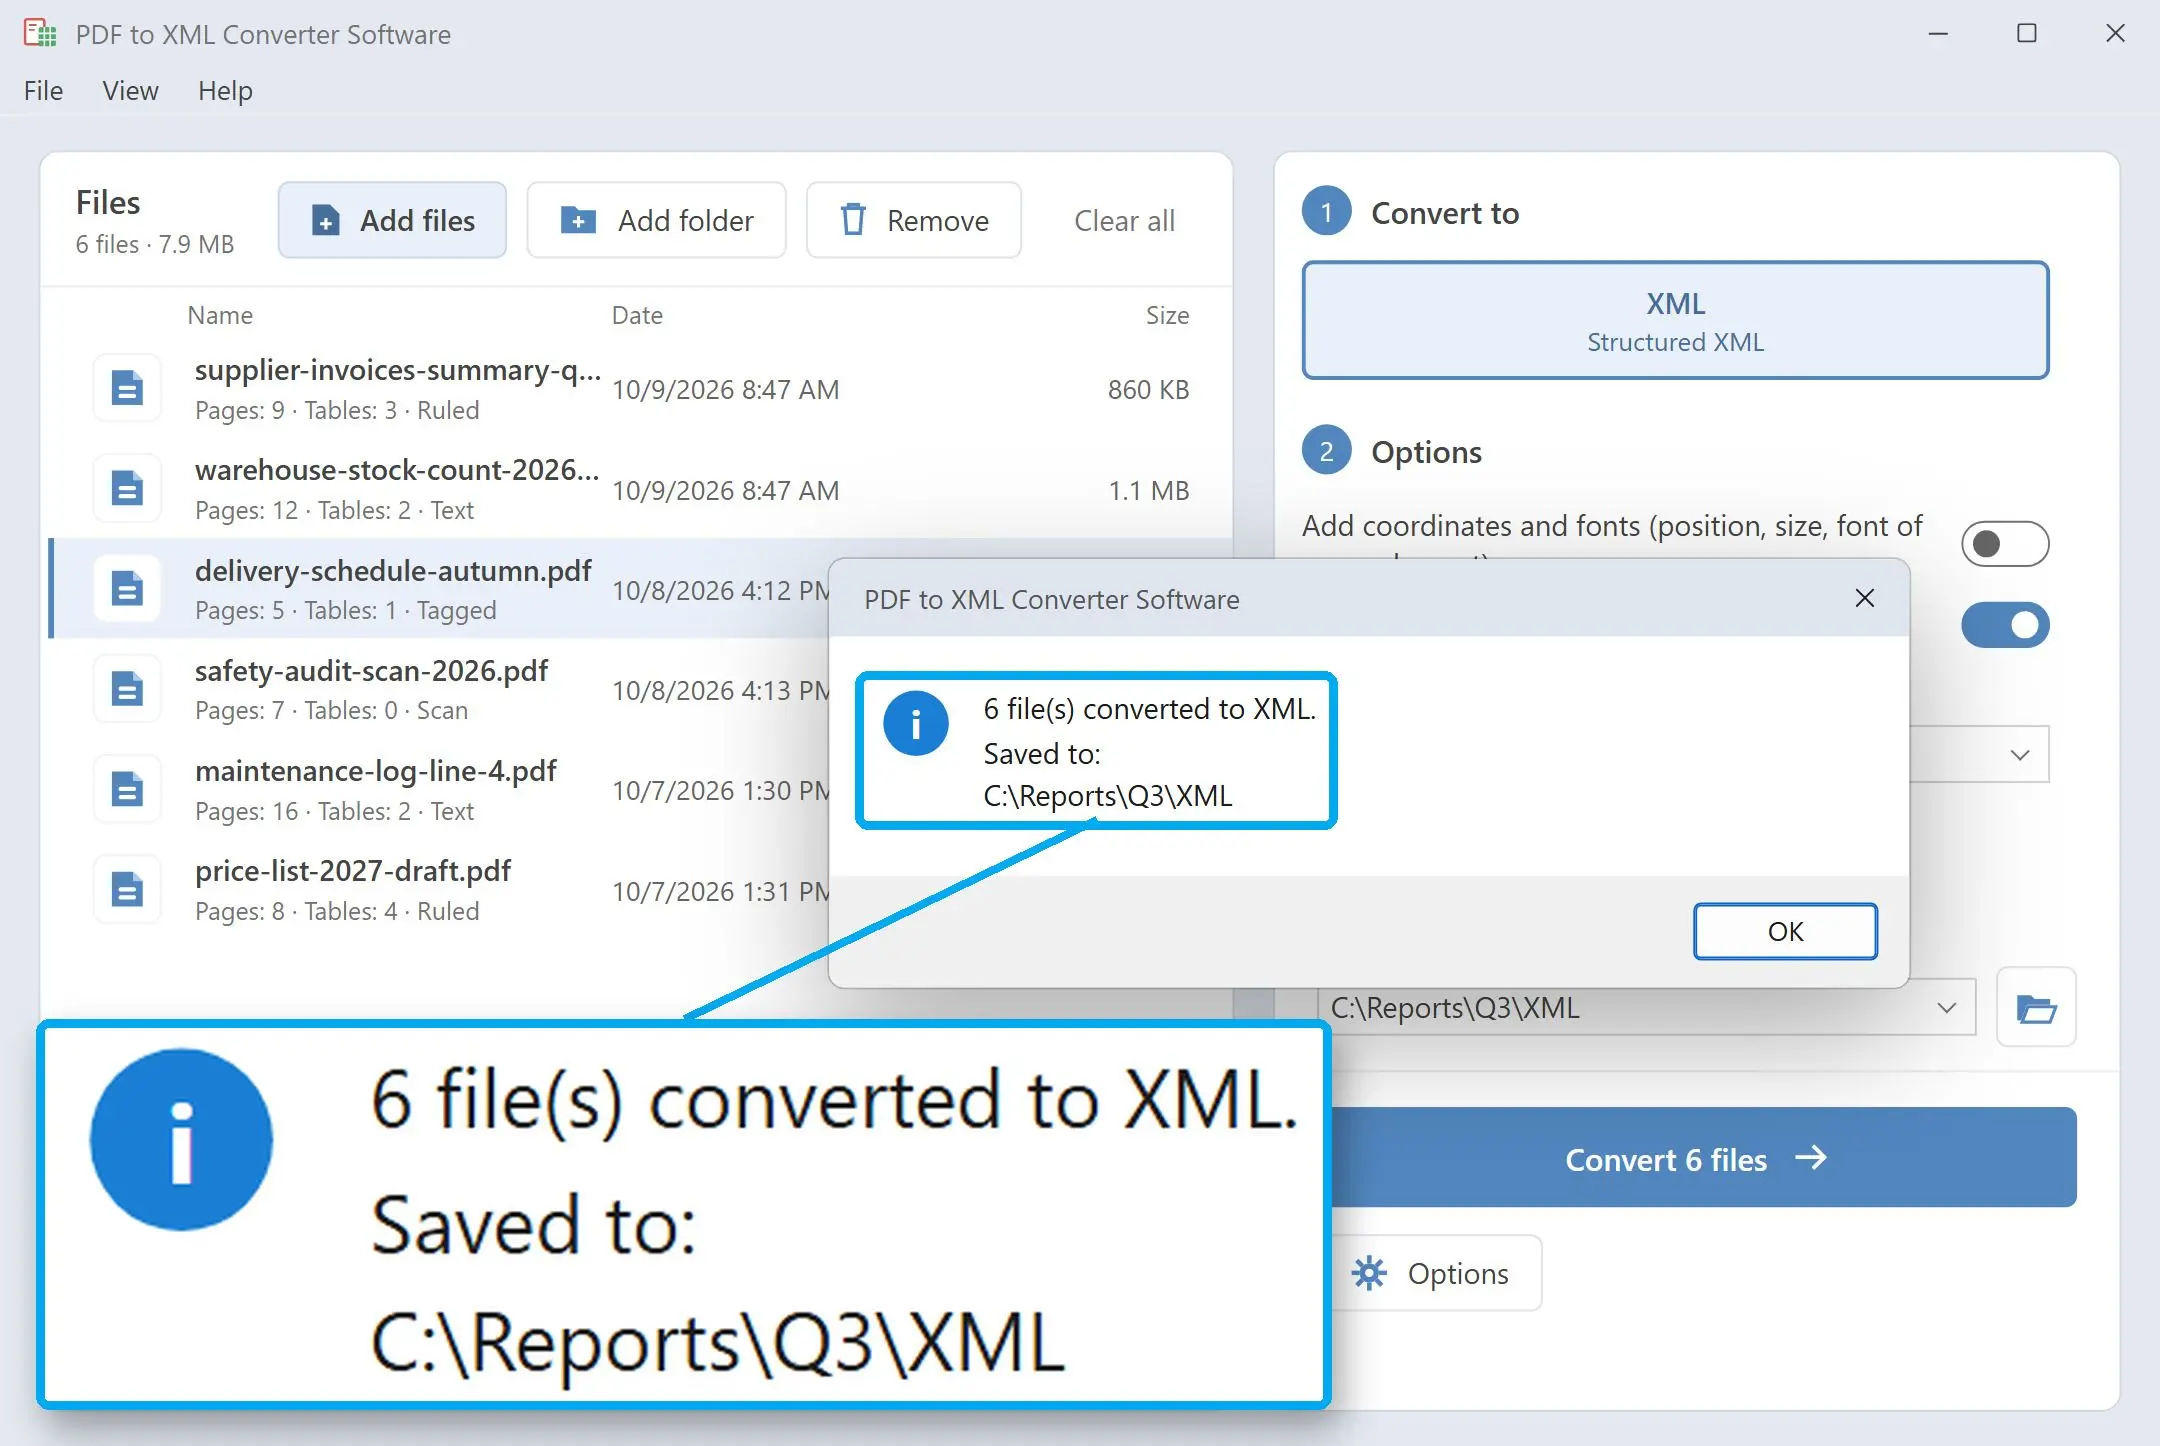
Fügen Sie einzelne Dateien oder einen ganzen Ordner hinzu. Jede PDF erhält eine eigene XML-Datei, benannt nach der Quelle, und das Programm fragt einmal pro Stapel, bevor es ältere Ausgaben ersetzt.
Schlanke oder detaillierte Ausgabe wählen
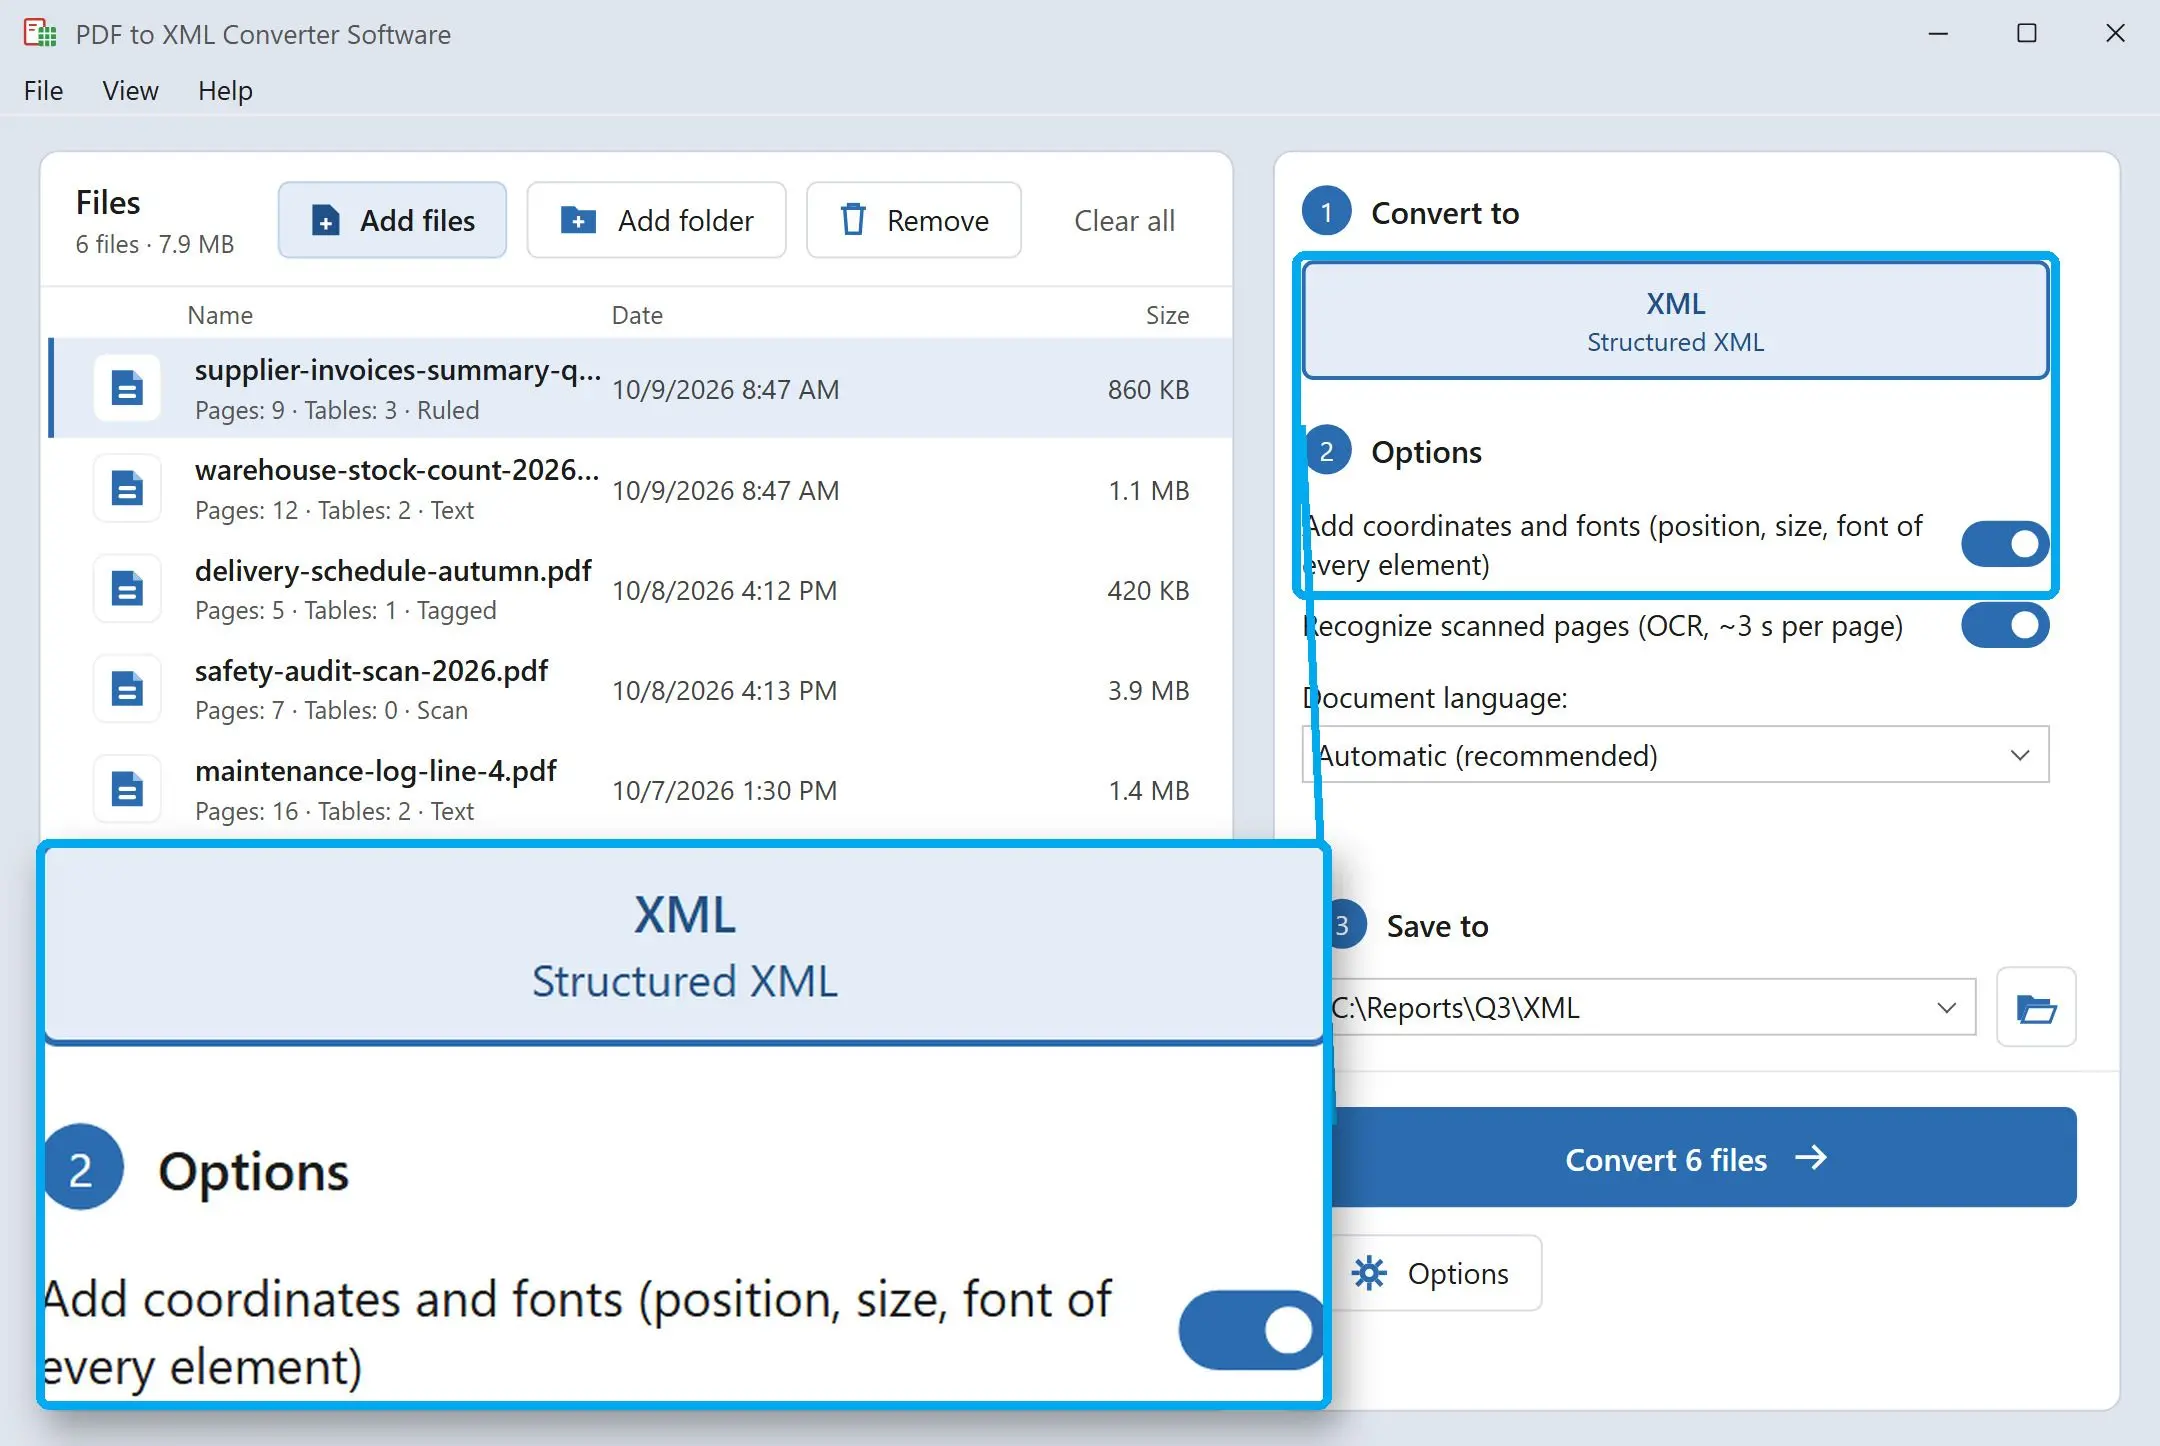
Lassen Sie die Koordinaten aus, um eine kompakte Datei nur mit Struktur und Text zu erhalten. Schalten Sie sie ein, und jeder Block bekommt x, y, w und h in Punkt, einen Verweis auf einen Schrifteintrag sowie verschachtelte Zeilen- und Textelemente - den Detailgrad, den Sie von pdftohtml -xml erwarten würden.
Die Dateien an Ihren Code übergeben
Jede Datei ist wohlgeformtes UTF-8 ohne Byte Order Mark. Lesen Sie sie mit ElementTree, lxml, XSLT oder dem XML-Loader Ihrer Datenbank; die Elementnamen ändern sich von einem Bericht zum nächsten nicht.
Benefits
Tabellen kommen als Raster an, nicht als lose Zeichenfolgen
Jede Tabelle trägt ihre Zeilen- und Spaltenanzahl, eine als header="1" markierte Kopfzeile sowie colspan oder rowspan bei verbundenen Zellen. Ihr Loader kann Spaltennamen aus der Kopfzeile nehmen und jede weitere Zeile in einen Datensatz verwandeln. Eine Tabelle über mehrere Seiten wird als eine Tabelle pro Seite geschrieben.
Ein Schema für jede Datei
document, page, heading, paragraph, table, row, cell - in jeder Ausgabe dieselben Namen und Attribute, egal ob die PDF aus der Buchhaltung, von einem Lieferanten oder einem Scanner stammt. Wenn der Bericht des nächsten Quartals eintrifft, liest der Import, den Sie für diesen geschrieben haben, auch ihn.
Läuft auf Ihrem eigenen PC
Berichte, Verträge und Preislisten werden lokal gelesen und geschrieben, ohne Upload und ohne Konto. Vertrauliche Dokumente bleiben aus Diensten Dritter heraus, und der Auftrag läuft auch auf einem Rechner ganz ohne Internetzugang.
Warum Leute es benutzen
Überschriftsebenen, auf die Verlass ist
Die Ebenen 1 bis 6 werden aus der Schriftgröße im Vergleich zum Fließtext des gesamten Dokuments bestimmt, nicht seitenweise. Ein Kapiteltitel auf Seite 40 erhält dieselbe Ebene wie der auf Seite 2, sodass sich ein Suchindex oder ein Inhaltsverzeichnis darauf verlassen kann.
Gescannte Seiten werden markiert, nicht versteckt
Eine Seite ohne Textebene wird mit scanned="1" markiert. Stammt ihr Text aus der Erkennung (lateinische und kyrillische Schriften), trägt die Seite ocr="1" und einen Konfidenzwert, und Sie erhalten nur Absätze - auf erkannten Seiten werden keine Tabellen gefunden. Ihre Pipeline kann diese Seiten zur manuellen Prüfung umleiten.
Fließtext wird nicht für eine Tabelle gehalten
Große Lücken zwischen Wörtern verleiten viele Tabellenerkenner dazu, einen zweispaltigen Artikel in ein falsches Raster zu verwandeln. Solche Kandidaten werden verworfen, und jede echte Tabelle hält in ihrem Attribut source fest, wie sie gefunden wurde - aus PDF-Tags, aus Trennlinien oder aus der Textausrichtung.
FAQ
System Requirements
PDF to Structured XML Exporter
Languages
3.3
9 Mb
October 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note