Masowy eksporter stron WWW do PDF
Zapisane strony na wejściu, jeden PDF na wyjściu
Przekonwertuj folder zapisanych stron .html, .htm i .xhtml na PDF na własnym komputerze, z obrazami i stylami, albo połącz je w jeden dokument. Bezpłatna wersja próbna.
Full seller details: Legal information.
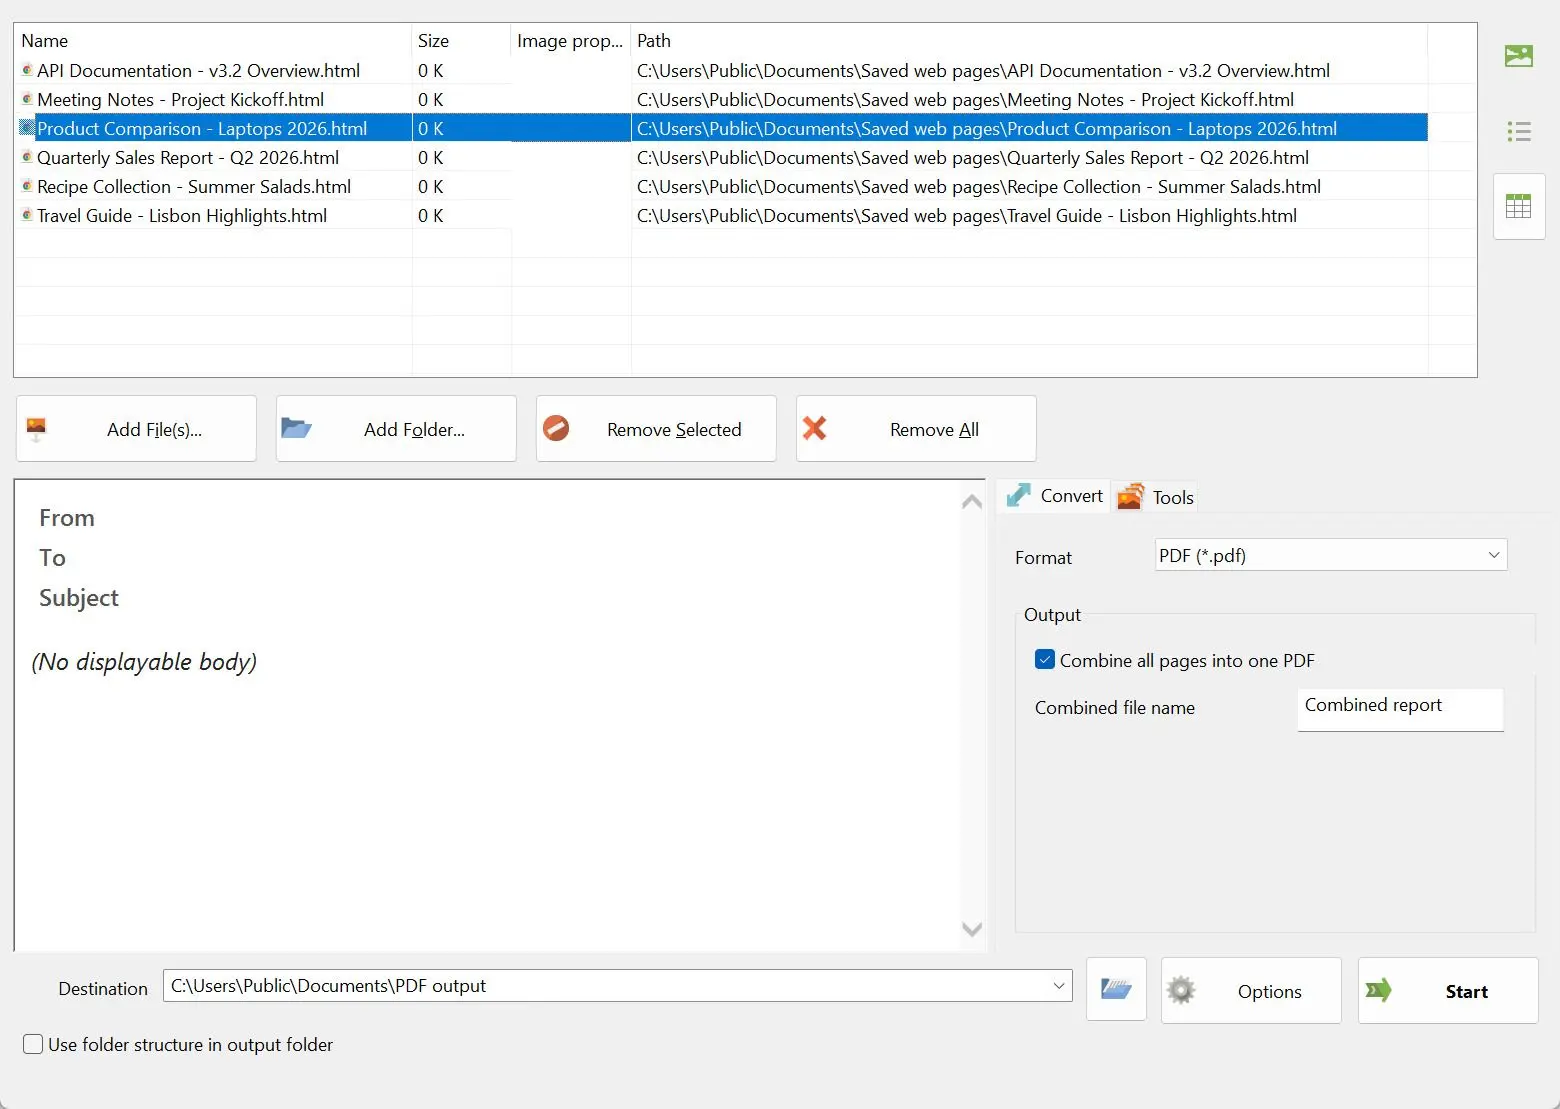
Dodaj folder plików .html, .htm lub .xhtml i naciśnij Start jeden raz. Każda strona wychodzi jako PDF z obrazami i stylami, odczytanymi z folderu zasobów zapisanego obok - albo zaznacz Połącz wszystkie strony w jeden PDF, a cały zestaw stanie się jednym dokumentem.
Drukowanie do PDF wystarcza dla jednej strony. A Ty masz ich dziewięćdziesiąt.
Eksport z helpdesku, statyczna dokumentacja, sezon artykułów zapisanych do projektu badawczego - HTML zwykle przychodzi całymi katalogami, każdy plik z folderem obrazów obok. Przeglądarka zamieni dowolny z nich w PDF, a potem otwierasz następny i robisz to samo od nowa. Konwertery online przyjmują całą paczkę, ale najpierw musisz wysłać pliki, które nigdy nie miały opuścić komputera, a folder z obrazami zwykle zostaje z tyłu.
How to use it
Dodaj zapisane strony
Dodaj pliki albo folder, w którym się znajdują. Pliki .html, .htm i .xhtml trafiają na tę samą listę. Zostaw każdy folder zasobów tam, gdzie został zapisany, obok swojej strony - stamtąd odczytywane są obrazy i arkusze stylów.
Wybierz osobne pliki albo jeden dokument
Bez zmian każda strona staje się osobnym plikiem PDF. Zaznacz Połącz wszystkie strony w jeden PDF, a całość zostanie złączona w jeden plik, w kolejności, w jakiej strony stoją na liście.
Naciśnij Start
Strony są renderowane na Twoim komputerze i zapisywane jako pliki w folderze wyjściowym. Nic nie jest wysyłane do drukarki i nic po drodze nie prosi o połączenie, więc działa tak samo na laptopie z wyłączonym Wi-Fi.
Benefits
Cały zestaw złączony w jeden PDF
Czterdzieści zapisanych stron to czterdzieści załączników i nikt po drugiej stronie nie wie, który otworzyć najpierw. Po zaznaczeniu opcji Połącz wszystkie strony w jeden PDF stają się jednym plikiem, który możesz wysłać, zarchiwizować albo przekazać audytorowi. Łączenie dotyczy wyjścia PDF; to pole wyboru, więc osobne pliki są wciąż o jedno kliknięcie dalej.
Obrazy i style pochodzą z folderu obok strony
Strona zapisana z przeglądarki to tak naprawdę dwie rzeczy: plik .html i folder z obrazami i arkuszami stylów obok niego. Ten folder jest odczytywany podczas konwersji, więc w pliku PDF są zdjęcia i układ, a nie goły tekst wokół pustych ramek. Folder musi tam być - jeśli skopiowano tylko plik .html, nie ma czego czytać.
Każda strona zostaje na Twoim własnym dysku
Konwersja działa przy zamkniętej sieci. Twoje pliki nie są wysyłane, a strona nie może też sama nawiązać połączenia, więc piksel śledzący albo zdalny skrypt w zapisanej stronie nie dostaje odpowiedzi. Dzięki temu program nadaje się do raportów wewnętrznych, faktur i akt klientów, które nie mogą przechodzić przez żadną stronę internetową.
Dlaczego ludzie go używają
Nowoczesne układy zachowują kształt
Silnikiem renderującym jest WebView2, zbudowany na Chromium, więc CSS Grid, Flexbox i zmienne CSS są układane poprawnie, zamiast zapadać się w jedną długą kolumnę. Nie obiecujemy zgodności co do piksela z tym, co pokazuje Chrome, ale strona zbudowana w tej dekadzie nadal wygląda jak ona sama.
Czysty tekst, gdy chcesz tylko słowa
Format wyjściowy można przełączyć z PDF na TXT. To dobry wybór, gdy strony trafiają do indeksu wyszukiwania lub porównania tekstu, a nie do czytania, i układ tylko by przeszkadzał.
Jedna lista dla .html, .htm i .xhtml
Starsze eksporty kończą się na .htm, niektóre narzędzia zapisują .xhtml, przeglądarki zapisują .html. Wszystkie trzy dzielą jedną listę i jeden zestaw ustawień, więc mieszany folder przechodzi za jednym razem.
FAQ
System Requirements
Masowy eksporter stron WWW do PDF
Languages
3.9
18,5 Mb
August 8, 2026
- Windows 11/10/8.1/8/7 (32/64 bit)
- Intel i3, AMD Ryzen 5 or above
- 4 GB of RAM or above
- NVIDIA® GeForce® series 8 and 8M, Intel® HD Graphics 2000, Quadro FX 4800, Quadro FX 5600, AMD Radeon™ R600, Mobility Radeon™ HD 4330, Mobility FirePro™ series, Radeon™ R5 M230 or higher graphics card with up-to-date drivers
- 1280 × 768 screen resolution, 32-bit color
- 1 GB of free hard disk space or above
GRT requirements trial note